
PostgreSQL / 系统课时
WAL 与崩溃恢复
WAL 与崩溃恢复
本课解决一个核心问题:事务已经返回提交成功,但数据页可能还没有写回磁盘,PostgreSQL 为什么仍能在宕机后恢复。你将把 WAL、刷盘、检查点与启动恢复串成一条完整的持久化链路。
学习目标
- 解释 WAL 的写前规则,以及提交成功与数据页落盘之间的区别。
- 说明检查点如何推进恢复起点,并理解检查点频率与恢复成本的关系。
- 使用 WAL 位置与统计视图观察写入活动,判断恢复链路是否符合预期。
WAL 先于数据页持久化
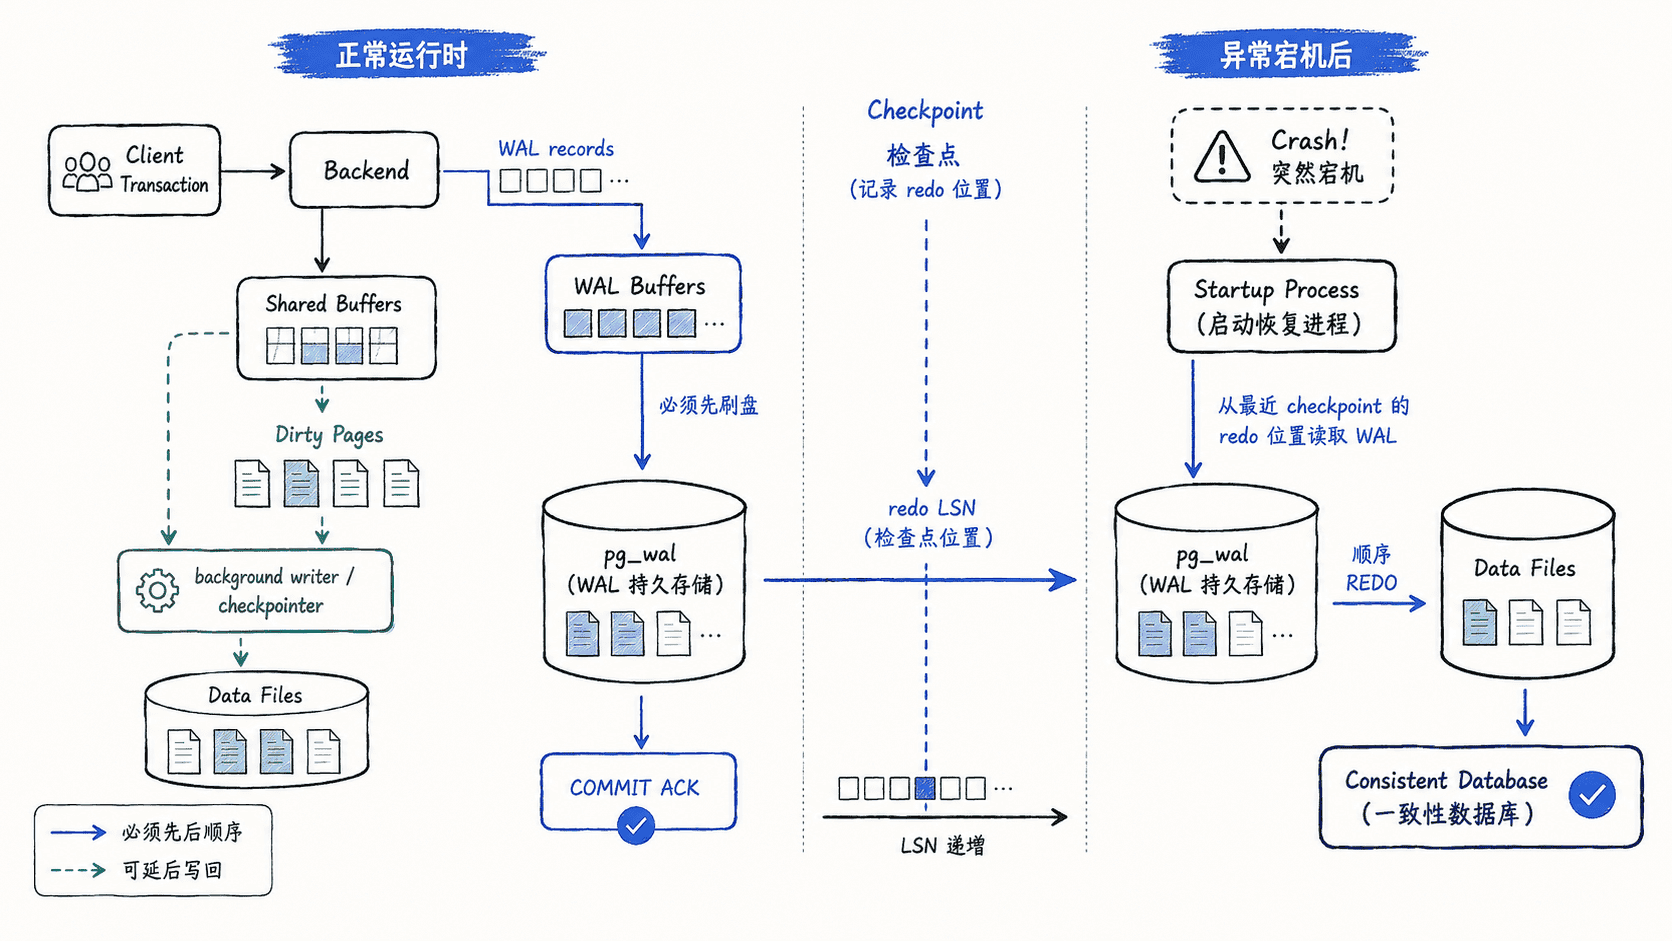
WAL 的关键不是“多写一份日志”,而是强制建立顺序:描述数据变更的 WAL 记录必须先于对应数据页持久化。事务修改表或索引时,页面通常先在共享缓冲区中变脏,同时生成 WAL 记录;数据页可以稍后批量写回。
在常见的 fsync=on、synchronous_commit=on 配置下,提交路径必须确保包含该事务提交记录的 WAL 已刷到持久存储,客户端才得到成功。此时相关数据页仍可能只存在于共享缓冲区,但崩溃后可以依靠 WAL 重做这些尚未落盘的修改。
从修改到提交发生了什么
一次普通写事务可以拆成五个动作。理解这些动作的先后关系,比记住某个参数默认值更重要。
- 后端进程修改共享缓冲区中的页面,使其成为 dirty buffer,并向 WAL buffer 写入描述变化的 WAL record。
- 事务提交时产生提交记录;同步提交要求 WAL 至少持久化到该提交记录对应的位置。
- WAL writer 会周期性写出 WAL,但提交后端在需要时也会主动推动 WAL flush,因此不能把提交持久化简单理解为“等待 WAL writer”。
- 脏数据页之后可由 background writer、checkpointer 或需要腾出缓冲区的后端写出,不要求与事务提交同时发生。
- 检查点确保规定范围内的脏页完成写回与同步,并记录新的恢复基准,使未来崩溃恢复不必从更早的 WAL 开始。
检查点控制恢复起点
检查点的价值不是“把 WAL 清空”,而是建立一个新的可恢复基准。检查点完成后,恢复程序可以依据最新 checkpoint 中的 redo 位置开始重放,而不必扫描整个 WAL 历史;旧 WAL 是否能回收,还会受到归档、复制槽和备库等需求约束。
检查点过于频繁会增加数据页写回压力,并可能因为首次修改页面需要 full-page image 而提高 WAL 量;间隔过长则通常意味着崩溃后需要重放更多 WAL。生产环境应结合写入峰值、存储吞吐与可接受恢复时间评估,而不是只追求更少或更多检查点。
可以在测试实例中制造一批 WAL,并观察 LSN 与累计 WAL 统计。CHECKPOINT 需要具备相应管理权限,示例会创建并删除测试表。
SELECT pg_current_wal_lsn() AS lsn_before,
       wal_records AS wal_records_before,
       wal_bytes::bigint AS wal_bytes_before
FROM pg_stat_wal;

DROP TABLE IF EXISTS wal_demo;
CREATE TABLE wal_demo (
    id bigint PRIMARY KEY,
    payload text NOT NULL
);

INSERT INTO wal_demo
SELECT g, repeat('x', 200)
FROM generate_series(1, 10000) AS g;

CHECKPOINT;

SELECT pg_current_wal_lsn() AS lsn_after,
       wal_records AS wal_records_after,
       wal_bytes::bigint AS wal_bytes_after
FROM pg_stat_wal;

DROP TABLE wal_demo;
预期输出
 lsn_before | wal_records_before | wal_bytes_before
------------+--------------------+-----------------
 <LSN>      | <VALUE>            | <VALUE>

DROP TABLE
CREATE TABLE
INSERT 0 10000
CHECKPOINT

 lsn_after | wal_records_after | wal_bytes_after
-----------+-------------------+----------------
 <LSN>     | <VALUE>           | <VALUE>

DROP TABLE
<LSN> 与 <VALUE> 会随实例活动变化。重点不是绝对数值,而是写入后 LSN 向前推进,wal_records 与 wal_bytes 通常增加;这些指标是集群累计值,因此并发会话也可能贡献变化。
崩溃后如何恢复
实例非正常结束后重新启动,startup process 会进入崩溃恢复。它先定位最近可用 checkpoint 给出的 redo 起点,再按 WAL 顺序重放需要的记录,把“WAL 已持久化、数据页却尚未写回”的修改重新应用到数据文件。
PostgreSQL 的崩溃恢复以 REDO 为主,不需要像某些系统那样再执行一轮物理 UNDO。没有提交记录的事务不会被视为已提交,其残留行版本对正常事务不可见,后续可由清理机制回收。
因此,判断持久化问题时要分清三个边界:提交成功主要证明 WAL 达到所需持久化位置;检查点证明更早的一批数据页已建立新的恢复基准;真正的崩溃恢复则利用 checkpoint 加后续 WAL,把磁盘状态推进到一致状态。