
PostgreSQL / 系统课时
EXPLAIN ANALYZE
EXPLAIN ANALYZE
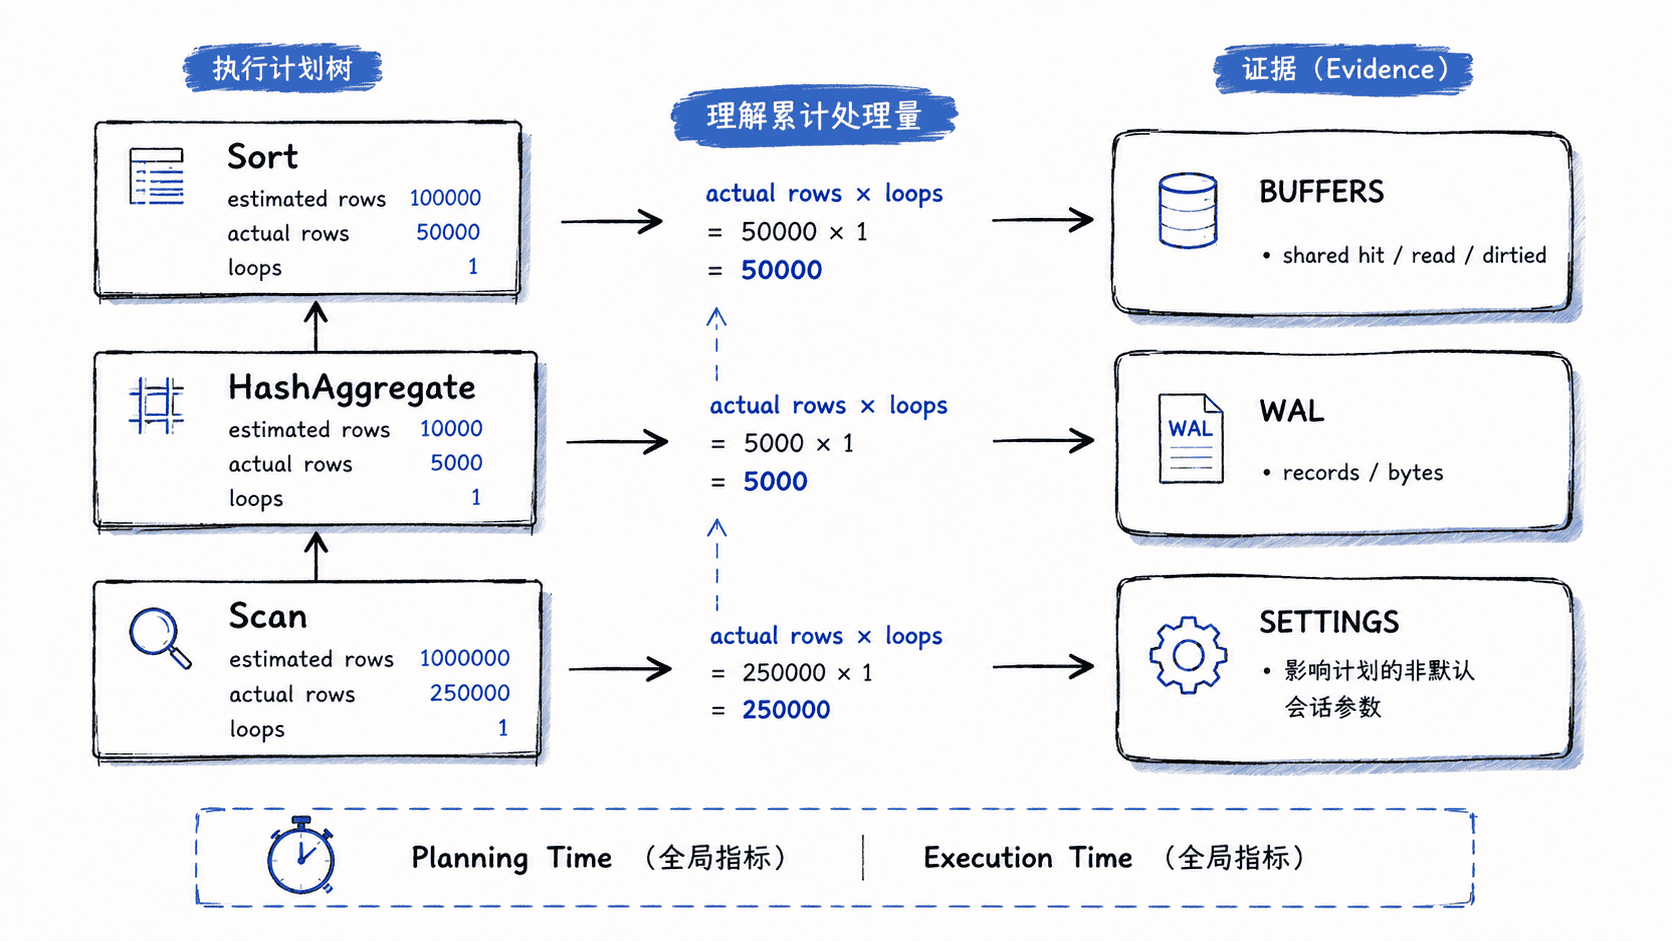
EXPLAIN ANALYZE 不只是查看优化器“打算怎么执行”,而是实际运行 SQL 并把真实行数、循环次数和耗时写回执行计划。本节把 BUFFERS、WAL 与 SETTINGS 一起使用,建立一套能区分估算错误、I/O 压力和写放大的证据链。
学习目标
- 区分 estimated cost 与
actual rows、loops等真实执行指标。 - 使用
BUFFERS判断缓冲区访问特征,而不是只比较总耗时。 - 使用
WAL与SETTINGS识别写入日志量和影响计划的会话参数。
准备一张可分析的表
先创建测试数据和时间索引。数据量足以让扫描、聚合和索引选择在执行计划中具有观察价值。
DROP TABLE IF EXISTS explain_demo;

CREATE TABLE explain_demo (
    id bigint GENERATED ALWAYS AS IDENTITY PRIMARY KEY,
    region text NOT NULL,
    created_at timestamptz NOT NULL,
    amount numeric(12,2) NOT NULL
);

INSERT INTO explain_demo (region, created_at, amount)
SELECT
    CASE g % 4
        WHEN 0 THEN 'east'
        WHEN 1 THEN 'west'
        WHEN 2 THEN 'north'
        ELSE 'south'
    END,
    now() - (g % 180) * interval '1 day',
    ((g % 10000) + 100)::numeric / 100
FROM generate_series(1, 300000) AS g;

CREATE INDEX idx_explain_demo_created_at
    ON explain_demo (created_at);

VACUUM (ANALYZE) explain_demo;
预期输出
DROP TABLE
CREATE TABLE
INSERT 0 300000
CREATE INDEX
VACUUM
实际耗时与缓存状态因环境而异。
先读真实行数和循环次数
EXPLAIN 只生成计划,EXPLAIN ANALYZE 会真正执行查询。每个节点计划部分的 rows 是优化器估算值,而 actual rows 是每次循环实际输出的平均行数,因此处理规模要结合 actual rows 与 loops 阅读。
EXPLAIN (ANALYZE, BUFFERS, TIMING OFF)
SELECT region, count(*) AS order_count, sum(amount) AS total_amount
FROM explain_demo
WHERE created_at >= now() - interval '30 days'
GROUP BY region
ORDER BY order_count DESC;
预期结果
Sort  (cost=<VALUE>..<VALUE> rows=<VALUE>) (actual rows=4 loops=1)
  Sort Key: (count(*)) DESC
  Buffers: shared hit=<VALUE> read=<VALUE>
  ->  HashAggregate  (cost=<VALUE>..<VALUE> rows=<VALUE>) (actual rows=4 loops=1)
        Buffers: shared hit=<VALUE> read=<VALUE>
        ->  <SCAN NODE> on explain_demo
              Buffers: shared hit=<VALUE> read=<VALUE>
Planning Time: <VALUE> ms
Execution Time: <VALUE> ms
<SCAN NODE> 可能是 Index Scan、Bitmap Heap Scan 或 Seq Scan,具体取决于数据分布、统计信息和成本参数。TIMING OFF 关闭逐节点计时开销,但仍保留真实行数和总执行时间,适合只关心执行规模的排查。
用 BUFFERS 判断访问代价
BUFFERS 会在相关节点上报告缓冲区访问。shared hit 表示请求的数据块已经位于 PostgreSQL shared buffers,shared read 表示执行期间需要把块读入缓冲区;它不等同于一定发生了物理磁盘读取,因为操作系统自身也可能缓存文件数据。写操作还可能出现 dirtied 和 written。
同一条 SQL 连续执行两次时,第二次往往有更多 hit、更少 read,但这并不代表执行路径本身更优。比较两个方案时,应同时记录数据规模、缓存条件和计划节点,不能只比一次 Execution Time。
用 WAL 和 SETTINGS 观察写操作
WAL 对普通只读查询通常没有需要分析的写日志,因此更适合配合 INSERT、UPDATE 或 DELETE。下面把更新放进事务并最终回滚,既获得真实执行证据,又不永久修改测试数据。
BEGIN;

SET LOCAL random_page_cost = 1.1;

EXPLAIN (ANALYZE, BUFFERS, WAL, SETTINGS, TIMING OFF)
UPDATE explain_demo
SET amount = amount + 1
WHERE id BETWEEN 1 AND 100;

ROLLBACK;
预期结果
BEGIN
SET
Update on explain_demo  (cost=<VALUE>..<VALUE>) (actual rows=0 loops=1)
  Buffers: shared hit=<VALUE> read=<VALUE> dirtied=<VALUE>
  WAL: records=<VALUE> bytes=<VALUE>
  ->  Index Scan using explain_demo_pkey on explain_demo
        Index Cond: ((id >= 1) AND (id <= 100))
        actual rows=100 loops=1
Settings: random_page_cost = '1.1'
Planning Time: <VALUE> ms
Execution Time: <VALUE> ms
ROLLBACK
WAL 记录数和字节数会随 PostgreSQL 版本、页状态以及 full-page image 条件变化,因此应在同一环境下比较相对差异。SETTINGS 用来留下会影响规划的非默认参数;这能避免把参数环境不同的两个计划误当成可直接比较的结果。
按固定顺序建立证据链
先比较估算 rows 与 actual rows,偏差大时优先检查统计信息、数据倾斜和条件相关性;估算合理但执行代价高,再看 BUFFERS 判断扫描了多少数据块;涉及写入时继续看 WAL,确认是否存在异常写放大;最后核对 SETTINGS,排除成本参数或会话配置差异。
执行计划不是一张“越短越好”的清单,而是一组可验证的运行证据。只有把真实行数、循环次数、缓冲区、WAL 和配置上下文放在一起,才能判断问题究竟来自估算、访问路径、I/O,还是写入成本。