
PostgreSQL / 系统课时
后台进程职责
后台进程职责
本课把 PostgreSQL 中最容易混淆的后台职责拆开:谁负责检查点,谁提前清理脏缓冲区,谁写 WAL,谁触发自动清理。掌握这些边界后,看到 I/O 峰值、WAL 压力或表膨胀时才能找到正确的观察对象。
学习目标
- 区分 checkpointer、background writer、WAL writer 与 autovacuum 的职责边界。
- 理解这些进程如何围绕共享缓冲区、WAL 与表维护协作,而不是互相替代。
- 通过
pg_stat_activity与统计视图确认后台进程是否存在并观察其工作量。
先建立进程图谱
PostgreSQL 不是由一个服务器进程包办所有工作。客户端通常由独立 backend process 服务,实例内部还有多种辅助进程负责持久化、缓冲区清理、日志归档、恢复、复制和维护。它们共享部分内存与状态,但触发条件和完成标准并不相同。
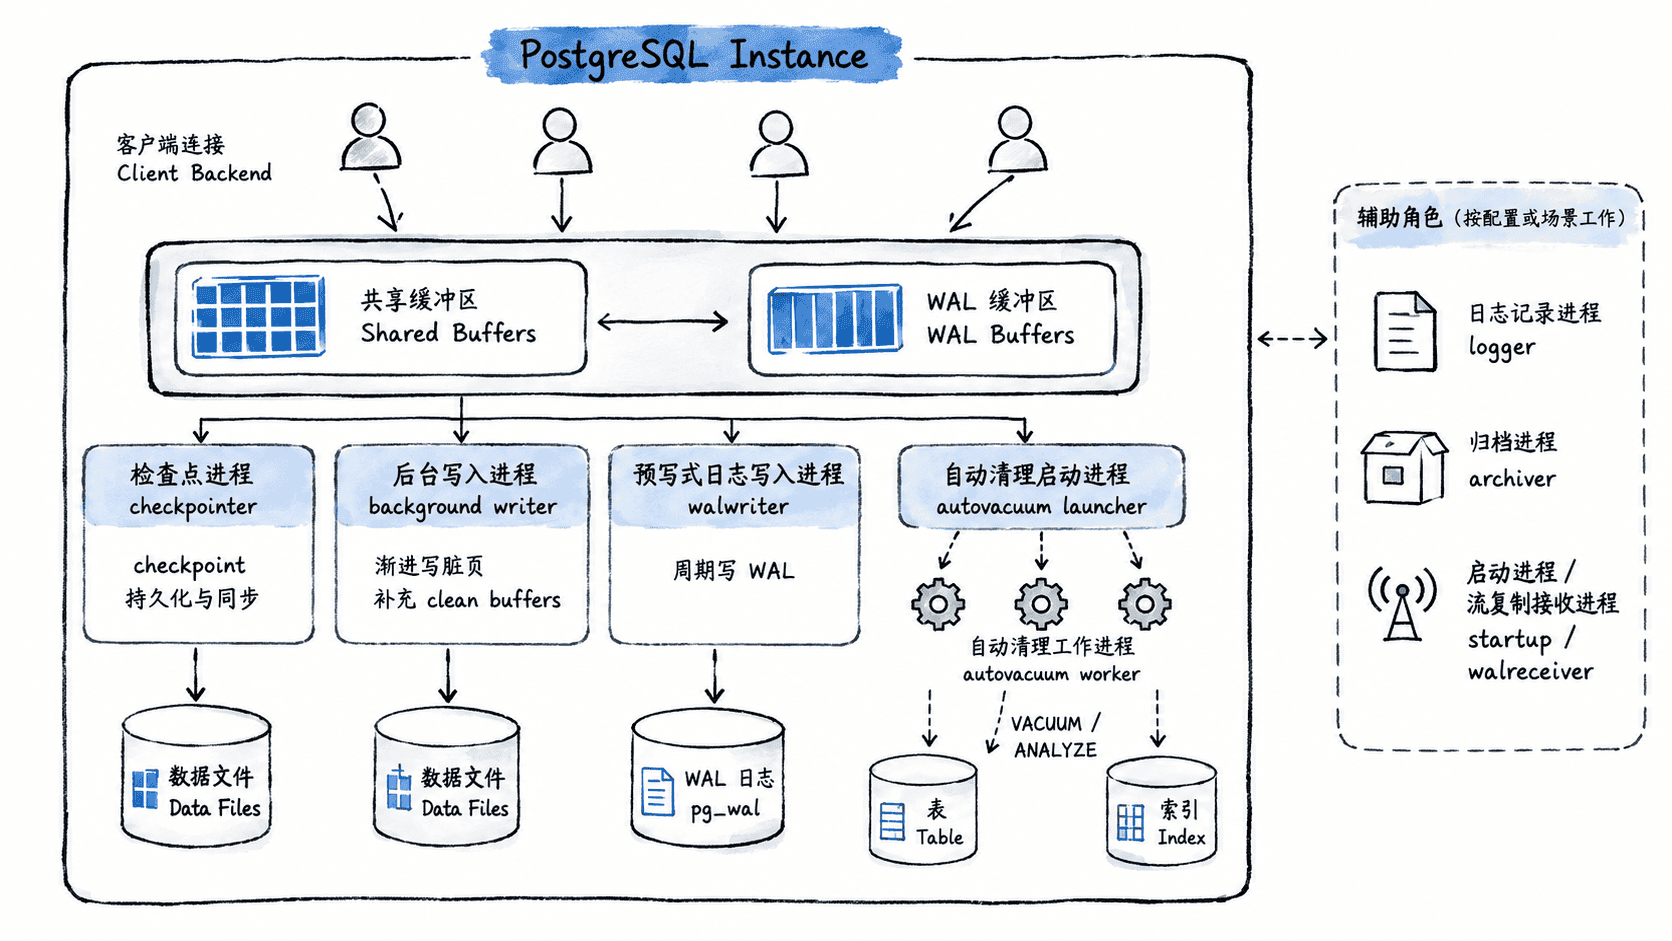
四类核心职责不要混用
| 进程 | 主要对象 | 核心职责 | 不应误解为 |
|---|---|---|---|
| checkpointer | dirty buffers、数据文件 | 执行 checkpoint,将检查点范围内的脏页写出并完成所需同步,推进恢复基准 | 日常持续清理所有脏页 |
| background writer | shared buffers | 周期性写出一部分脏缓冲区,增加可直接复用的 clean buffers,减少客户端被迫写脏页的概率 | 事务提交持久化的最终保证 |
| walwriter | WAL buffers、pg_wal |
周期性写出 WAL,尤其帮助异步提交和后台 WAL 写出 | 所有同步提交都只能等它刷盘 |
| autovacuum launcher / worker | 表、索引、统计信息 | launcher 调度 worker;worker 根据阈值执行 VACUUM、ANALYZE 等维护 |
launcher 自己扫描并 vacuum 每张表 |
checkpointer 与 background writer 都会写数据页,但目标不同:前者要完成一个具有恢复语义的 checkpoint,后者主要平滑缓冲区压力。WAL writer 处理的是 WAL 路径,而不是 heap/index 数据页;autovacuum 又属于 MVCC 清理与统计维护路径。
观察后台进程是否在工作
pg_stat_activity.backend_type 可以直接看到多类服务器进程。下面的查询同时查看核心后台进程、background writer 统计以及 WAL 统计;pg_stat_checkpointer 适用于 PostgreSQL 17 及以上版本,较早版本的检查点统计位于 pg_stat_bgwriter 中。
SELECT pid,
       backend_type,
       wait_event_type,
       wait_event
FROM pg_stat_activity
WHERE backend_type IN (
    'checkpointer',
    'background writer',
    'walwriter',
    'autovacuum launcher',
    'autovacuum worker'
)
ORDER BY backend_type, pid;

SELECT buffers_clean,
       maxwritten_clean,
       buffers_alloc
FROM pg_stat_bgwriter;

SELECT num_timed,
       num_requested,
       buffers_written
FROM pg_stat_checkpointer;

SELECT wal_records,
       wal_fpi,
       wal_bytes::bigint AS wal_bytes
FROM pg_stat_wal;
预期输出
  pid  |    backend_type     | wait_event_type |     wait_event
-------+---------------------+-----------------+---------------------
 <PID> | autovacuum launcher | <TYPE>          | <WAIT_EVENT>
 <PID> | background writer   | <TYPE>          | <WAIT_EVENT>
 <PID> | checkpointer        | <TYPE>          | <WAIT_EVENT>
 <PID> | walwriter           | <TYPE>          | <WAIT_EVENT>
...

 buffers_clean | maxwritten_clean | buffers_alloc
---------------+------------------+--------------
 <VALUE>       | <VALUE>          | <VALUE>

 num_timed | num_requested | buffers_written
-----------+---------------+----------------
 <VALUE>   | <VALUE>       | <VALUE>

 wal_records | wal_fpi | wal_bytes
-------------+---------+----------
<VALUE> | <VALUE> | <VALUE><PID>、<TYPE>、<WAIT_EVENT> 与 <VALUE> 会因实例运行状态和负载不同而变化。没有正在工作的 autovacuum worker 并不代表 autovacuum 失效,因为 worker 是按需启动的;launcher 通常长期存在,而 worker 只在有维护任务时出现。
从指标反推问题归属
如果 buffers_clean 持续增加,说明 background writer 正在提前清理缓冲区;若业务后端仍频繁承担大量关系写入,应进一步结合 pg_stat_io 判断是否存在缓冲区或检查点压力。checkpoint 写盘量和耗时则应优先归到 checkpointer,而不是 WAL writer。
WAL 增长过快时,应先看业务写入模式、full-page image、逻辑复制或其他 WAL 来源,再看 WAL 写出路径;表膨胀、dead tuples 和统计信息陈旧,则应转向 autovacuum 阈值、worker 并发、长事务与锁冲突,而不是调整 checkpoint 参数。
进程之间如何协作
一次写事务可能先由 client backend 产生 WAL 并弄脏共享缓冲区;WAL writer 周期性处理 WAL buffer,background writer 在后台逐步腾出干净缓冲区,checkpointer 在 checkpoint 时建立新的持久化基准。与此同时,autovacuum worker 独立处理旧行版本和统计信息。
这几个进程都可能产生 I/O,却解决不同问题。排障时最有效的做法不是看到磁盘繁忙就统一“调低后台任务”,而是先确认 I/O 来自 WAL、checkpoint、buffer cleaning 还是 vacuum,再针对对应进程的触发条件、积压量和统计指标处理。