
PostgreSQL / 系统课时
进程模型与连接生命周期
进程模型与连接生命周期
PostgreSQL 不是用一个线程处理所有客户端,而是由主服务进程负责监听与派生,每个已建立的客户端连接通常对应一个独立后端进程。理解这条生命周期,可以直接解释连接数、进程数、会话状态与连接池之间的关系。
学习目标
- 说清主服务进程、后端进程与客户端连接各自承担的职责。
- 理解从 TCP 建连、认证到 SQL 执行和会话结束的完整生命周期。
- 能使用系统视图定位当前连接对应的后端进程和会话状态。
主服务进程与后端进程如何分工
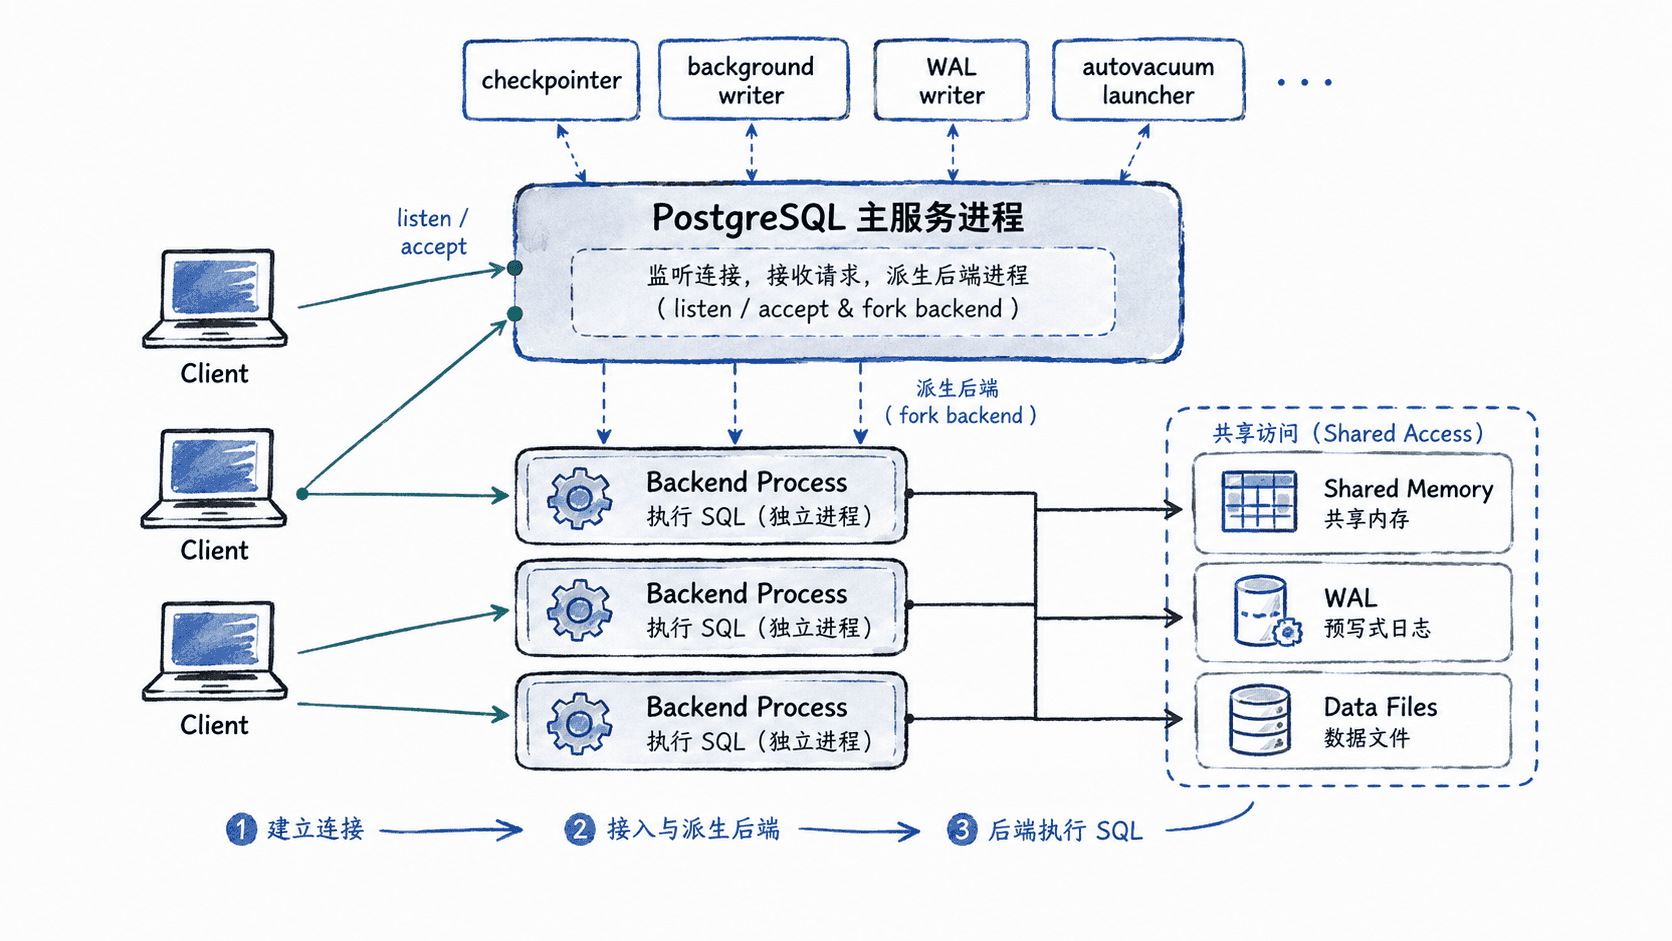
PostgreSQL 实例启动后,会有一个主服务进程负责监听端口、接受新连接,并协调 checkpointer、background writer、WAL writer、autovacuum launcher 等后台进程。它本身不替普通客户端执行 SQL。
客户端连接被接受后,服务器为该连接建立一个独立后端进程。这个后端进程保存当前会话的认证身份、事务状态、临时对象、会话级参数和执行上下文,并在该连接存活期间持续处理客户端发来的 SQL。
这意味着“一个连接”在服务器端不是一个轻量逻辑标签,而通常会占用一个真实进程以及对应内存。连接数很高时,进程切换、每会话内存和锁管理开销都会累积,因此 PostgreSQL 常通过连接池把大量短请求复用到较少的数据库连接上。
一次连接从建立到结束经历什么
连接生命周期可以按实际事件顺序理解:
- 客户端向 PostgreSQL 监听地址和端口发起 TCP 连接。
- 主服务进程接受连接,并创建或安排一个后端进程处理该客户端。
- 后端进程执行 SSL 协商、启动参数处理与身份认证。
- 认证成功后进入会话阶段,客户端可以重复发送 SQL;事务状态、临时表和会话参数都属于这个会话。
- 客户端主动断开、网络中断、后端被终止或服务器关闭时,会话结束,后端进程清理资源并退出。
用系统视图观察当前后端
在任意 psql 会话中执行下面的查询,可以同时拿到当前连接的后端 PID、数据库、用户和会话状态。
SELECT
    pg_backend_pid() AS backend_pid,
    current_database() AS database_name,
    current_user AS user_name,
    state,
    backend_type
FROM pg_stat_activity
WHERE pid = pg_backend_pid();
预期结果
 backend_pid | database_name | user_name | state  |  backend_type
-------------+---------------+-----------+--------+----------------
 <PID>       | <VALUE>       | <VALUE>   | active | client backend
<PID> 和数据库、用户名称会随环境变化。执行查询期间通常可看到 state = active;查询结束后再次从其他会话观察该连接时,它可能变为 idle 或 idle in transaction。
还可以用操作系统命令核对 PostgreSQL 进程。下面以 Linux 为例:
ps -ef | grep '[p]ostgres'预期输出
postgres  <PID>  ... postgres ...
postgres  <PID>  ... postgres: checkpointer
postgres  <PID>  ... postgres: background writer
postgres  <PID>  ... postgres: walwriter
postgres  <PID>  ... postgres: <VALUE> <VALUE> <IP>(<PORT>) idle
进程名称和字段格式会因系统、版本与启动方式略有差异,但通常可以看到后台进程以及一个或多个 client backend。
连接池解决的是什么问题
PostgreSQL 的每连接一后端模型简单、隔离清晰,但不适合无限增加客户端连接。应用如果为每个 HTTP 请求都新建数据库连接,就会反复承担网络握手、认证、进程与会话资源分配成本。
连接池的作用是让应用侧的大量短请求复用少量长期数据库连接。真正需要关注的是池大小与数据库 max_connections、工作负载并发度和单会话内存之间的关系,而不是单纯把最大连接数调高。
判断连接压力时,先看 pg_stat_activity 中连接总数、active 数量和长时间 idle in transaction 会话,再决定是优化应用连接释放、引入连接池,还是调整数据库连接上限。这样才能把“客户端请求很多”和“数据库必须保持同样多后端进程”分开处理。