
PostgreSQL / 系统课时
I/O 与等待事件
I/O 与等待事件
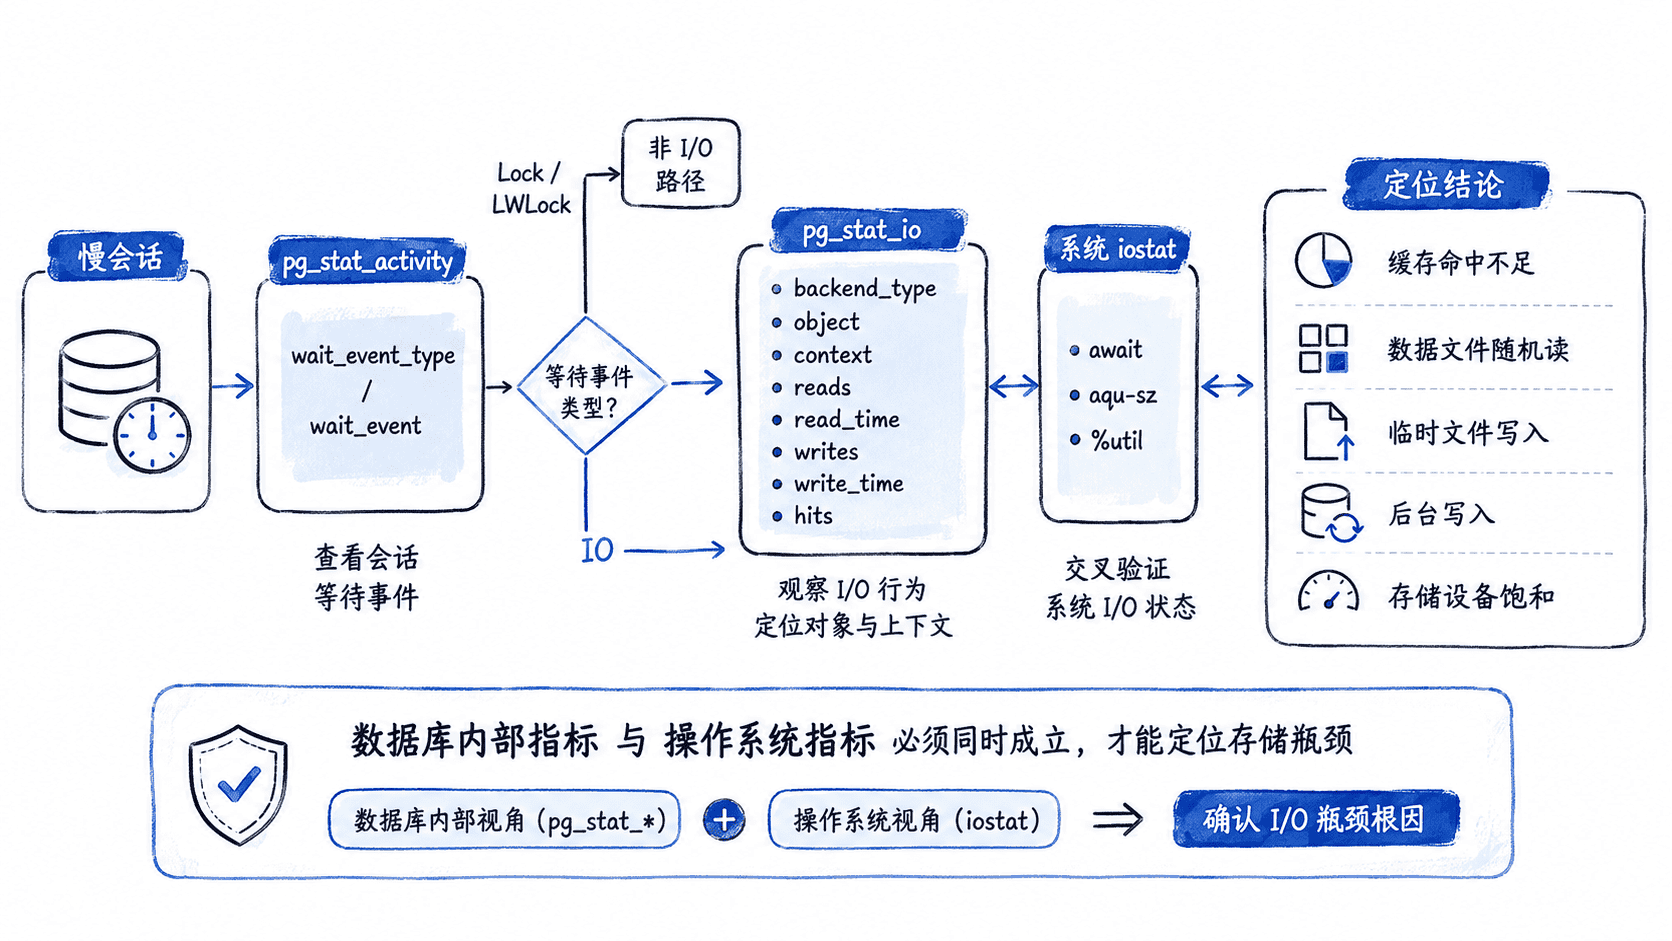
数据库变慢时,先判断会话“在等什么”,再确认 I/O 是缓存命中不足、数据文件读写、临时文件还是检查点压力。本节把等待事件、pg_stat_io 与系统磁盘指标串成一条可复用的定位路径。
学习目标
- 用
pg_stat_activity识别正在等待 I/O 的会话及等待类型。 - 用
pg_stat_io判断读写、缓存命中与后端类型上的 I/O 压力来源。 - 将数据库内部统计与
iostat的延迟、队列和利用率交叉验证。
先从等待事件判断“卡在哪里”
pg_stat_activity 的 wait_event_type 与 wait_event 描述会话当前等待点。重点先看 IO、Lock、LWLock 等类型:只有确认大量慢会话确实在等 I/O,才值得继续向磁盘方向深挖,避免把锁等待误判为存储问题。
SELECT pid,
       usename,
       state,
       wait_event_type,
       wait_event,
       clock_timestamp() - query_start AS running_for,
       left(query, 100) AS query
FROM pg_stat_activity
WHERE pid <> pg_backend_pid()
  AND state <> 'idle'
ORDER BY running_for DESC;
预期结果
 pid  | usename | state  | wait_event_type | wait_event   | running_for | query
<ID>  | app     | active | IO              | DataFileRead | <TIME>      | SELECT ...
实际 PID、持续时间和等待事件会随现场变化。若主要等待类型是 Lock,应转向阻塞链排查;若多条慢 SQL 同时出现 IO,再看 I/O 统计更有意义。
用 pg_stat_io 判断 I/O 来自哪里
PostgreSQL 16 起可通过 pg_stat_io 按后端类型、对象和 I/O 上下文观察读写行为。若要分析 read_time、write_time,应开启 track_io_timing;否则次数有值但耗时可能为 0。
SHOW track_io_timing;

SELECT backend_type,
       object,
       context,
       reads,
       round(read_time::numeric, 1) AS read_ms,
       writes,
       round(write_time::numeric, 1) AS write_ms,
       hits
FROM pg_stat_io
WHERE reads > 0 OR writes > 0
ORDER BY read_time + write_time DESC NULLS LAST
LIMIT 10;
预期结果
 track_io_timing
-----------------
 on

 backend_type   | object   | context | reads   | read_ms | writes  | write_ms | hits
client backend | relation | normal | <VALUE> | <VALUE> | <VALUE> | <VALUE> | <VALUE>看指标时不要只盯“读了多少次”。reads 高而 hits 低,常见于工作集超出缓存或访问模式离散;write_time 高则要结合检查点、后台写入和存储延迟判断。统计是累计值,比较前后窗口时应记录采样时间或在受控实验中重置统计。
用系统指标确认磁盘是否真的饱和
数据库统计只能说明 PostgreSQL 发生了 I/O,不能证明设备已经成为瓶颈。Linux 上可用 iostat 检查设备延迟、平均队列和利用率,优先关注与 PostgreSQL 数据盘对应的设备。
iostat -x 1 3预期输出
Device   r/s     w/s     await   aqu-sz   %util
<DEVICE> <VALUE> <VALUE> <VALUE> <VALUE>  <VALUE>
实际设备名和数值会不同。若 PostgreSQL 会话大量等待 DataFileRead,同时 pg_stat_io.read_time 上升,且设备 await、队列或 %util 持续偏高,才形成较强的“存储受限”证据链。反之,如果磁盘指标正常,应继续检查锁、CPU、执行计划和客户端消费速度。
常见判断边界
ClientRead 或 ClientWrite 表示后端在等客户端通信,不等于磁盘 I/O;IO 也不总是硬盘损坏,可能只是缓存未命中后的正常读取。排查时以“等待事件定位方向、pg_stat_io 量化数据库行为、系统指标验证设备压力”三层证据相互印证,能显著减少误判。