
PostgreSQL / 系统课时
故障切换与脑裂防护
故障切换与脑裂防护
高可用真正难的不是“把备用库升成主库”,而是在主库失联时判断是否该切换、保证旧主不能继续写入,并让故障节点安全回归。本节走完健康判定、隔离旧主、提升新主、切换流量和旧主重新加入的完整流程。
学习目标
- 设计不依赖单一探针的 PostgreSQL 健康判定条件
- 理解选主与 fencing 如何共同阻止双主写入
- 完成故障切换后的旧主回收与重新加入
先把“故障”判定清楚
TCP 能连通只说明进程可能活着,不能证明数据库还能安全承担主库写入。生产判定至少要同时观察连接、SQL 响应、角色状态和复制新鲜度,并对短暂抖动设置连续失败阈值。
下面的检查适合分别在候选主库与备用库执行:
SELECT
    pg_is_in_recovery() AS in_recovery,
    current_setting('transaction_read_only') AS transaction_read_only;
预期输出:主库应为 false/off,物理备用库通常为 true/on。
 in_recovery | transaction_read_only
-------------+-----------------------
 f           | off
(1 row)
还要在当前主库确认备用节点是否持续接收并回放 WAL:
SELECT
    application_name,
    state,
    sync_state,
    pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn)::bigint AS byte_lag
FROM pg_stat_replication;
预期输出:正常流复制的 state 通常为 streaming,延迟值会随负载变化。
 application_name |   state   | sync_state | byte_lag
------------------+-----------+------------+----------
 standby-1        | streaming | async      | <VALUE>
(1 row)选主之前先隔离旧主
PostgreSQL 自身不会替多节点集群完成分布式仲裁,也不会自动执行 fencing。可靠的自动切换通常需要外部高可用控制器结合一致性存储或法定票数,保证同一时刻只有一个节点获得“可提升”资格。
故障切换的关键顺序不是“先 promote 再处理旧主”,而是先证明旧主已经无法继续接收写流量,再提升候选节点。隔离手段可以是关闭数据库服务、撤销负载均衡入口、阻断数据库网络,或通过云平台、电源管理执行 STONITH。
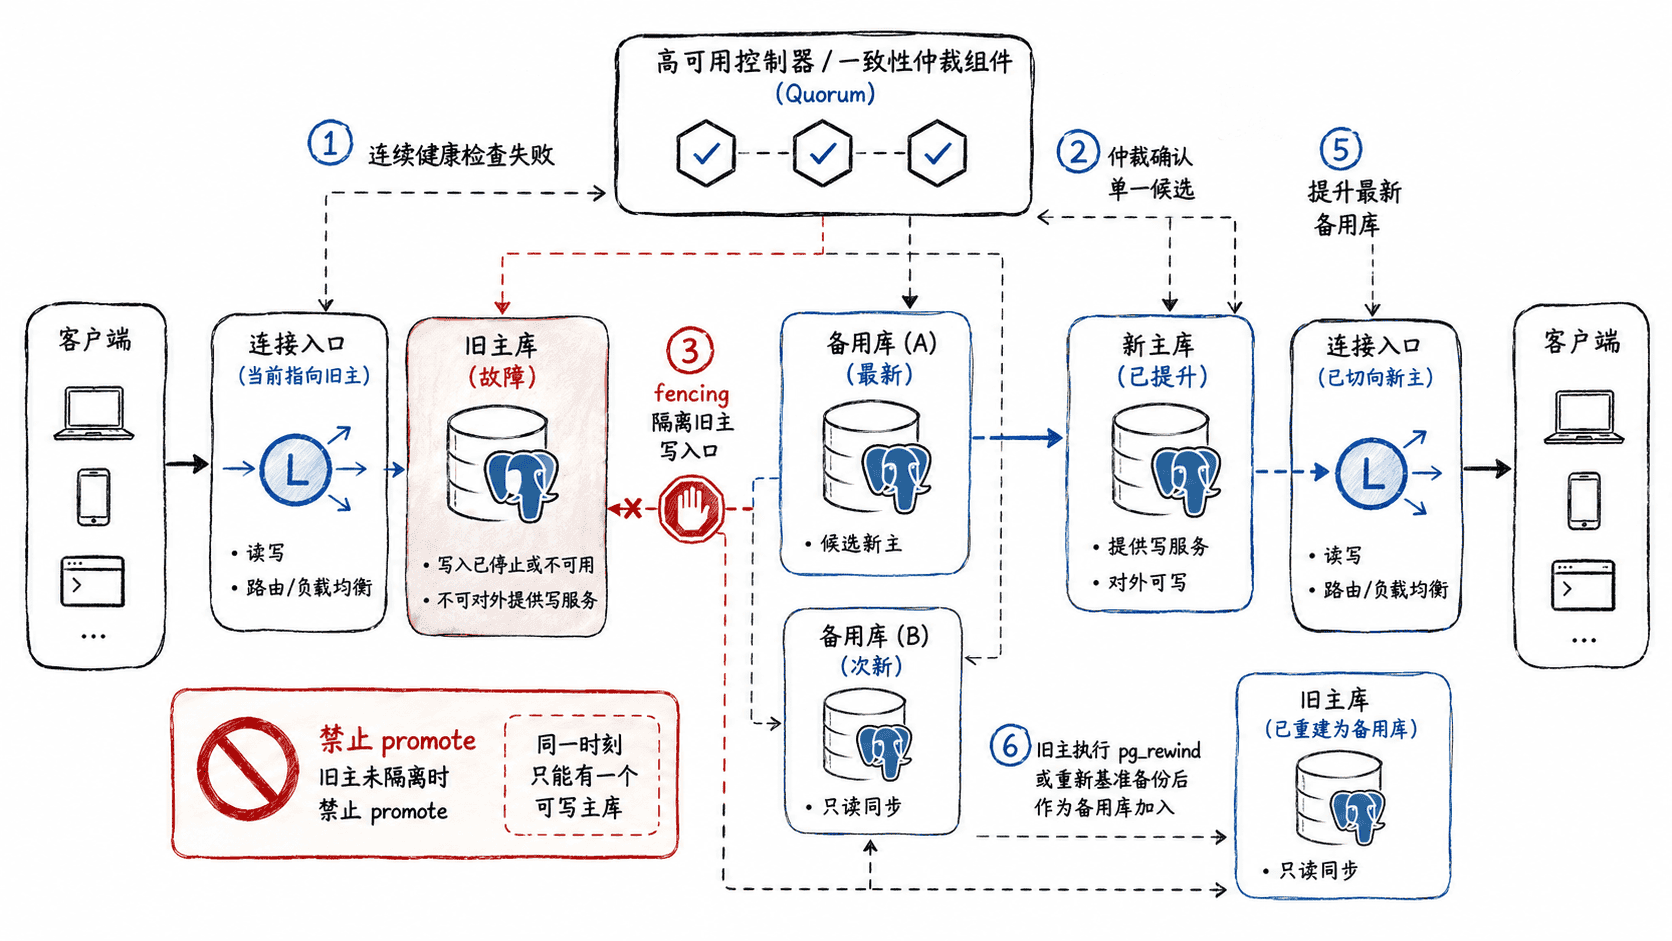
如果决定手工演练,可以先在旧主完成隔离,再在候选备用库执行提升:
sudo systemctl stop postgresql预期输出:命令成功时通常没有标准输出;随后旧主上的连接检查应失败。
<no output>SELECT pg_promote(wait => true, wait_seconds => 60);预期输出:
 pg_promote
------------
 t
(1 row)
提升后再次执行 SELECT pg_is_in_recovery();,结果应为 false,再把代理、VIP 或连接池的写流量指向新主。
脑裂防护要同时控制写权限和路由
只改变 DNS 或负载均衡并不能真正消除脑裂,因为已经建立的连接可能继续写旧主。安全设计应把“谁能写”与“客户端连到谁”分开控制:fencing 负责让旧主失去写能力,路由切换负责把新连接送到新主。
如果采用同步复制,还要提前设计故障时是否允许降级为异步。坚持同步可以降低数据丢失风险,但可能牺牲可用性;允许降级可以更快恢复写入,却必须接受最近事务可能尚未到达候选节点。这个取舍应由高可用策略明确决定,而不是在事故现场临时选择。
让旧主安全重新加入
旧主恢复网络后不能直接启动并继续作为主库工作。若它在故障期间产生过独立 WAL 时间线,必须先把数据目录校正到新主时间线。
满足数据校验和开启,或此前设置过 wal_log_hints=on 等前提时,可以使用 pg_rewind。以下命令在已停止的旧主节点执行:
pg_rewind \
  --target-pgdata=<PATH> \
  --source-server="host=<IP> port=<PORT> user=rewind_user dbname=postgres" \
  --progress
预期输出:成功时会显示扫描、复制并完成 rewind 的阶段信息,具体字节数和时间会不同。
servers diverged at WAL location <VALUE> on timeline <VALUE>
rewinding from last common checkpoint at <VALUE> on timeline <VALUE>
Done!
完成后重新配置该节点跟随新主,再以备用库身份启动。如果 pg_rewind 的前提不满足、WAL 已不足或数据目录状态不可信,直接从新主重新做基准备份通常更安全。
故障切换的核心约束可以压缩成一句话:只有在旧主确定失去写能力后,才允许唯一候选节点成为新主;任何恢复节点都必须先校正到新主时间线,再重新加入。