
PostgreSQL / 系统课时
分区连接与聚合
分区连接与聚合
分区并不会自动让连接和聚合更快。本课用两张按月份对齐的分区表验证 PostgreSQL 的分区级 Join 与 Aggregate,并重点判断:什么时候能减少全局工作,什么时候反而会因为更多计划节点放大 work_mem、规划 CPU 与内存成本。
学习目标
- 判断分区级连接生效所需的分区键与子分区对齐条件
- 用执行计划验证分区级聚合是否真的下推到各分区
- 评估更多 Hash、Sort、Aggregate 节点带来的内存放大风险
收益来自把全局工作拆成局部工作
分区级连接的核心不是“表已经分区”,而是两侧能够按对应分区分别完成连接。连接条件需要包含全部分区键,分区键类型一致,并且两侧子分区能够一一对应。满足条件后,原本跨整张逻辑表的 Join 可以拆成多个分区内 Join,再由上层合并结果。
分区级聚合类似:如果 GROUP BY 包含分区键,聚合可以在各分区内完整完成;如果没有包含分区键,通常只能先做分区内部分聚合,再在更高层完成最终合并。enable_partitionwise_join 与 enable_partitionwise_aggregate 默认都为 off,因为它们会显著增加规划工作,且受 work_mem 限制的执行节点数量可能随扫描分区数线性增长。:contentReference[oaicite:0]{index=0}
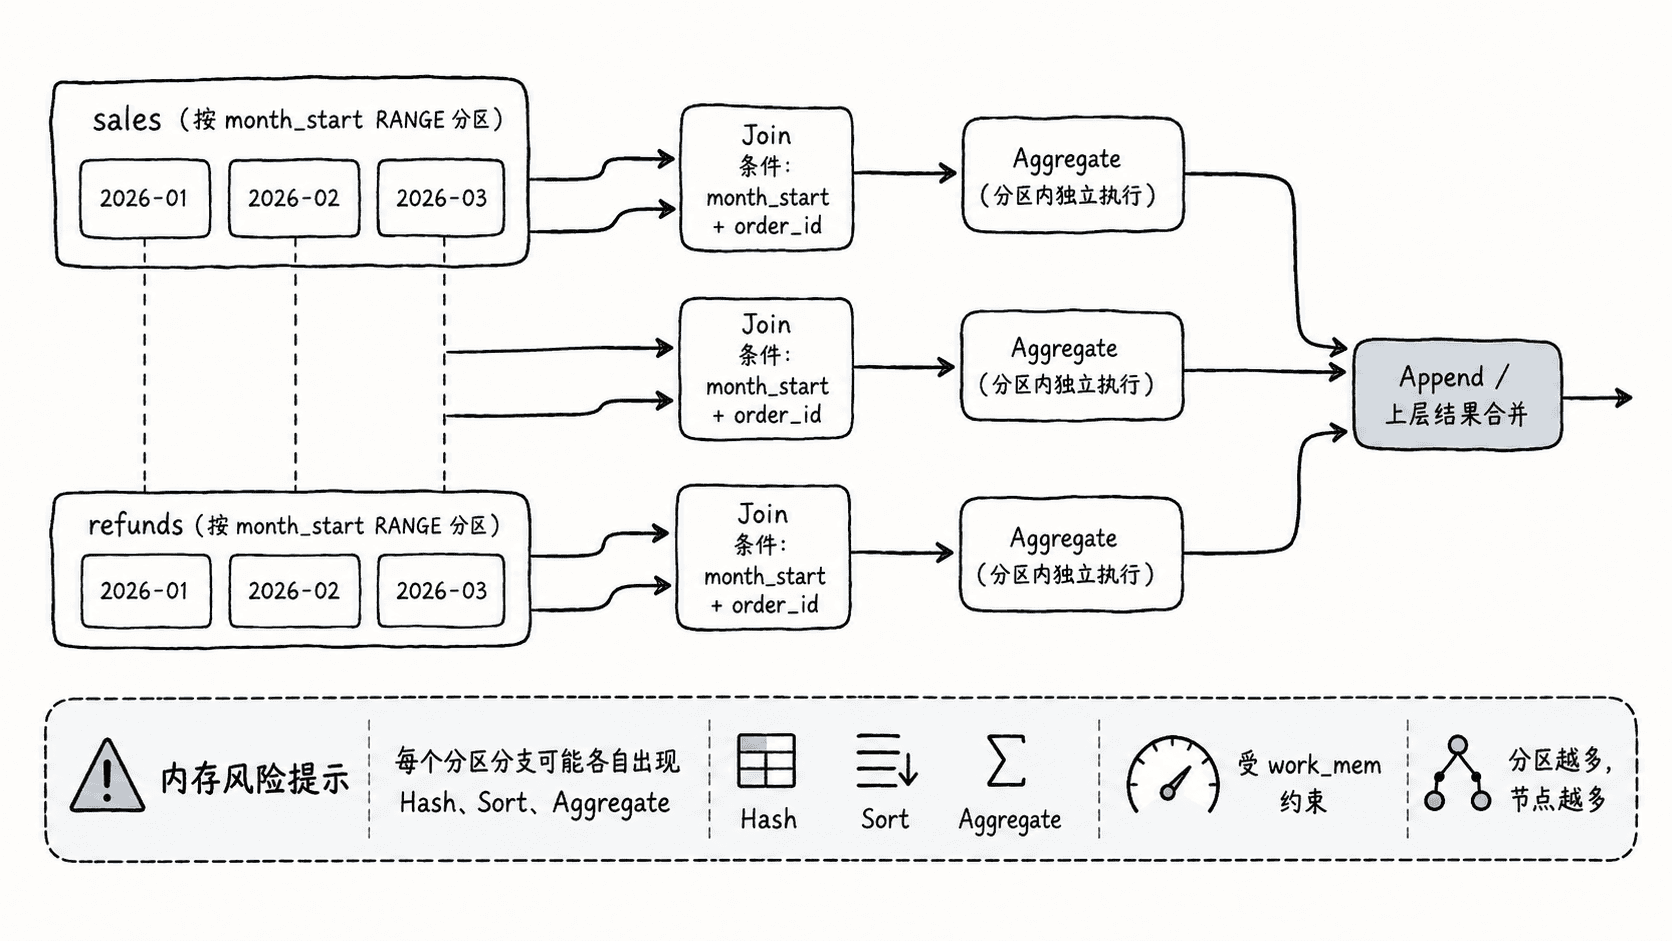
这类优化最适合“按时间或租户做完全一致分区,查询也按同一键连接和分组”的场景。如果两边分区边界不同,或者 Join 没有包含完整分区键,就不要预期 PostgreSQL 能把整个连接机械地拆成对应子任务。
用对齐月分区验证执行计划
下面建立两张边界完全一致的月分区表。示例显式开启两个规划选项,并把 work_mem 保持在较小值,便于把“计划是否拆分”和“每个节点的内存预算”作为两个独立问题观察。
DROP TABLE IF EXISTS refunds CASCADE;
DROP TABLE IF EXISTS sales CASCADE;

CREATE TABLE sales (
    month_start date NOT NULL,
    order_id bigint NOT NULL,
    amount numeric(12,2) NOT NULL
) PARTITION BY RANGE (month_start);

CREATE TABLE refunds (
    month_start date NOT NULL,
    order_id bigint NOT NULL,
    amount numeric(12,2) NOT NULL
) PARTITION BY RANGE (month_start);

CREATE TABLE sales_2026_01 PARTITION OF sales
FOR VALUES FROM ('2026-01-01') TO ('2026-02-01');
CREATE TABLE sales_2026_02 PARTITION OF sales
FOR VALUES FROM ('2026-02-01') TO ('2026-03-01');

CREATE TABLE refunds_2026_01 PARTITION OF refunds
FOR VALUES FROM ('2026-01-01') TO ('2026-02-01');
CREATE TABLE refunds_2026_02 PARTITION OF refunds
FOR VALUES FROM ('2026-02-01') TO ('2026-03-01');

INSERT INTO sales VALUES
('2026-01-01', 1, 100.00),
('2026-01-01', 2, 150.00),
('2026-02-01', 3, 200.00);

INSERT INTO refunds VALUES
('2026-01-01', 2, 20.00),
('2026-02-01', 3, 50.00);

ANALYZE sales;
ANALYZE refunds;

SET enable_partitionwise_join = on;
SET enable_partitionwise_aggregate = on;
SET work_mem = '4MB';

EXPLAIN (ANALYZE, COSTS OFF, SUMMARY OFF, TIMING OFF)
SELECT s.month_start,
       sum(s.amount) AS gross_sales,
       coalesce(sum(r.amount), 0) AS refunded
FROM sales AS s
LEFT JOIN refunds AS r
  ON r.month_start = s.month_start
 AND r.order_id = s.order_id
GROUP BY s.month_start
ORDER BY s.month_start;

SELECT s.month_start,
       sum(s.amount) AS gross_sales,
       coalesce(sum(r.amount), 0) AS refunded
FROM sales AS s
LEFT JOIN refunds AS r
  ON r.month_start = s.month_start
 AND r.order_id = s.order_id
GROUP BY s.month_start
ORDER BY s.month_start;预期结果:EXPLAIN 的具体节点顺序会随版本、统计信息和成本估算变化,不应死记某一份文本计划;检查点是不同月份的子表在独立分支中完成 Join/聚合,然后再合并。最终查询结果固定为:
 month_start | gross_sales | refunded
-------------+-------------+----------
 2026-01-01  |      250.00 |    20.00
 2026-02-01  |      200.00 |    50.00
(2 rows)
如果执行计划仍把大量数据汇总到上层再 Join,先检查分区边界是否一致、连接谓词是否包含全部分区键,以及查询是否发生了类型转换或表达式改写。
内存成本要按节点数估算
work_mem 不是“整条查询最多能用多少内存”,而是很多 Sort、Hash、Aggregate 等节点各自可使用的工作内存预算。启用分区级执行后,一条查询可能从少量全局节点变成“每个分区一个或多个节点”,因此总内存不能简单按单个 work_mem 推算。官方文档明确提醒,这类节点数可能随扫描分区数量线性增加。:contentReference[oaicite:1]{index=1}
评估时同时观察三件事:总执行时间是否下降、EXPLAIN (ANALYZE, BUFFERS) 是否显示更少或更局部的数据处理、并发查询下是否出现 Hash/Sort 批次增加或临时文件 I/O。单次基准更快但高并发内存压力明显上升,通常不值得全局开启。
什么时候值得使用
优先考虑分区级 Join/Aggregate 的情况,是两张大表长期使用同一分区策略、典型查询天然带完整分区键、单分区数据量适中且分区数量可控。此时局部 Join 和局部聚合能够减少跨分区的数据交换与全局中间结果。
相反,如果有数百到数千个活跃分区、查询同时扫描大量分区,或者每个局部分支都需要较大的 Hash/Sort,规划成本和总内存可能抵消执行收益。分区级执行应被当作一种基于查询形态验证的优化开关,而不是“分区表必须开启”的固定配置。