
PostgreSQL / 系统课时
综合项目:生产数据库治理
综合项目:生产数据库治理
本项目把订单业务从“能运行”推进到“可治理”:建立适合查询的表模型和分区,给核心访问路径配置索引,同时补齐备份恢复、高可用和监控闭环。最终交付物不是一组零散参数,而是一套可以演练和验收的生产方案。
学习目标
- 为订单业务完成模型、分区和索引的组合设计
- 建立同时覆盖恢复能力与高可用的备份复制方案
- 用可验证指标定义监控、演练和上线验收条件
明确项目边界和验收目标
假设订单服务最常见的访问是:按客户查看最近订单、按时间批量归档历史订单、按状态处理待履约订单。项目练习可先设定示例目标:单个节点故障可以切换到备用库,备份可以恢复到隔离环境,监控能及时发现连接、慢查询、磁盘和复制异常。
生产治理需要同时考虑请求入口、主库、备用库、备份存储和监控系统,单独优化某一层并不能形成闭环。
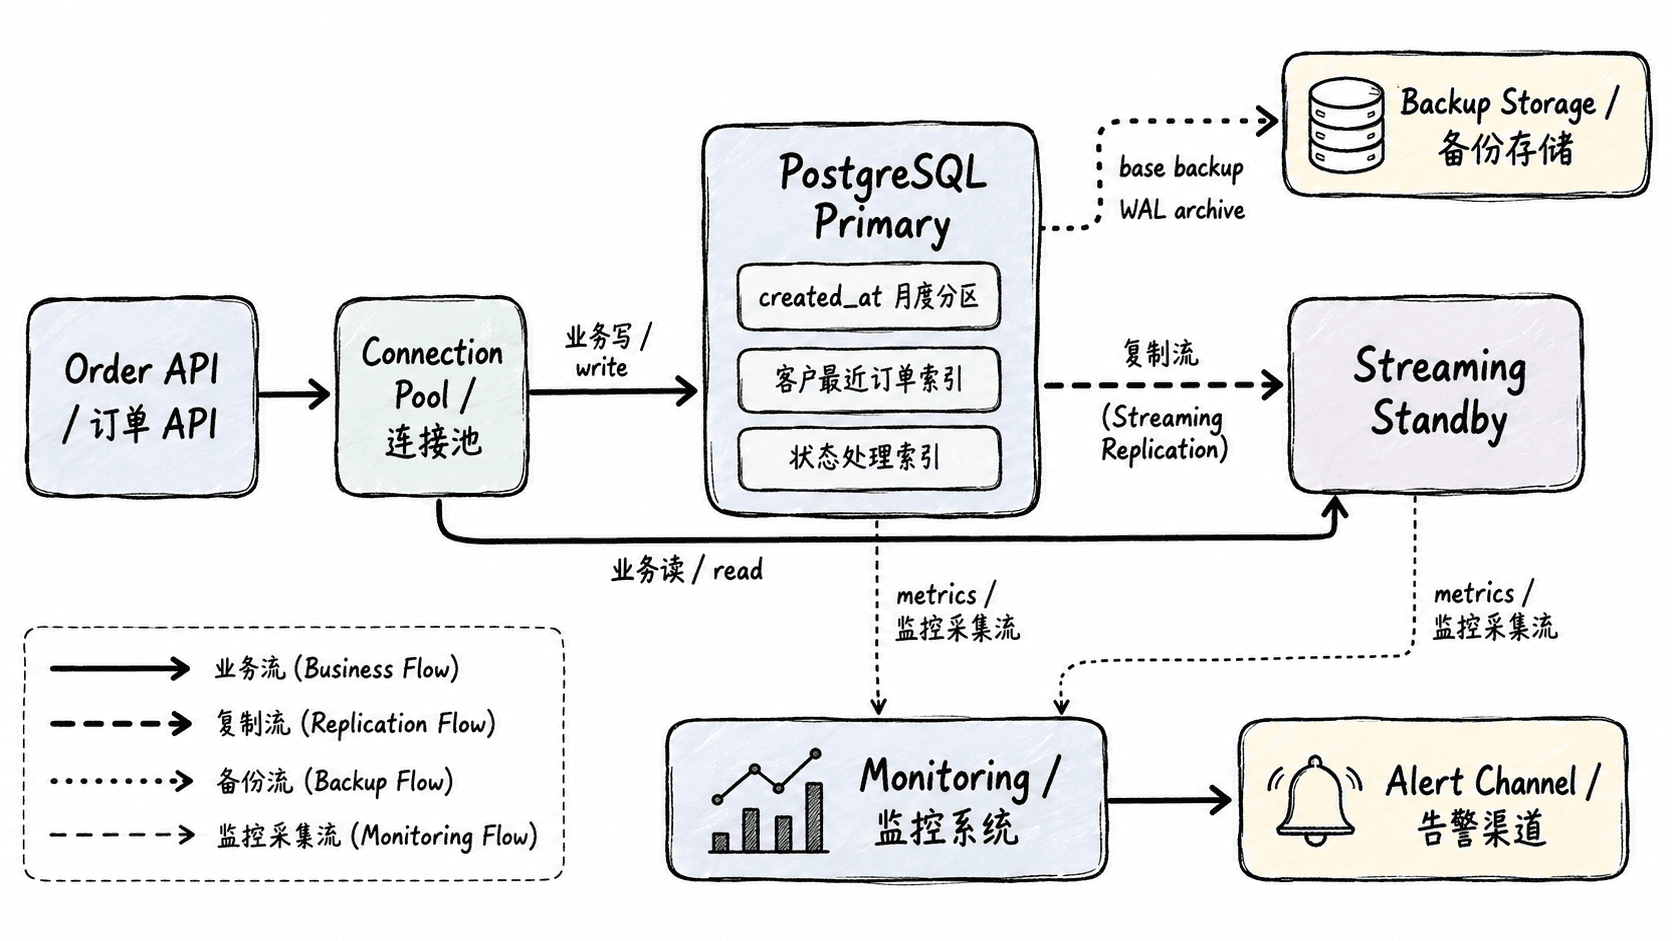
落地订单模型、分区与索引
分区键应服务数据生命周期,索引应服务真实查询。下面把订单按 created_at 做月度范围分区,并为“客户最近订单”和“待处理订单”建立访问路径。分区表上的唯一约束必须包含分区键,因此主键使用 (id, created_at)。
CREATE TABLE orders (
  id bigint GENERATED ALWAYS AS IDENTITY,
  customer_id bigint NOT NULL,
  status text NOT NULL CHECK (status IN ('created', 'paid', 'shipped', 'cancelled')),
  total_amount numeric(14, 2) NOT NULL CHECK (total_amount >= 0),
  created_at timestamptz NOT NULL,
  PRIMARY KEY (id, created_at)
) PARTITION BY RANGE (created_at);

CREATE TABLE orders_2026_09
PARTITION OF orders
FOR VALUES FROM ('2026-09-01 00:00:00+00')
         TO ('2026-10-01 00:00:00+00');

CREATE INDEX orders_customer_recent_idx
ON orders (customer_id, created_at DESC);

CREATE INDEX orders_open_status_idx
ON orders (status, created_at)
WHERE status IN ('created', 'paid');
预期输出
CREATE TABLE
CREATE TABLE
CREATE INDEX
CREATE INDEX
这里的关键不是“索引越多越好”。客户查询使用 customer_id 加时间排序,状态索引只覆盖需要后台处理的开放状态;已经完成或取消的订单不会进入这个部分索引,从而减少索引体积和写放大。
可以用一个最小数据集验证路由与查询行为:
INSERT INTO orders (customer_id, status, total_amount, created_at)
VALUES
  (1001, 'paid', 199.00, '2026-09-03 10:00:00+00'),
  (1001, 'shipped', 299.00, '2026-09-02 09:00:00+00');

SELECT
  tableoid::regclass AS partition_name,
  id,
  status,
  total_amount
FROM orders
WHERE customer_id = 1001
  AND created_at >= '2026-09-01 00:00:00+00'
ORDER BY created_at DESC;
预期结果
INSERT 0 2
 partition_name | id    | status  | total_amount
orders_2026_09  | <ID>  | paid    | 199.00
orders_2026_09  | <ID>  | shipped | 299.00
实际生成的 id 会不同。查询结果显示数据进入九月分区;上线前还应使用 EXPLAIN (ANALYZE, BUFFERS) 验证真实查询只扫描需要的分区,并结合生产数据量确认索引是否被合理使用。
把备份和恢复作为一套能力
高可用解决“节点坏了还能继续服务”,备份解决“误删、逻辑破坏或集群级事故后还能恢复”,两者不能互相替代。订单库至少应保留可恢复的基线备份,并持续归档 WAL;同时定期做逻辑备份,方便对象级迁移和抽查。
以下命令演示一次可移植的逻辑备份及目录校验:
pg_dump -Fc -d orders -f <PATH>/orders.dump
pg_restore -l <PATH>/orders.dump | head
预期输出
;
; Archive created at <TIME>
;     dbname: orders
;     TOC Entries: <VALUE>
...
pg_dump 成功时通常不输出正文,第二条命令会列出归档目录;<PATH>、时间和条目数以实际环境为准。恢复演练不能只验证文件存在,应在隔离实例执行 pg_restore,然后用订单数量、关键约束和抽样查询验证结果。
物理灾备层可启用 WAL 归档。以下为主库配置片段示例,目录和命令必须根据实际备份系统调整:
wal_level = replica
max_wal_senders = 10
max_replication_slots = 10
archive_mode = on
archive_command = 'test ! -f /backup/wal/%f && cp %p /backup/wal/%f'
这组配置允许流复制并把已完成 WAL 段归档到指定目录。验证时应检查 archive_command 返回成功、归档文件持续产生,并通过恢复演练证明“基线备份 + WAL”可以真正恢复,而不是只看磁盘里有文件。
建立主备与故障切换边界
备用库应通过流复制持续接收 WAL,并由复制槽或其他保留策略避免所需 WAL 被过早回收。初始化备用库时可以使用 pg_basebackup 自动写入连接信息:
pg_basebackup -h <IP> -p <PORT> -U replicator -D <PATH> -Fp -Xs -P -R -C -S orders_standby_1预期输出
waiting for checkpoint
<PROGRESS>
具体进度文本、路径和端口会因版本与环境不同,成功应以命令退出码为 0、备用库目录完整且实例能够正常启动为准。随后还要确认备用库 pg_stat_wal_receiver 为 streaming,主库 pg_stat_replication 能看到该备用库。
受控切换演练中,必须先隔离旧主库,避免两个节点同时接受写入。确认隔离后,可以在备用库执行提升并验证其已退出恢复模式:
SELECT pg_promote(wait => true, wait_seconds => 60);
SELECT pg_is_in_recovery();
预期结果
 pg_promote
------------
 t

 pg_is_in_recovery
-------------------
f用监控指标闭合治理流程
监控至少覆盖连接使用率、长事务与慢 SQL、数据库和表增长、WAL 归档失败、复制状态与延迟、备份新鲜度。指标必须能对应行动:例如连接使用率持续逼近上限要排查连接池,复制延迟持续增长要判断网络、I/O 或回放阻塞。
主库可以用以下 SQL 快速检查连接和复制:
SELECT
  count(*) AS used_connections,
  current_setting('max_connections')::int AS max_connections
FROM pg_stat_activity;

SELECT
  application_name,
  state,
  sync_state,
  pg_wal_lsn_diff(pg_current_wal_lsn(), replay_lsn) AS replay_lag_bytes
FROM pg_stat_replication;
预期输出
 used_connections | max_connections
<VALUE>            | <VALUE>

 application_name | state     | sync_state | replay_lag_bytes
orders-standby-1  | streaming | async      | <VALUE>
项目验收时,不只检查“数据库能启动”。应完成一次订单查询性能验证、一次分区维护操作、一次隔离环境恢复、一次备用库切换演练,并确认监控能在连接、磁盘、备份或复制异常时触发告警。只有这些动作都能被重复执行和记录,订单数据库才从配置集合变成可持续治理的生产系统。