
PostgreSQL / 系统课时
统计信息与行数估算
统计信息与行数估算
执行计划选错索引或连接顺序时,根因常常不是算法本身,而是优化器把“会返回多少行”估错了。本课用可复现数据观察单列统计的局限,并通过统计目标和扩展统计,让选择性估算更贴近真实数据。
学习目标
- 读懂
EXPLAIN中估算行数与实际行数的差异 - 知道何时提高列级统计目标,而不是盲目修改全局参数
- 使用
CREATE STATISTICS处理列相关性导致的组合条件误估
行数估算从哪里来
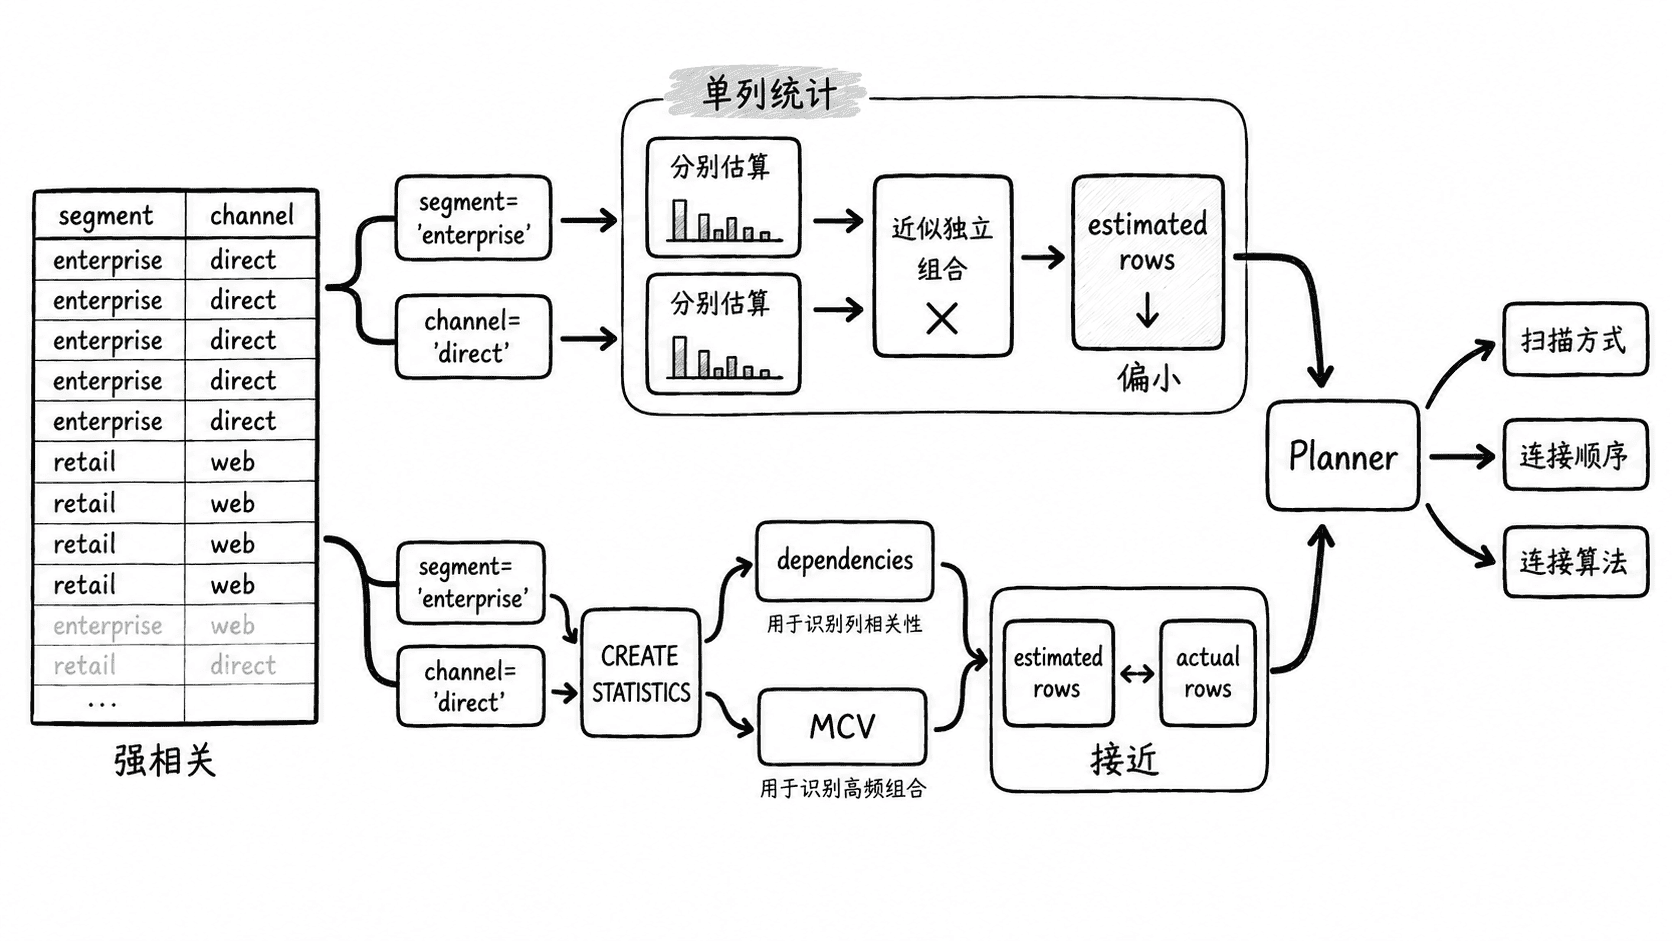
PostgreSQL 的优化器不会先执行 SQL 再决定计划,而是根据 ANALYZE 收集的统计信息估算过滤选择性。单列统计会描述空值比例、不同值数量、最常见值、直方图和物理相关性等特征,估算结果随后参与扫描方式、连接顺序和连接算法的成本计算。
问题常出现在多个条件同时过滤时。如果优化器只掌握各列各自的分布,就可能近似地组合这些选择性。当两列强相关时,把它们当成近似独立条件会导致估算偏差。
用可复现实验观察误差
下面构造 10 万行数据,其中 enterprise 与 direct 总是同时出现。单列统计能分别知道两个值各占约 10%,却无法仅凭这些信息完整表达二者之间的强相关性。
CREATE TEMP TABLE customer_segment (
    id bigint,
    segment text,
    channel text
);

INSERT INTO customer_segment
SELECT g,
       CASE WHEN g <= 10000 THEN 'enterprise' ELSE 'retail' END,
       CASE WHEN g <= 10000 THEN 'direct' ELSE 'web' END
FROM generate_series(1, 100000) AS g;

ALTER TABLE customer_segment
    ALTER COLUMN segment SET STATISTICS 500;

ANALYZE customer_segment;

SELECT attname, attstattarget
FROM pg_attribute
WHERE attrelid = 'customer_segment'::regclass
  AND attname = 'segment';

EXPLAIN (ANALYZE, TIMING OFF)
SELECT *
FROM customer_segment
WHERE segment = 'enterprise'
  AND channel = 'direct';

CREATE STATISTICS customer_segment_ext (dependencies, mcv)
ON segment, channel
FROM customer_segment;

ANALYZE customer_segment;

EXPLAIN (ANALYZE, TIMING OFF)
SELECT *
FROM customer_segment
WHERE segment = 'enterprise'
  AND channel = 'direct';
预期结果
CREATE TABLE
INSERT 0 100000
ALTER TABLE
ANALYZE
 attname | attstattarget
---------+---------------
 segment |           500
(1 row)

创建扩展统计前:
Seq Scan on customer_segment  (cost=<VALUE> rows=<VALUE> width=<VALUE>) (actual rows=10000 loops=1)
  Filter: ((segment = 'enterprise'::text) AND (channel = 'direct'::text))

CREATE STATISTICS
ANALYZE

创建扩展统计后:
Seq Scan on customer_segment  (cost=<VALUE> rows=<VALUE> width=<VALUE>) (actual rows=10000 loops=1)
  Filter: ((segment = 'enterprise'::text) AND (channel = 'direct'::text))

关键观察:第二个计划中的估算 rows 应明显更接近 actual rows=10000。cost、估算 rows 和执行时间会随 PostgreSQL 版本、统计采样和运行环境变化,因此使用 <VALUE> 表示动态值。实验真正要比较的是估算行数与实际行数之间的数量级差距是否缩小。
统计目标解决单列精度
ALTER COLUMN ... SET STATISTICS 调整的是后续 ANALYZE 为指定列收集统计信息的详细程度。高基数、分布明显倾斜并且经常用于过滤的列,可以有针对性地提高目标;均匀分布或很少参与条件判断的列通常没有必要这样做。
提高统计目标可能改善最常见值和直方图等单列分布信息,但也会增加统计采集成本和统计数据体积。更重要的是,它解决的是单列统计精度,不会自动表达 segment 与 channel 总是一起变化这种跨列关系。
扩展统计解决相关性
CREATE STATISTICS 可以为多列关系建立额外信息。dependencies 适合描述列之间的依赖关系,ndistinct 用于改善多列组合不同值数量的估算,mcv 则记录常见的多列值组合。创建统计对象后必须再次执行 ANALYZE,规划器才能获得相应数据。
扩展统计首先解决的是估算问题,而不是强制某种执行计划。即使估算变准,优化器仍可能继续选择顺序扫描,因为在当前数据规模和成本条件下,顺序扫描可能确实更便宜。
按误差来源选择手段
排查时先用 EXPLAIN (ANALYZE ...) 找出 estimated rows 与 actual rows 偏差最大的节点。如果单个过滤列存在长尾或倾斜分布,可以提高该列统计目标;如果多个条件之间明显相关,则优先考虑扩展统计;如果表刚经历大量装载或更新,则先确认统计信息是否已经通过 ANALYZE 刷新。
统计信息与索引解决的是不同问题:统计信息帮助优化器判断“会有多少数据”,索引改变“怎样访问这些数据”。先把行数估算修正到合理范围,再判断扫描方式和连接策略是否仍需优化,通常比直接增加索引或调整成本参数更可靠。