
PostgreSQL / 系统课时
阻塞链与死锁排查
阻塞链与死锁排查
锁等待并不等于死锁。真正高效的排查顺序是先找“谁在等谁”,再定位最上游的根阻塞会话,最后结合 pg_locks 和服务器日志判断锁资源与死锁环路。本节给出可直接运行的诊断 SQL,并用双会话实验复现死锁。
学习目标
- 用
pg_stat_activity与pg_blocking_pids()还原阻塞关系 - 结合
pg_locks判断等待的锁类型和资源 - 复现死锁并区分“长时间阻塞”与“循环等待”
先分清阻塞与死锁
阻塞链可以是单向的,例如会话 C 等会话 B、会话 B 又等会话 A;只要 A 最终提交或回滚,链条就会依次解除。死锁则存在环,例如 A 等 B 持有的锁,同时 B 又等 A 持有的锁,任何一方都无法自行前进。
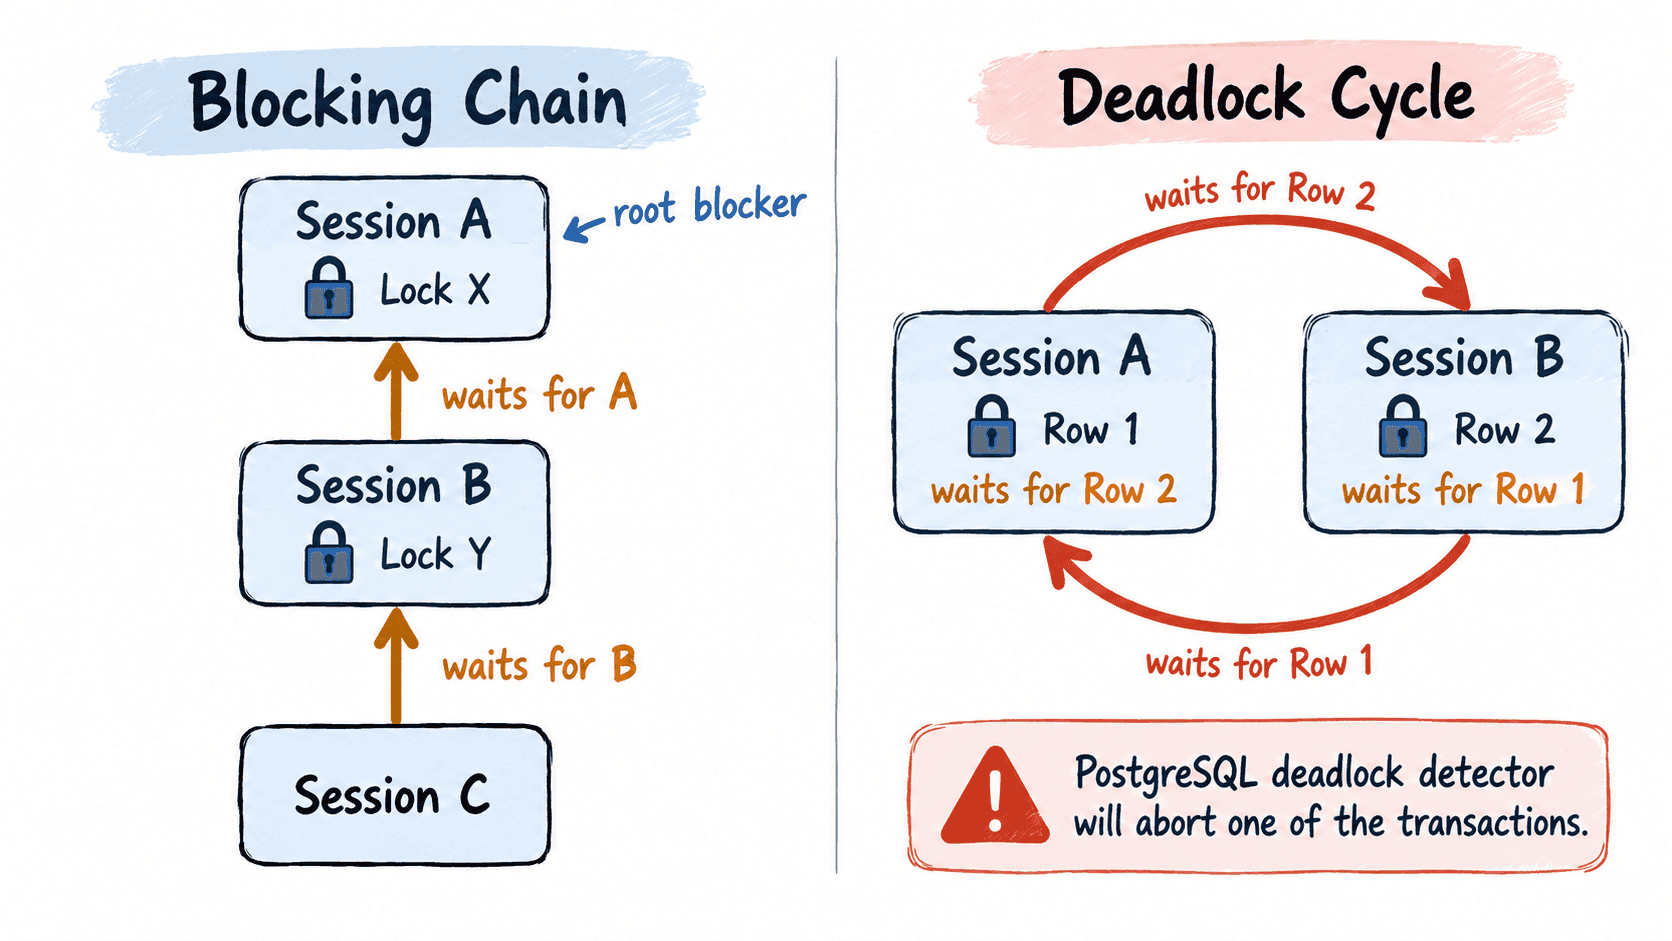
PostgreSQL 在检测到死锁后会主动中止其中一个事务并返回 deadlock detected;普通阻塞则不会因为“等得久”自动变成死锁。排障时不要先猜表名或索引,而应先恢复等待边。
从活动会话还原阻塞边
下面的查询把每个等待会话与其直接阻塞者展开成一行。pg_blocking_pids() 比单纯在 pg_locks 中手工拼锁键更适合先回答“谁阻塞了谁”。
SELECT
    w.pid AS waiting_pid,
    w.usename AS waiting_user,
    w.wait_event_type,
    w.wait_event,
    b.pid AS blocking_pid,
    b.usename AS blocking_user,
    now() - b.xact_start AS blocker_xact_age,
    b.state AS blocker_state,
    b.query AS blocker_query
FROM pg_stat_activity AS w
CROSS JOIN LATERAL unnest(pg_blocking_pids(w.pid)) AS x(blocking_pid)
JOIN pg_stat_activity AS b
  ON b.pid = x.blocking_pid
ORDER BY w.pid, b.pid;
预期输出:
 waiting_pid | waiting_user | wait_event_type | wait_event    | blocking_pid | blocking_user | blocker_xact_age | blocker_state | blocker_query
-------------+--------------+-----------------+---------------+--------------+---------------+------------------+---------------+-------------------------
 <PID>       | app_user     | Lock            | transactionid | <PID>        | app_user      | <TIME>           | idle in transaction | UPDATE ...
<PID> 和 <TIME> 会随现场变化。若查不到行,说明当前采样时刻没有通过 PostgreSQL 锁管理器识别到的直接阻塞关系;如果只能看到自己的完整 SQL,需要使用具有足够统计信息权限的账号,例如被授予合适的监控角色。
要直接找根阻塞者,可以只保留“阻塞了别人、但自己没有再被别人阻塞”的会话。
WITH wait_edges AS (
    SELECT
        a.pid AS waiting_pid,
        unnest(pg_blocking_pids(a.pid)) AS blocking_pid
    FROM pg_stat_activity AS a
    WHERE cardinality(pg_blocking_pids(a.pid)) > 0
)
SELECT
    b.pid AS root_blocker_pid,
    b.usename,
    b.state,
    now() - b.xact_start AS xact_age,
    b.query
FROM pg_stat_activity AS b
WHERE EXISTS (
    SELECT 1
    FROM wait_edges AS e
    WHERE e.blocking_pid = b.pid
)
AND cardinality(pg_blocking_pids(b.pid)) = 0
ORDER BY b.xact_start NULLS LAST;
预期输出:
 root_blocker_pid | usename  | state               | xact_age | query
------------------+----------+---------------------+----------+-------------------------
 <PID>            | app_user | idle in transaction | <TIME>   | UPDATE ...
如果根阻塞会话长期处于 idle in transaction,通常意味着应用开启事务并取得锁后迟迟没有提交或回滚,这类会话往往比“正在执行的慢 SQL”更值得优先检查。
用 pg_locks 看等待的资源
知道涉及哪些 PID 后,再看 pg_locks。下面的查询自动收集当前等待者和阻塞者,不需要手工填写 PID。
WITH involved AS (
    SELECT pid
    FROM pg_stat_activity
    WHERE cardinality(pg_blocking_pids(pid)) > 0

    UNION

    SELECT unnest(pg_blocking_pids(pid))
    FROM pg_stat_activity
    WHERE cardinality(pg_blocking_pids(pid)) > 0
)
SELECT
    l.pid,
    l.locktype,
    l.mode,
    l.granted,
    l.relation::regclass AS relation,
    l.transactionid,
    l.virtualxid
FROM pg_locks AS l
JOIN involved AS i USING (pid)
ORDER BY l.pid, l.granted, l.locktype, l.mode;
预期结果:
 pid   | locktype     | mode             | granted | relation | transactionid | virtualxid
-------+--------------+------------------+---------+----------+---------------+-----------
 <PID> | transactionid| ShareLock        | f       |          | <ID>          |
 <PID> | transactionid| ExclusiveLock    | t       |          | <ID>          |
 <PID> | relation     | RowExclusiveLock | t       | <VALUE>  |               |
这是行更新冲突时常见的形态,具体行数、锁模式和资源会随现场变化。特别要注意:行锁竞争经常表现为等待对方事务 ID,因此不要只搜索 locktype = 'tuple',否则很容易漏掉真正的等待关系。
双会话复现死锁
先建立两行测试数据。
DROP TABLE IF EXISTS deadlock_demo;
CREATE TABLE deadlock_demo (
    id integer PRIMARY KEY,
    value text NOT NULL
);

INSERT INTO deadlock_demo (id, value)
VALUES (1, 'one'), (2, 'two');
预期输出:
DROP TABLE
CREATE TABLE
INSERT 0 2
在会话 A 中先更新第 1 行。
BEGIN;
UPDATE deadlock_demo
SET value = 'a-owns-1'
WHERE id = 1;
预期输出:
BEGIN
UPDATE 1
在会话 B 中先更新第 2 行。
BEGIN;
UPDATE deadlock_demo
SET value = 'b-owns-2'
WHERE id = 2;
预期输出:
BEGIN
UPDATE 1
接着让会话 B 请求第 1 行。由于第 1 行仍被 A 锁住,这条语句会等待。
UPDATE deadlock_demo
SET value = 'b-wants-1'
WHERE id = 1;
预期输出:
<WAITING>保持 B 等待,再回到会话 A 请求第 2 行,就形成 A 等 B、B 又等 A 的闭环。
UPDATE deadlock_demo
SET value = 'a-wants-2'
WHERE id = 2;
预期结果:
ERROR:  deadlock detected
DETAIL:  Process <PID> waits for ShareLock on transaction <ID>; blocked by process <PID>.
HINT:  See server log for query details.
具体被 PostgreSQL 选为牺牲者的事务可能是 A,也可能是 B,因此 <PID>、<ID> 以及最终报错所在会话都可能不同。收到错误的事务已经失败,应执行 ROLLBACK 后重新开始,而不是继续复用当前事务状态。
修复时先处理根因
现场处置时,优先确认根阻塞会话对应的业务、事务开始时间和 SQL,再决定是等待、取消查询还是终止连接。直接终止会话会触发事务回滚,可能释放大量锁,也可能造成业务重试压力,因此不应只凭“PID 等得最久”就操作。
长期修复通常落在事务设计上:统一多资源加锁顺序,避免在事务中执行远程调用或人工等待,尽快提交已取得锁的事务,并让高冲突更新只覆盖必要行。若需要追踪长时间锁等待,可结合服务器日志启用合适的锁等待记录;死锁发生时,则应保留错误日志中的参与 PID、事务与 SQL,再对照应用调用链定位为什么会出现相反的加锁顺序。