
PostgreSQL / 系统课时
内存与检查点调优
内存与检查点调优
PostgreSQL 的内存参数和检查点参数会共同决定吞吐、延迟与 I/O 波动。本节不套固定百分比,而是先拆清不同内存的作用域,再用基线数据调整 shared_buffers、work_mem、维护内存与检查点节奏。
学习目标
- 区分共享缓存、查询工作内存和维护内存的作用域与放大效应。
- 理解
checkpoint_timeout、max_wal_size与checkpoint_completion_target如何改变写盘节奏。 - 按并发、临时文件、WAL 与 I/O 现象制定可验证的调优顺序。
先把内存拆成不同作用域
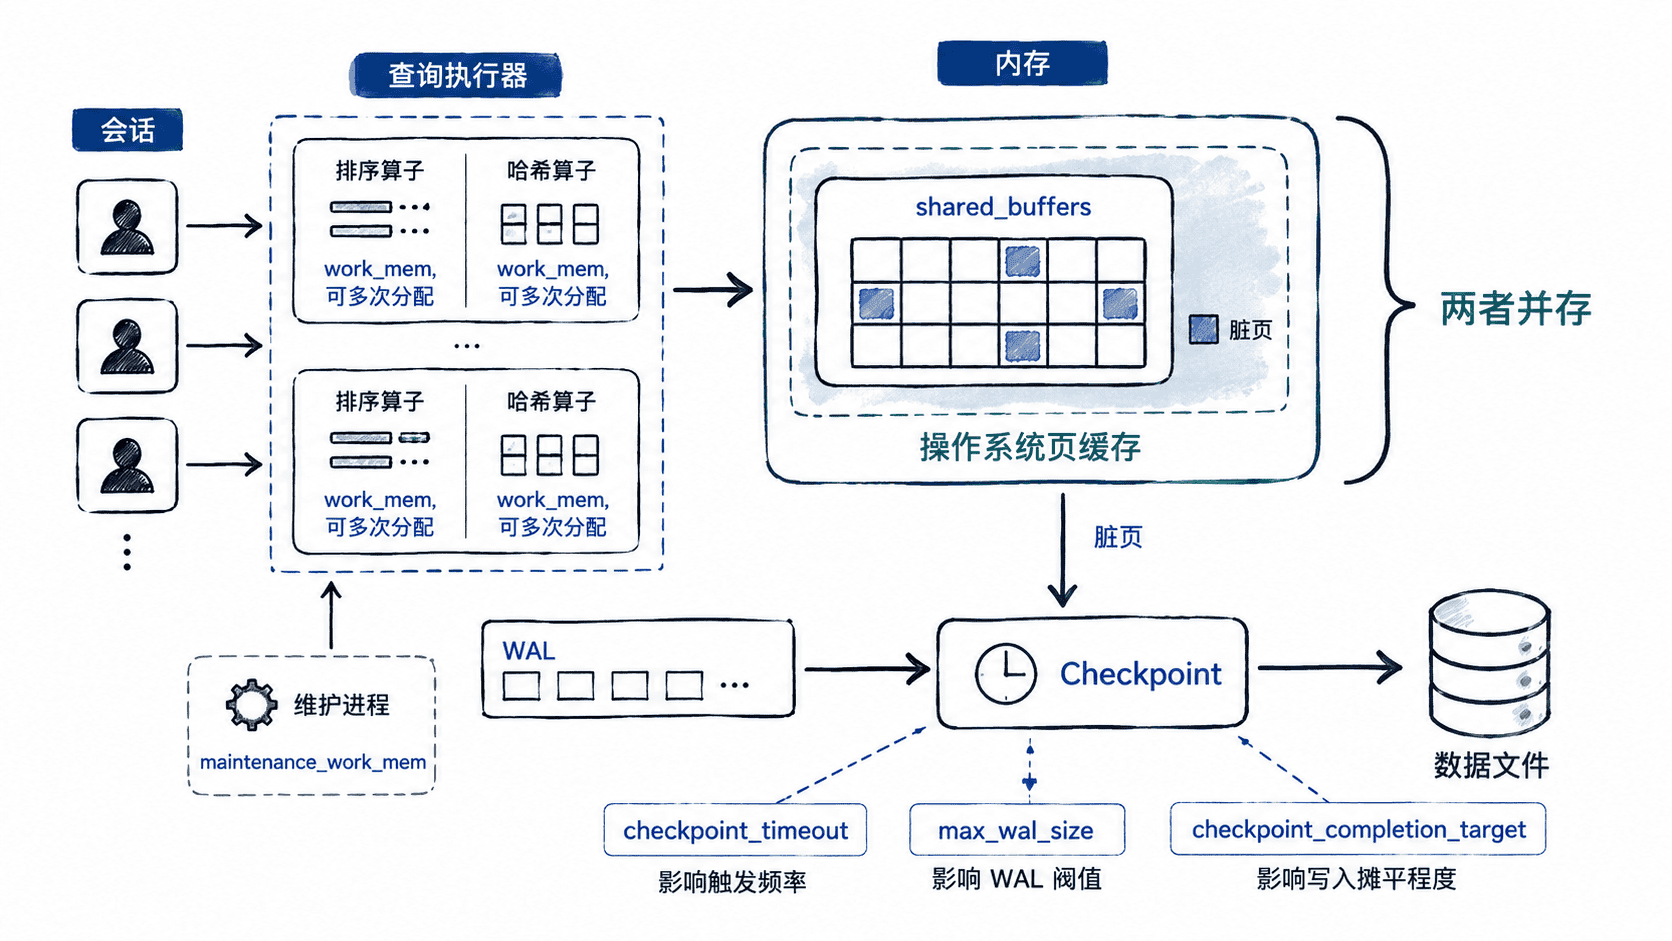
shared_buffers 是 PostgreSQL 自己管理的共享缓存,所有会话共同使用;它并不等于数据库可用内存总量,因为操作系统页缓存、连接进程、后台进程和其他服务也需要内存。把它调得过大,反而可能挤压操作系统缓存或触发交换。
work_mem 的风险来自“可重复分配”。它不是每个实例一份,也不一定只是每个连接一份;一个复杂查询中的多个排序、哈希节点以及并行 worker 都可能分别使用工作内存。因此评估上界时应同时考虑活跃会话数、单查询内存型算子数量和并行度,而不是直接用“最大连接数 × work_mem”。
maintenance_work_mem 主要服务于 VACUUM、建索引等维护任务,通常可以明显高于普通查询的 work_mem,但仍要考虑并发维护任务。自动清理还可能由独立的 autovacuum_work_mem 控制,因此不能只看一个参数判断维护内存上限。
检查点调节的是写盘节奏
检查点把一段时间内积累的脏页推进到持久化状态,并限制崩溃恢复时需要重放的 WAL 范围。checkpoint_timeout 控制时间维度,max_wal_size 是触发自动检查点的重要软阈值,checkpoint_completion_target 则决定检查点写入尽量分散到周期中的多大比例。
检查点过密时,常见现象是 WAL 生成不算异常却频繁出现集中写盘和延迟尖峰;放得过松,则会占用更多 WAL 空间,并可能增加崩溃恢复时间。目标不是“检查点越少越好”,而是让写入速率、WAL 容量和恢复目标相互匹配。
读取当前参数并建立基线
先记录当前值和参数上下文,再做任何修改。pending_restart 可以帮助识别是否存在尚未通过重启生效的配置。
SELECT name,
       setting,
       unit,
       context,
       pending_restart
FROM pg_settings
WHERE name IN (
    'shared_buffers',
    'work_mem',
    'maintenance_work_mem',
    'checkpoint_timeout',
    'max_wal_size',
    'checkpoint_completion_target'
)
ORDER BY name;
预期结果
name                         | setting | unit  | context    | pending_restart
-----------------------------+---------+-------+------------+----------------
checkpoint_completion_target | <VALUE> |       | sighup     | <VALUE>
checkpoint_timeout           | <VALUE> | s     | sighup     | <VALUE>
maintenance_work_mem         | <VALUE> | kB    | user       | <VALUE>
max_wal_size                 | <VALUE> | MB    | sighup     | <VALUE>
shared_buffers               | <VALUE> | 8kB   | postmaster | <VALUE>
work_mem | <VALUE> | kB | user | <VALUE>实际数值会随实例配置不同而变化。context=postmaster 表示像 shared_buffers 这样的参数需要重启实例才能生效;其他参数是否能在会话中临时覆盖,还应以 pg_settings.context 为准。
按压力模型修改参数
不要从“内存总量的固定百分比”反推所有参数。更稳妥的顺序是先确定系统可给 PostgreSQL 使用的内存预算和最大活跃并发,再给共享缓存留出空间,最后根据真实查询中的排序、哈希和并行度估算 work_mem。如果只有少数报表查询需要更大工作内存,优先对角色、数据库或单个会话定向设置,而不是全局放大。
下面是 postgresql.conf 的配置片段,<VALUE> 需要替换为经过压测验证的值;内存和时间参数应写明单位。
shared_buffers = '<VALUE>'
work_mem = '<VALUE>'
maintenance_work_mem = '<VALUE>'
checkpoint_timeout = '<VALUE>'
max_wal_size = '<VALUE>'
checkpoint_completion_target = <VALUE>
这类配置的验证重点不是“文件能解析”而是行为是否改善。修改 shared_buffers 后需要按实例方式重启;其他可重载参数修改后应重新加载配置,并再次查询 pg_settings 确认新值。对于会话级参数,旧连接可能继续保留原值,因此连接池环境还要考虑连接生命周期。
用症状反推下一步
如果系统出现交换、OOM 或内存瞬间放大,先检查活跃并发、复杂查询和并行度,再降低全局 work_mem 或限制并发;如果大量排序、哈希落到临时文件,则先优化查询和索引,再对确有需要的工作负载定向提高 work_mem。
如果写入延迟呈周期性尖峰,应检查检查点是否过于频繁,并结合 WAL 产生速度和磁盘空间评估 max_wal_size、checkpoint_timeout 与 checkpoint_completion_target。如果为了平滑 I/O 持续放大 WAL 窗口,也要同时验证磁盘余量和可接受的故障恢复时间。
内存调优与检查点调优最终都要回到同一原则:一次只改变少量参数,在相同负载下比较吞吐、尾延迟、临时文件、WAL 增长和 I/O 峰值。没有可复现基线的“经验值”,很难证明是在优化还是把问题推迟到下一次高峰。