
PostgreSQL / 系统课时
连接、排序与聚合算法
连接、排序与聚合算法
同一条 SQL 可能因为输入规模、数据顺序和可用内存不同,切换成完全不同的连接、排序或聚合算法。本课通过 EXPLAIN (ANALYZE) 识别这些节点,并判断 work_mem 过小时何时发生磁盘排序或哈希分批溢写。
学习目标
- 区分 Nested Loop、Hash Join 与 Merge Join 的典型适用条件
- 从执行计划识别外部排序、哈希分批和聚合溢写
- 正确理解
work_mem对单个执行操作的影响及其并发风险
连接算法取决于输入形态
Nested Loop 会让外层输入的每一行驱动一次内层访问。当外层行数较少,并且内层可以通过索引快速定位时,这种算法通常很有效;如果两侧都很大而内层又需要反复扫描,成本会迅速增加。
Hash Join 通常用于等值连接。执行器先读取一侧建立哈希表,再扫描另一侧按连接键探测;哈希表装不进允许的内存时,会拆成多个 batch 并借助临时文件处理。Merge Join 则要求两侧按连接键有序,已有索引顺序时尤其有价值,否则可能需要额外 Sort。
优化器不会按固定优先级选择这三种算法,而是比较候选计划成本。因此前置节点的行数估算一旦严重失真,也可能进一步造成连接顺序或连接算法选择不合理。
排序和哈希怎样落盘
Sort 节点在数据能够放进内存时通常直接进行内存排序;超出工作内存后,可转换为 external merge,并在执行计划中报告磁盘使用。Hash Join 或 HashAggregate 的哈希结构无法容纳时,则可能分成多个批次处理并使用临时磁盘空间。
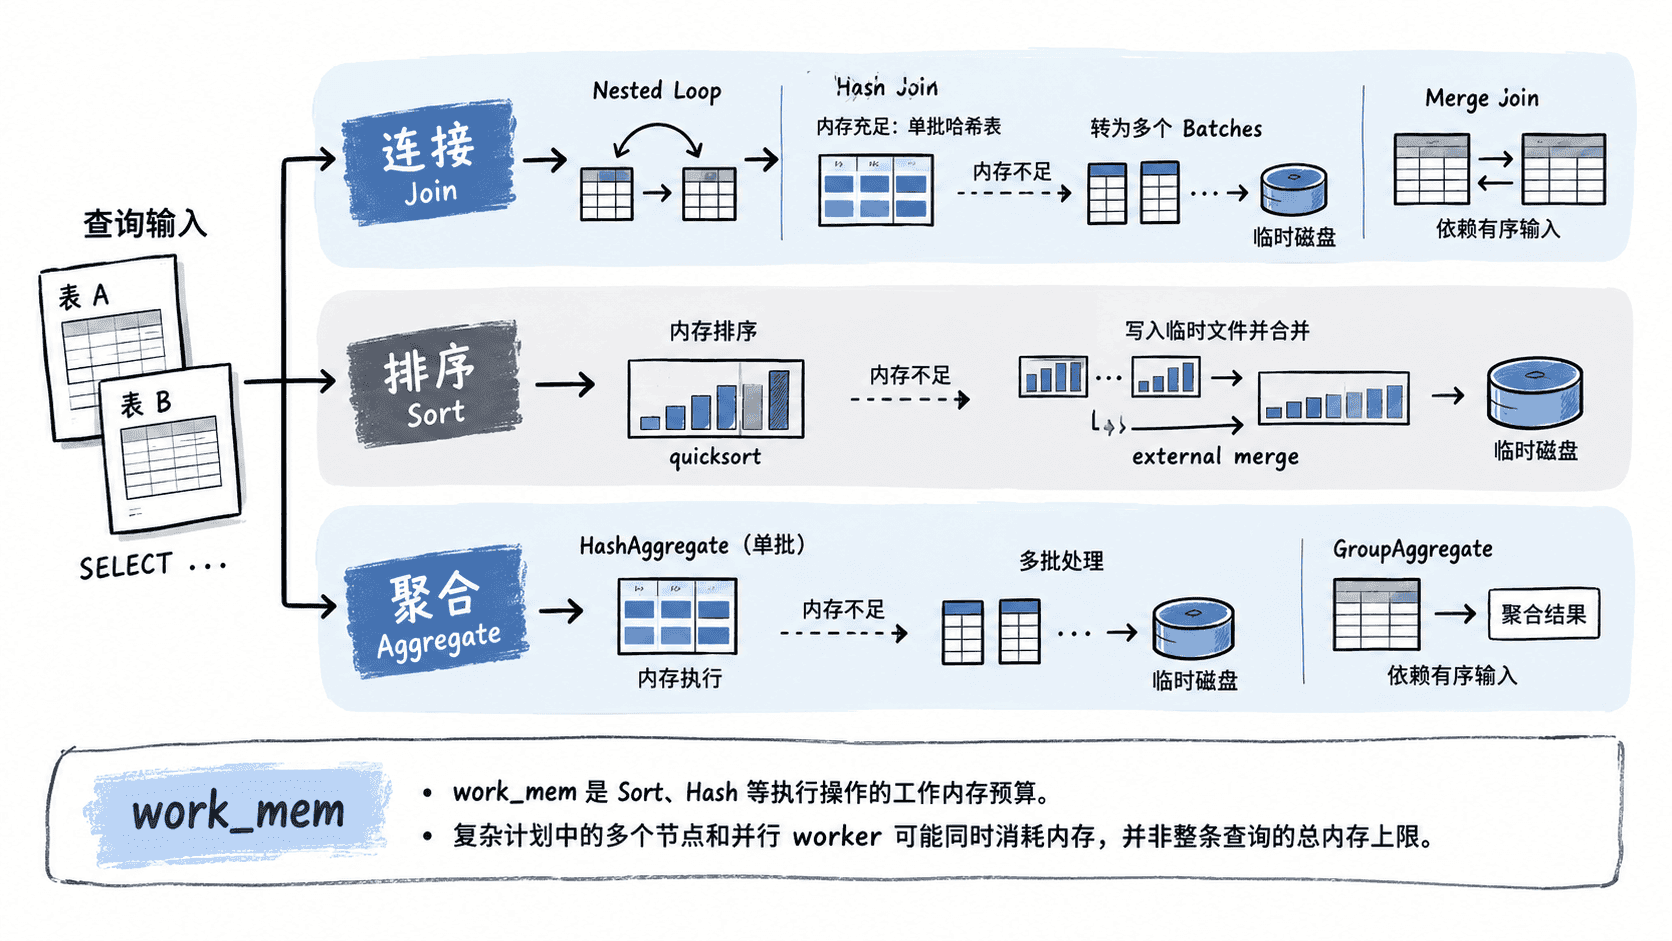
复杂计划里可能同时存在多个 Sort 或 Hash 操作,并发会话和并行执行还会进一步叠加内存需求。因此,提高 work_mem 应以实际执行计划为依据,而不是把一个较大的值直接设成所有连接的全局默认值。
用低内存制造可观察的溢写
下面创建 10 万客户和 50 万订单。查询需要 Hash Join、对 10 万个分组执行聚合,并对聚合结果排序。把当前会话的 work_mem 设置为 64kB 后,大型排序和哈希结构更容易出现临时磁盘使用。
CREATE TEMP TABLE dim_customer AS
SELECT g AS customer_id,
       'region-' || (g % 100) AS region
FROM generate_series(1, 100000) AS g;

CREATE TEMP TABLE fact_orders AS
SELECT g AS order_id,
       (g % 100000) + 1 AS customer_id,
       (g % 5000)::numeric AS amount
FROM generate_series(1, 500000) AS g;

ANALYZE dim_customer;
ANALYZE fact_orders;

SET work_mem = '64kB';

EXPLAIN (ANALYZE, BUFFERS, TIMING OFF)
SELECT d.region,
       f.customer_id,
       sum(f.amount) AS total_amount
FROM fact_orders AS f
JOIN dim_customer AS d USING (customer_id)
GROUP BY d.region, f.customer_id
ORDER BY total_amount DESC, f.customer_id;

SET work_mem = '64MB';

EXPLAIN (ANALYZE, BUFFERS, TIMING OFF)
SELECT d.region,
       f.customer_id,
       sum(f.amount) AS total_amount
FROM fact_orders AS f
JOIN dim_customer AS d USING (customer_id)
GROUP BY d.region, f.customer_id
ORDER BY total_amount DESC, f.customer_id;
预期结果
低 work_mem 计划的关键特征:
Sort  (...)
  Sort Key: (sum(f.amount)) DESC, f.customer_id
  Sort Method: external merge  Disk: <VALUE>kB
  ->  <AGGREGATE_NODE>  (...)
        ->  Hash Join  (...)
              Hash Cond: (f.customer_id = d.customer_id)
              ->  Seq Scan on fact_orders f  (...)
              ->  Hash  (...)
                    Buckets: <VALUE>  Batches: <VALUE>  Memory Usage: <VALUE>kB

高 work_mem 计划的关键特征:
Sort  (...)
  Sort Key: (sum(f.amount)) DESC, f.customer_id
  Sort Method: quicksort  Memory: <VALUE>kB
  ->  <AGGREGATE_NODE>  (...)
        ->  Hash Join  (...)
              Hash Cond: (f.customer_id = d.customer_id)
              ->  Seq Scan on fact_orders f  (...)
              ->  Hash  (...)
                    Buckets: <VALUE>  Batches: 1  Memory Usage: <VALUE>kB

Execution Time: <VALUE> ms
计划细节会受 PostgreSQL 版本、硬件和成本估算影响,聚合节点可能表现为 HashAggregate、GroupAggregate 或带并行阶段的变体。实验需要关注的是低内存计划中的 external merge、Disk 和大于 1 的 Batches,以及提高内存后这些指标是否消失或下降。
聚合算法也受输入与内存影响
HashAggregate 使用分组键建立哈希结构,不要求输入预先排序,在分组数量适中并且内存能够容纳哈希状态时很有效。如果执行计划显示多个 batch 或 Disk Usage,说明哈希聚合已经需要额外的分批或磁盘处理。
GroupAggregate 按有序的分组键连续处理相同组。如果上游已经通过索引、Merge Join 或 Sort 提供所需顺序,它可能很有竞争力;如果必须先对大量数据排序,则还要把排序成本和潜在的磁盘溢写一起计算。
因此不能只看到 HashAggregate 或 GroupAggregate 名称就判断好坏。需要同时检查输入行数、分组数量、排序来源、实际内存和临时磁盘使用。
正确理解 work_mem
work_mem 是排序和哈希等执行操作使用的基础工作内存参数,不是“一条 SQL 最多只能使用这么多内存”的硬性总上限。一次计划可以包含多个需要工作内存的节点,而并行执行时多个 worker 也可能同时产生内存需求。
哈希类操作的实际内存预算还会受到 hash_mem_multiplier 影响。因此发现 Hash Join 或 HashAggregate 溢写时,可以在会话级实验中调整内存参数并重新执行计划,但生产环境必须结合查询并发数评估总内存风险。
实际排查应先确认 estimated rows 与 actual rows 是否合理,再检查为何选择当前连接算法,然后寻找 Sort、Hash 和 Aggregate 节点中的磁盘使用,最后才试调 work_mem。这样可以区分“计划选择错误”和“正确计划获得的内存太少”,避免用调参掩盖统计信息或索引层面的真正问题。