
PostgreSQL / 系统课时
批量变更后的维护
批量变更后的维护
一次大规模导入、归档、删除或更新结束后,数据库虽然“事务已经提交”,但统计信息、死元组、索引结构和可见性映射未必已经恢复到适合下一阶段负载的状态。本篇给出一套按变更类型安排 ANALYZE、VACUUM 和重建动作的顺序。
学习目标
- 根据批量导入、删除和更新选择不同维护动作
- 用统计视图验证维护是否已经生效
- 避免长事务、过度重写和无谓重建拖慢恢复
先判断批量变更留下了什么
纯批量插入主要改变数据分布和行数,最先需要的是新的优化器统计信息,因此通常先执行 ANALYZE。如果是新建表的大规模装载,还可以评估“先装载、后建非必要索引”,减少逐行维护索引的成本。
批量 DELETE 会留下大量待回收旧版本;批量 UPDATE 既可能产生旧行版本,也可能增加索引维护。如果更新没有改变索引列且满足 HOT 条件,索引压力会小一些,但表中的旧版本仍需要 VACUUM 处理。
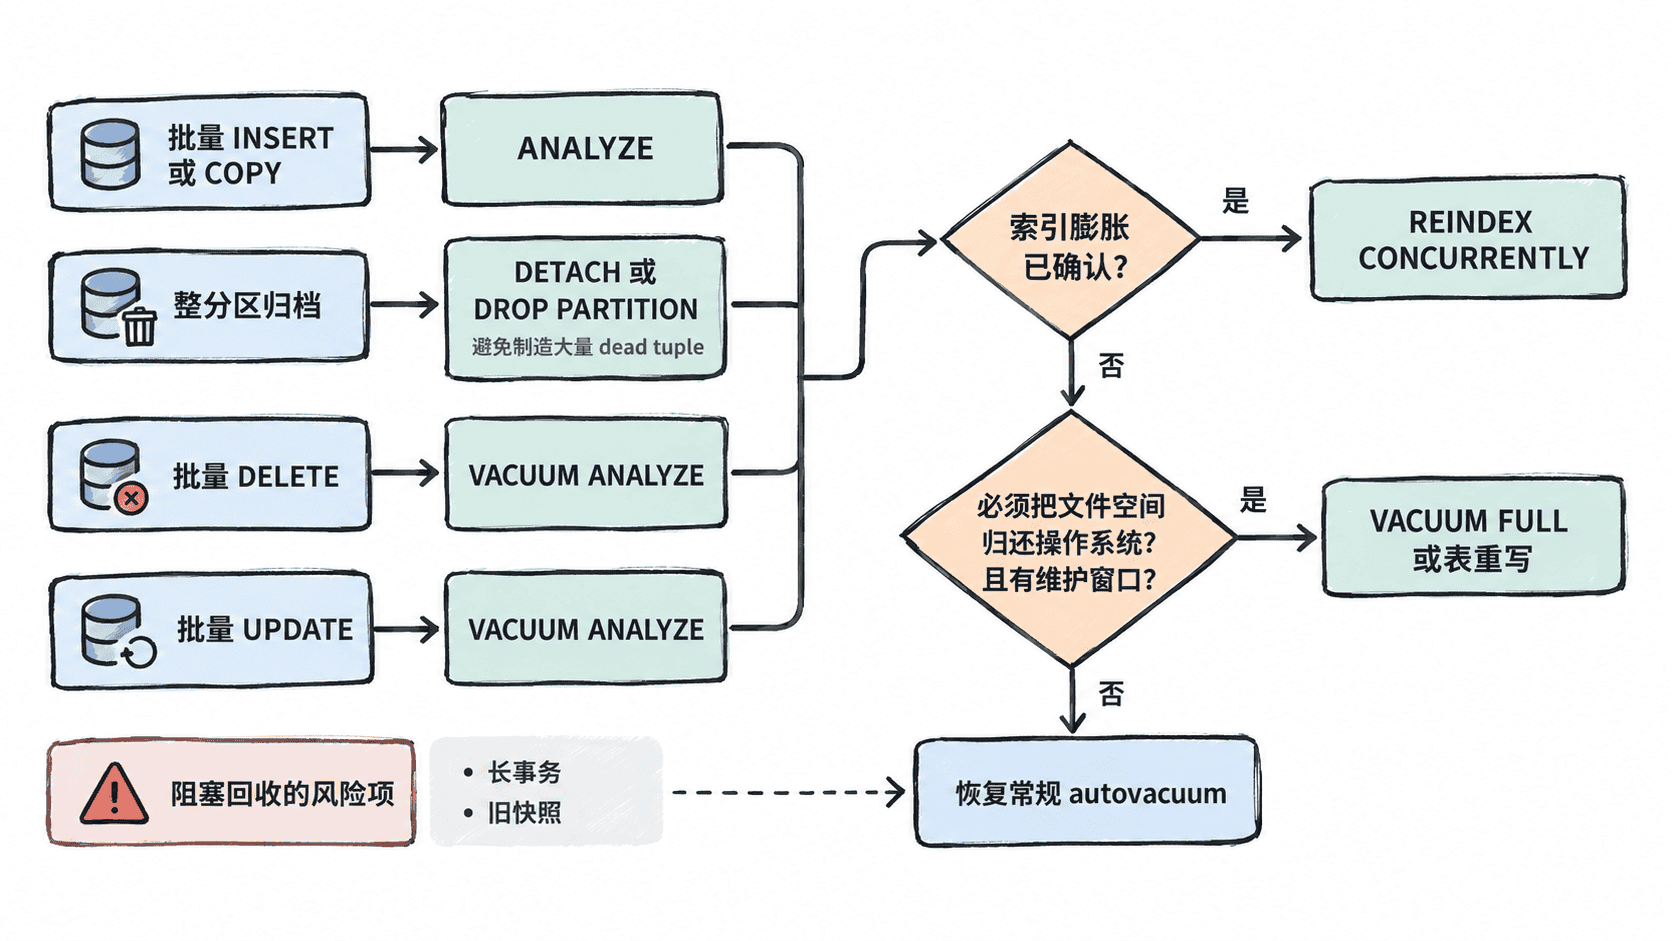
维护动作按变更类型选择
对批量导入,核心动作通常是 ANALYZE,让优化器尽快看到新的行数、值分布和列相关性。对批量删除或更新,则更常用 VACUUM (ANALYZE):一边回收不再可见的旧版本,一边刷新统计信息。
如果归档目标恰好是整个时间分区,优先通过分区切换或删除完成,而不是对分区内每一行执行 DELETE。这样既减少 WAL 和死元组,也减少后续 VACUUM 压力。只有当业务必须保留同一物理表结构时,才需要承担大批量行级删除后的清理成本。
一个典型的删除或更新后维护流程如下。VACUUM 不能放在显式事务块中,因此应在批量事务提交后单独执行。
VACUUM (ANALYZE, VERBOSE) public.orders;

SELECT
    relname,
    n_live_tup,
    n_dead_tup,
    last_vacuum,
    last_autovacuum,
    last_analyze,
    last_autoanalyze
FROM pg_stat_user_tables
WHERE relid = 'public.orders'::regclass;
预期结果
VACUUM
 relname | n_live_tup | n_dead_tup | last_vacuum | last_autovacuum | last_analyze | last_autoanalyze
 orders  | <VALUE>    | <VALUE>    | <TIME>      | <TIME>          | <TIME>       | <TIME>
时间和计数会随实际负载变化。维护是否成功不能只看 VACUUM 命令返回,还要观察 n_dead_tup 是否回落、查询计划是否使用了更新后的统计信息,以及表和索引大小是否符合预期。
别让长事务挡住回收
VACUUM 只能清理对所有仍可能使用旧快照的事务都已经不可见的行版本。一个持续很久的事务,即使什么都没写,也可能让大批量删除留下的旧版本无法真正回收。
可以先找出当前最老的事务,再决定是等待、终止异常会话,还是把维护延后:
SELECT
    pid,
    usename,
    state,
    xact_start,
    now() - xact_start AS xact_age,
    left(query, 80) AS query
FROM pg_stat_activity
WHERE xact_start IS NOT NULL
ORDER BY xact_start
LIMIT 10;
预期结果
 pid   | usename | state   | xact_start | xact_age | query
 <PID> | <VALUE> | <VALUE> | <TIME>     | <VALUE>  | <VALUE>
实际 PID、时间和 SQL 文本会不同。对生产会话采取终止操作前,应先确认事务来源和业务影响;不要为了“让 VACUUM 立刻生效”直接清理未知连接。
什么时候需要进一步重建
完成 VACUUM (ANALYZE) 后,如果只是死元组下降而文件没有缩小,这是正常现象:普通 VACUUM 的目标是让空间在表内部复用,不是把文件缩回最小值。
只有在索引膨胀已经被测量确认时,才安排 REINDEX CONCURRENTLY;只有在磁盘必须立即回收、并且业务能够接受重写成本和锁影响时,才考虑 VACUUM FULL、CLUSTER 或经过验证的在线整理工具。批量维护应从低成本动作开始,先恢复统计信息和可复用空间,再决定是否值得付出重建代价。