
PostgreSQL / 系统课时
灾难恢复演练
灾难恢复演练
灾难恢复演练的目标不是证明团队“会执行命令”,而是把故障分级、恢复路径、切流验证、回切条件和复盘证据固化成可重复流程。本课以“主库不可用、备库健康”为例,演示如何把一次演练做成可判定、可计时、可复盘的恢复动作。
学习目标
- 按影响范围和数据风险选择恢复路径,而不是遇到故障就直接切换。
- 完成备库状态确认、提升为主库和恢复验证,并记录实际 RTO/RPO 证据。
- 明确回切前提和复盘时间线,避免恢复后再次引入双主或数据分叉。
先把故障分级和恢复路径写死
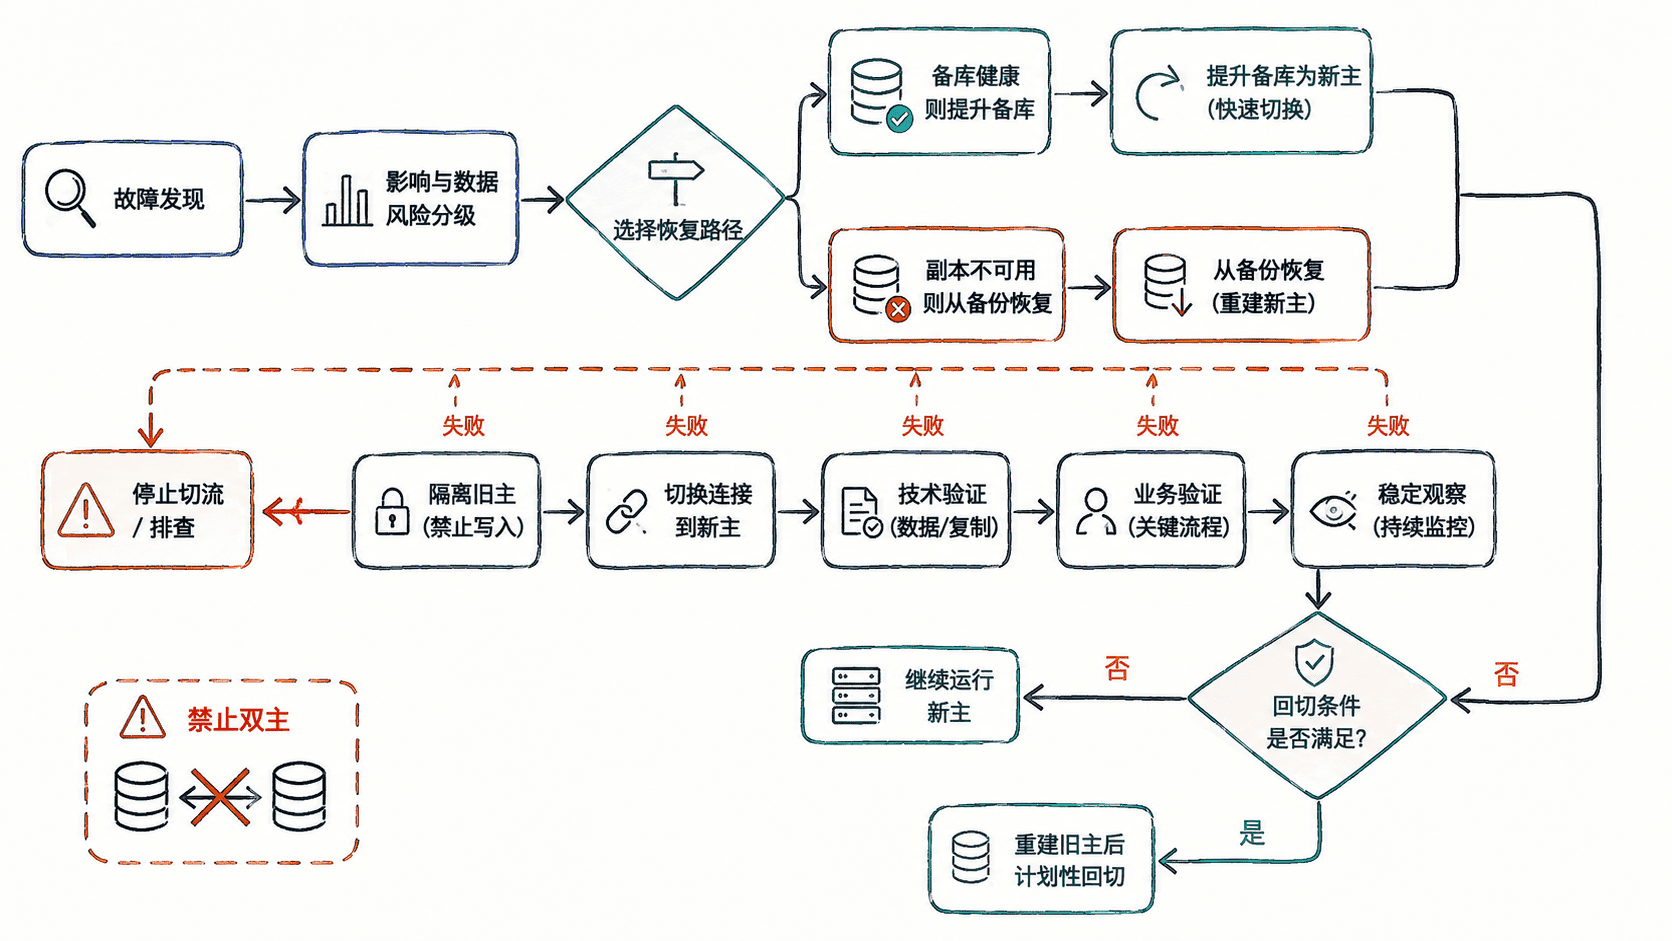
演练脚本至少要区分三类情况:单实例故障但数据仍可访问、主库不可用而备库健康、整站点或数据集不可用。它们对应的动作可能分别是重启或摘流、提升备库、从异地备份或跨站副本恢复。分级的价值是避免在压力下临时发明恢复方案。
演练前固定角色、红线和计时点
开始前要明确谁负责宣布故障等级、谁执行数据库操作、谁切换流量、谁做业务验收,以及谁有权中止演练。计时点至少包含故障开始、恢复决策、数据库可写、应用切流、首个成功业务请求和宣布稳定,这些时间用于计算实际 RTO。
以“主库不可用、备库健康”为例
先连接候选备库,确认它仍处于恢复状态,并记录最后回放位置和时间。pg_last_xact_replay_timestamp() 在没有新事务可回放时可能保持旧时间,因此它是线索,不应单独当作精确复制延迟。
SELECT pg_is_in_recovery() AS in_recovery,
       pg_last_wal_replay_lsn() AS replay_lsn,
       pg_last_xact_replay_timestamp() AS last_replay_time;
预期结果
 in_recovery | replay_lsn |    last_replay_time
-------------+------------+------------------------
 t           | <VALUE>    | <TIME>
确认旧主已隔离、候选备库状态符合演练要求后,可以在备库上执行提升,并立即验证它已退出恢复状态。
SELECT pg_promote(true, 60) AS promoted;
SELECT pg_is_in_recovery() AS in_recovery;
预期结果
 promoted
----------
 t

 in_recovery
-------------
 f
pg_promote 返回 t 表示提升已在等待窗口内完成;随后 pg_is_in_recovery() 返回 f,说明该实例已成为可写主库。之后再按平台既定方式切换连接池、服务发现或代理路由,并执行技术与业务验收。
恢复完成后再决定是否回切
恢复成功后不要急着把流量切回旧主。回切前至少满足四个条件:新主写入稳定、旧主已经以新主为源重新同步或重建、关键业务校验通过、连接与监控链路都已验证。原主若曾脱离复制继续运行,必须先消除时间线分叉风险,不能直接重新开放写流量。
对大多数事故,最安全的做法是先让提升后的新主持续承载业务,再把旧主重建为它的备库。只有在容量、网络、合规或站点策略确实要求恢复原拓扑时,才安排一次新的计划性切换,而不是把“回切”当成灾难恢复步骤的默认结尾。
用时间线和证据完成复盘
复盘记录不要只写“切换成功”。应保留故障等级、触发条件、每个关键时间点、实际恢复路径、最后可确认的数据位置、技术验证结果、业务抽查结果、是否触发中止条件,以及每一步由谁决策和执行。
RTO 应以“业务真正恢复到可接受服务水平”的时间点计算,而不是数据库进程启动时间;RPO 则要根据实际可恢复或已回放的数据位置判断。演练结束后的改进项必须能回写到 runbook、监控告警、备份策略或自动化脚本中,这样下一次演练才能验证改进是否真的有效。