
消息队列 / 系统课时
压测、故障演练与验收
压测、故障演练与验收
本课用可重复的压测和故障注入验证订单事件平台是否扛得住峰值、能否在 Broker、消费者或下游异常后恢复。重点不是制造“高吞吐数字”,而是得到容量上限、实际恢复时间和事件是否完整的验收证据。
学习目标
- 建立包含吞吐、延迟、积压和错误率的峰值压测基线
- 演练 Broker 故障、消费者重启和下游超时并记录恢复过程
- 用容量目标、RTO、RPO 和事件对账结果做最终验收
先定义验收口径
压测前先固定数据规模、事件大小、分区数、生产者确认级别、消费者实例数和下游响应模型。否则每次结果都在不同条件下产生,吞吐数字没有可比性。
验收至少记录四类结果:稳定吞吐是否达到目标峰值;p95/p99 处理耗时是否在 SLO 内;故障后 lag 是否能在目标时间内回落;所有已接受事件是否最终出现在成功结果或 DLQ 中。若业务要求 RPO=0,必须按唯一 eventId 对账,而不是只比较总计数。
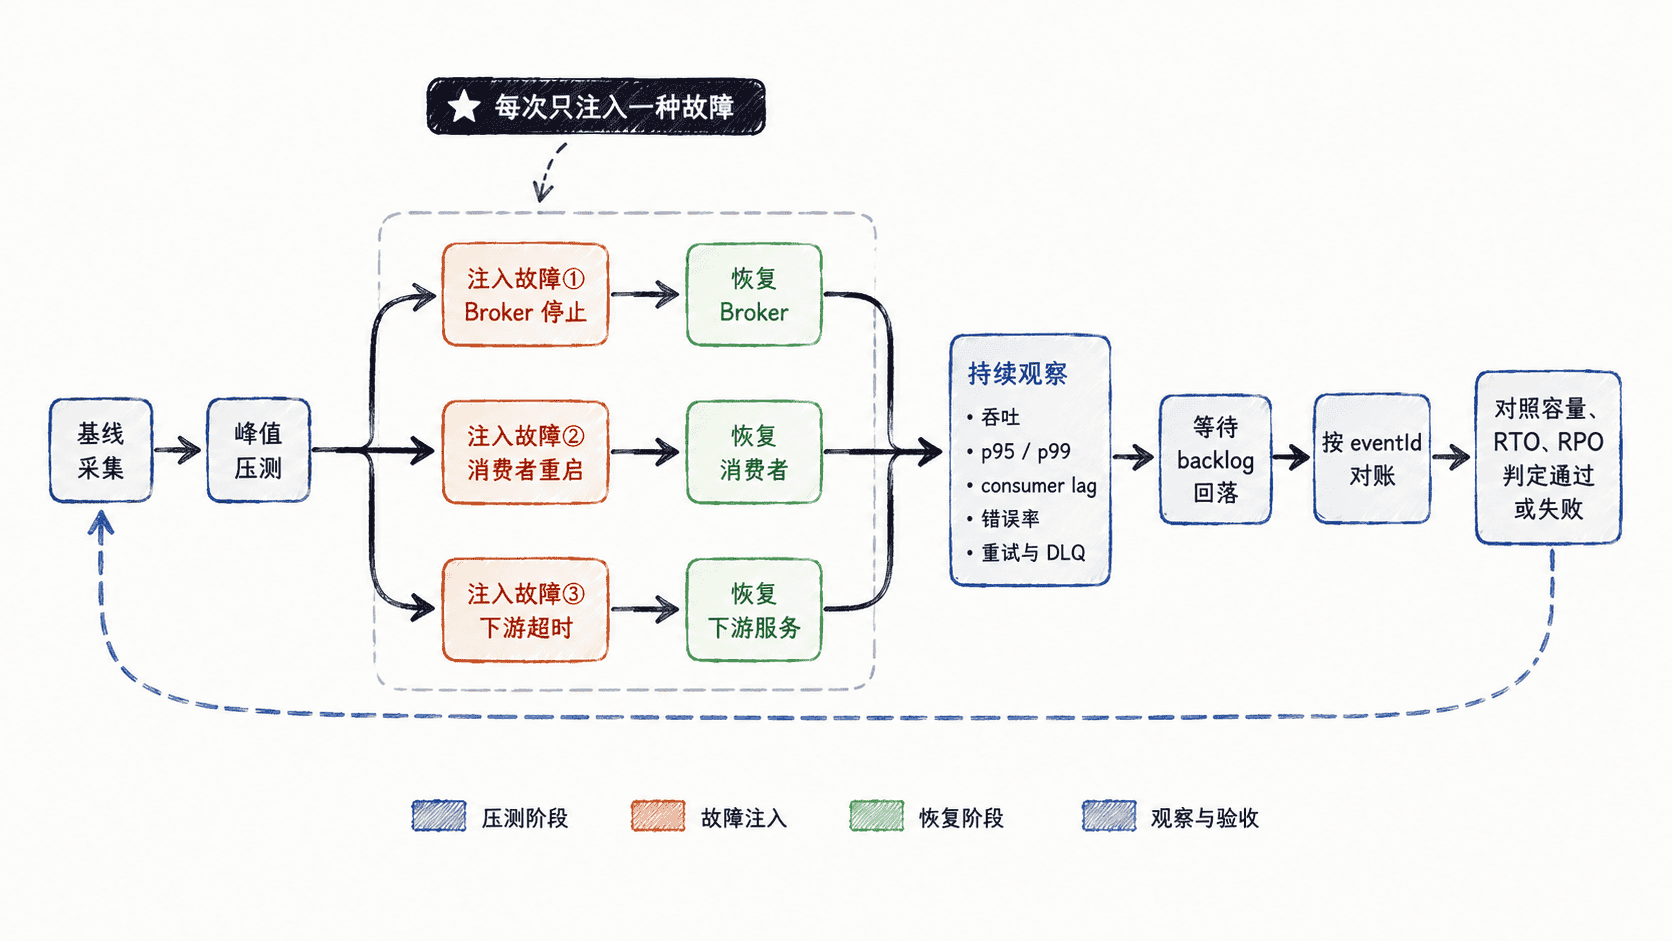
用峰值压测建立容量基线
先测 Kafka 消息层,确认 Broker 与生产链路的基础容量,再叠加业务消费者。Kafka 自带的生产压测工具适合做可重复基线;<PORT>、<VALUE> 需要替换成测试环境的实际值。
bin/kafka-producer-perf-test.sh \
  --topic order-events \
  --num-records <VALUE> \
  --record-size 512 \
  --throughput <VALUE> \
  --producer-props \
  bootstrap.servers=localhost:<PORT> \
  acks=all \
  enable.idempotence=true
预期输出
<VALUE> records sent, <VALUE> records/sec (<VALUE> MB/sec), <VALUE> ms avg latency, <VALUE> ms max latency持续压测期间同步观察消费者 lag、处理 p95/p99、错误率、CPU、堆内存和 GC。不要只取工具最后一行的平均值:如果吞吐达标但 lag 持续线性增长,说明系统只是把压力转移到了消费者端,并没有真正达到稳定容量。
容量结果建议记录“最高可持续吞吐”,而不是瞬时峰值。可持续意味着在固定窗口内吞吐稳定、错误率可接受、lag 不持续增长,并且测试结束后 backlog 能在约定时间内回落。
演练 Broker 故障与消费者重启
Broker 故障前先确认订单主题有足够副本并处于 ISR。下面命令只用于演练环境,容器化部署示例假定 Compose 文件中包含多个 Broker 服务。
docker compose -f <PATH> stop kafka-2预期输出
[+] Stopping 1/1
 ✔ Container <VALUE>  Stopped
保持压测流量不变,记录故障发生时间 <TIME>,观察生产错误、leader 切换、消费 lag 和吞吐下降幅度。若主题副本数与 min.insync.replicas 设计允许单 Broker 故障,系统应在短暂抖动后继续写入;若写入完全中断,应检查副本与 ISR 配置,而不是简单提高重试次数。
恢复 Broker 后再验证副本重新进入 ISR。
docker compose -f <PATH> start kafka-2预期输出
[+] Running 1/1
 ✔ Container <VALUE>  Started
消费者重启要验证的是“处理可恢复且不会丢失已接受事件”。在稳定压力下重启一个消费者实例:
docker compose -f <PATH> restart <VALUE>预期输出
[+] Restarting 1/1
 ✔ Container <VALUE>  Started
记录 rebalance 开始与恢复消费的时间,检查 lag 是否短暂上升后回落,同时核对重复处理是否被幂等逻辑吸收。若重启后频繁 rebalance,应优先检查处理时长、max.poll.interval.ms、实例健康状态和下游阻塞,而不是盲目增加消费者数量。
注入下游超时
下游超时最容易把单点故障放大成重试风暴。演练环境可以让订单消费者通过 Toxiproxy 访问下游,再注入固定超时;不要在生产环境直接执行故障注入。
toxiproxy-cli toxic add downstream-api \
  -n order-timeout \
  -t timeout \
  -a timeout=3000
预期输出
Added downstream toxic 'order-timeout' on proxy 'downstream-api'故障存在期间,应重点观察处理耗时、线程占用、重试速率、lag 与 DLQ。如果下游超时 3 秒,而消费者一次处理会连续重试多次,单条事件可能长期占用消费线程;这时应验证超时、退避、最大重试次数和死信策略是否共同限制了故障放大。
完成观察后移除故障。
toxiproxy-cli toxic remove downstream-api -n order-timeout预期输出
Removed toxic 'order-timeout' from proxy 'downstream-api'移除后记录 lag 回到基线阈值的时间,这个间隔就是本次场景可直接测得的恢复时间证据。
用 RTO、RPO 和对账做最终验收
RTO 不是“服务进程重新启动”的时间,而是从故障发生到业务处理能力恢复、backlog 回到可接受范围的时间。RPO 则回答故障期间允许丢失多少已经被系统接受的事件。对于要求 RPO=0 的订单事件,验收应按 eventId 做集合级对账。
可以把结果压缩成下面的验收表,阈值由项目 SLO 填入,而不是照搬示例环境的数据。
| 项目 | 实测值 | 目标 | 通过条件 |
|---|---|---|---|
| 最高可持续吞吐 | <VALUE> msg/s |
<VALUE> msg/s |
实测不低于目标且 lag 不持续增长 |
| p95 处理耗时 | <VALUE> ms |
<VALUE> ms |
不高于目标 |
| Broker 故障 RTO | <VALUE> s |
<VALUE> s |
不高于目标 |
| 消费者重启 RTO | <VALUE> s |
<VALUE> s |
不高于目标 |
| 下游超时恢复时间 | <VALUE> s |
<VALUE> s |
不高于目标 |
| 未对账事件数 | <VALUE> |
0 或业务 RPO |
不超过允许值 |
最终只在三类证据同时成立时验收通过:峰值负载下系统能稳定运行;三种故障都能在目标时间内恢复;所有已接受事件都能在成功结果或 DLQ 中找到归宿。若其中任何一项失败,应保留同一组压测参数,修复后原条件复测,避免通过降低压力来“修复”验收结果。