
消息队列 / 系统课时
转换与错误处理
转换与错误处理
Kafka Connect 的数据治理关键不在“把错误吞掉”,而在明确每条记录经过 Converter、Schema、SMT 和 Connector 时可能在哪一层失败,并把可跳过的脏数据隔离到死信队列。完成本节后,你可以为一个 Sink Connector 设计可追踪、可回放的错误处理链路。
学习目标
- 区分 Converter、Schema 与 Single Message Transform 的职责边界
- 配置错误重试、容忍策略和死信队列,并保留失败上下文
- 判断哪些错误应该跳过,哪些错误必须让任务失败
先分清数据经过的四个层次
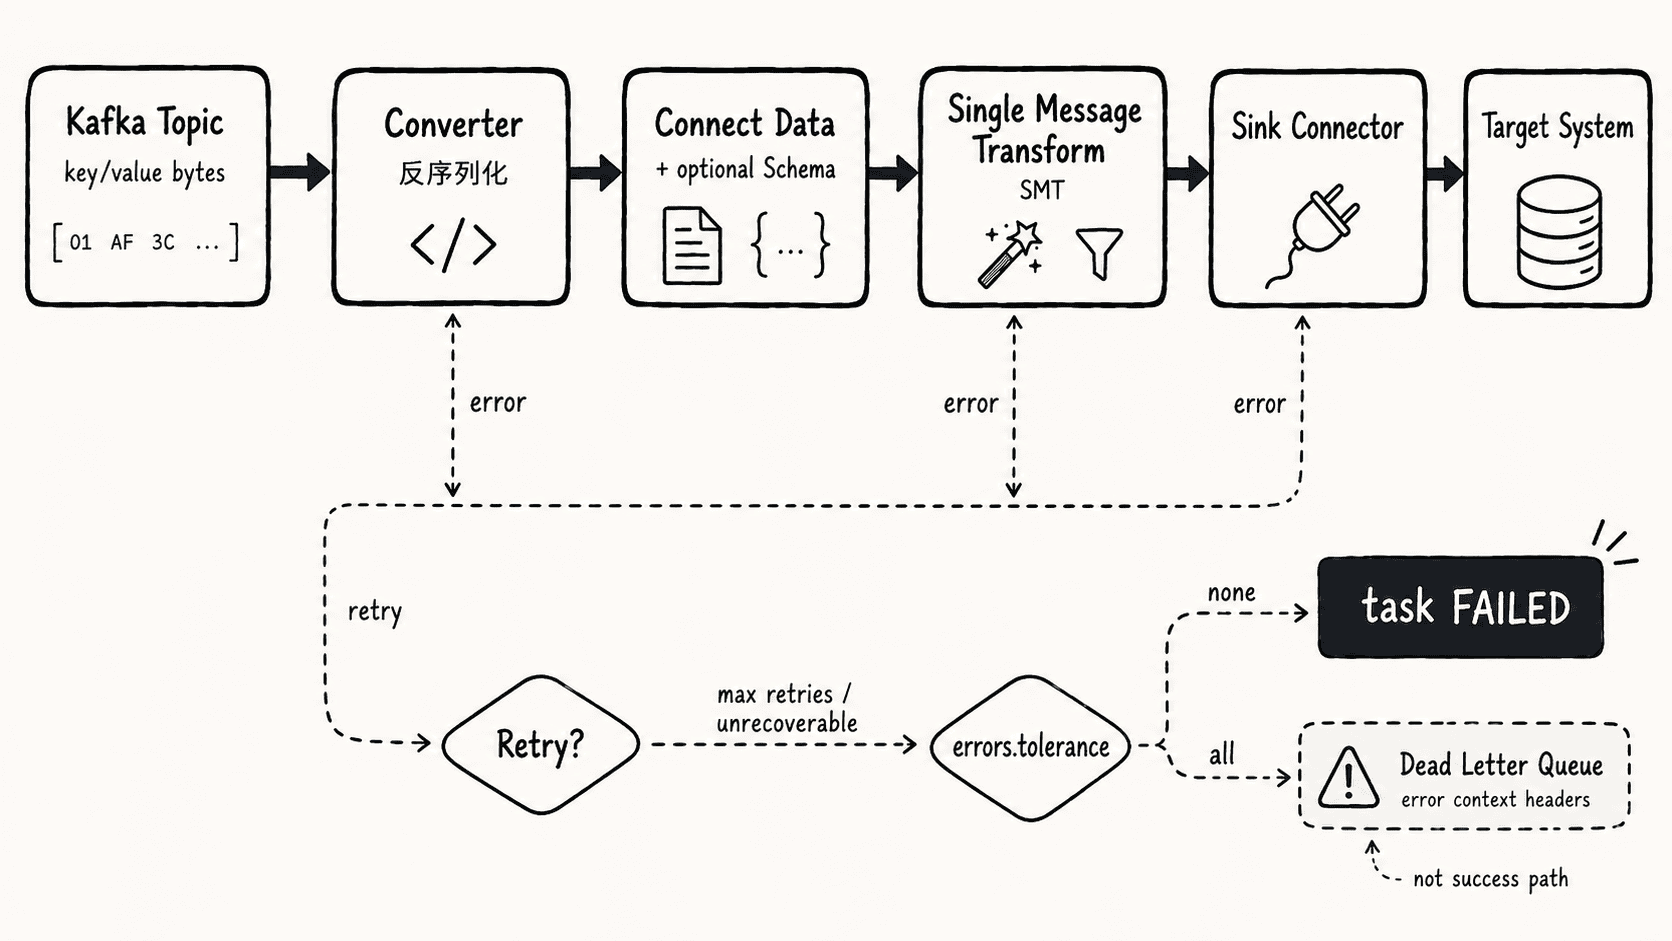
对 Sink Connector 来说,Kafka 中保存的是字节。Worker 先用 key.converter 和 value.converter 把字节反序列化成 Connect Data,再交给 SMT 做单条记录级转换,最后由 Connector 写入目标系统。Schema 决定字段名、类型、可空性等结构约束,它不是另一种转换器。
Converter 失败通常意味着字节格式与配置不匹配,例如把普通 JSON 当成“带 Connect Schema 的 JSON”解析。SMT 失败则常见于字段不存在、类型不兼容或转换器产出的结构不符合预期。Connector 阶段还可能出现数据库约束、远端 API 或网络错误。
配置 Converter、SMT 与 DLQ
下面是一个 Sink Connector 的配置片段示例,需要并入你实际 Connector 的完整配置。这里使用 JsonConverter 并启用 Schema,同时用 InsertField SMT 给每条记录补充来源字段;错误处理允许跳过坏记录,并把它们写入专用 DLQ。
{
  "key.converter": "org.apache.kafka.connect.storage.StringConverter",
  "value.converter": "org.apache.kafka.connect.json.JsonConverter",
  "value.converter.schemas.enable": "true",
  "transforms": "addSource",
  "transforms.addSource.type": "org.apache.kafka.connect.transforms.InsertField$Value",
  "transforms.addSource.static.field": "source_system",
  "transforms.addSource.static.value": "orders",
  "errors.retry.timeout": "60000",
  "errors.retry.delay.max.ms": "5000",
  "errors.tolerance": "all",
  "errors.deadletterqueue.topic.name": "connect-dlq",
  "errors.deadletterqueue.context.headers.enable": "true",
  "errors.log.enable": "true",
  "errors.log.include.messages": "false"
}
这段配置生效后,结构正确的记录会在写入目标系统前增加 source_system=orders;可被 Connect 错误处理框架捕获且最终仍失败的记录会进入 connect-dlq。验证时应同时检查 Connector 状态、目标端写入结果和 DLQ,而不能只看任务是否为 RUNNING。
用 Schema 把脏数据提前暴露
启用 Schema 后,字段类型和可空性会成为处理契约。它能让下游在更靠前的位置发现类型漂移,例如本应是整数的 amount 突然变成字符串。代价是生产者必须按 Converter 期望的格式提供 Schema 信息;格式不一致时,记录甚至无法进入 SMT。
如果上游发送的是普通 JSON,而 Connector 却配置了 value.converter.schemas.enable=true,这是典型的“格式与 Converter 约定不一致”。不要靠 errors.tolerance=all 长期掩盖这类系统性问题,应统一生产格式或调整 Converter 配置。
设计可回放的死信队列
DLQ 应被当作隔离区,而不是垃圾桶。至少要保留原始记录、错误上下文和可定位来源的信息,并为 DLQ 设置独立的保留期、访问权限和监控。errors.deadletterqueue.context.headers.enable=true 会把异常类、异常消息以及出错阶段等上下文写入 Headers,便于后续分类处理。
治理脏数据时可以按“可修复”和“不可修复”拆分:字段格式错误通常可在修正后重放;业务语义错误则应进入人工或业务规则处理流程。重放前必须确认目标端写入是否幂等,否则同一条消息可能造成重复副作用。
验证错误处理是否真的有效
假设 Connect REST API 监听在 <PORT>,可以先确认任务状态:
curl -s http://localhost:<PORT>/connectors/orders-sink/status预期输出中应看到 Connector 和 Task 的状态;实际 worker_id、Task 数量等值可能不同:
{
  "name": "orders-sink",
  "connector": {
    "state": "RUNNING",
    "worker_id": "<ID>"
  },
  "tasks": [
    {
      "id": 0,
      "state": "RUNNING",
      "worker_id": "<ID>"
    }
  ],
  "type": "sink"
}
状态为 RUNNING 只证明任务还活着。真正的验收应再构造一条符合 Schema 的正常记录和一条确定会失败的脏记录:前者必须到达目标系统,后者必须进入 DLQ,并能从 Headers 中定位失败阶段。只有这三项同时成立,错误容忍才算可观测、可追踪、可恢复。