
消息队列 / 系统课时
故障演练与恢复预案
故障演练与恢复预案
本课把 Kafka 故障处理从“知道该怎么办”变成可验证的演练流程。你将用节点宕机、网络抖动、磁盘高水位和消费者停顿四类场景,检查告警是否及时、业务是否能切换、恢复后副本与消费进度是否回到健康状态。
学习目标
- 为四类常见故障设计可控、可回滚的注入方式
- 按“告警—影响—切换—恢复—验证”顺序执行演练
- 用主题、副本和消费组指标判定恢复是否真正完成
先建立演练基线
故障注入前先固定观察对象,否则演练结束后很难判断“恢复”是不是只恢复了进程。至少记录测试 Topic 的分区数、副本因子、Leader/ISR,以及目标消费组的 Lag。演练只应在隔离测试环境或经过变更审批的预生产环境执行。
下面用一个 3 Broker 测试集群创建演练 Topic,并输出副本基线。命令假设 Kafka CLI 已加入 PATH,BOOTSTRAP 可按环境覆盖。
set -euo pipefail
BOOTSTRAP="${BOOTSTRAP:-localhost:9092}"
TOPIC="${TOPIC:-drill-topic}"

kafka-topics.sh --bootstrap-server "$BOOTSTRAP" --create --if-not-exists --topic "$TOPIC" --partitions 3 --replication-factor 3
kafka-topics.sh --bootstrap-server "$BOOTSTRAP" --describe --topic "$TOPIC"
预期输出
Topic: drill-topic  PartitionCount: 3  ReplicationFactor: 3
Topic: drill-topic  Partition: 0  Leader: <ID>  Replicas: <ID>,<ID>,<ID>  Isr: <ID>,<ID>,<ID>
...
Broker ID、Leader 分布和附加配置会因环境不同而变化;关键基线是每个分区都存在 Leader,且 ISR 数量与副本因子一致。
四类故障分别验证什么
| 场景 | 推荐注入方式 | 重点告警 | 恢复完成条件 |
|---|---|---|---|
| Broker 节点宕机 | 停止单个 Broker 容器或进程 | Broker 不可达、Leader 变化、ISR 收缩 | Broker 回归,所有目标分区 ISR 恢复 |
| 网络抖动 | 在单节点网络命名空间加入延迟、丢包 | 请求延迟、超时、重试、ISR 波动 | 网络规则移除,延迟回落,副本同步 |
| 磁盘高水位 | 使用独立小容量测试卷或配额提升使用率 | 磁盘使用率、日志目录异常、写入失败风险 | 空间释放或扩容,日志目录可写,副本健康 |
| 消费者停顿 | 暂停或停止一个消费实例 | Consumer Lag 持续上升 | 实例恢复,Lag 持续下降并回到基线 |
同一轮演练只注入一种主故障。多故障叠加虽然更接近极端事故,但会增加因果判断难度,应该放在单故障流程已经稳定之后。
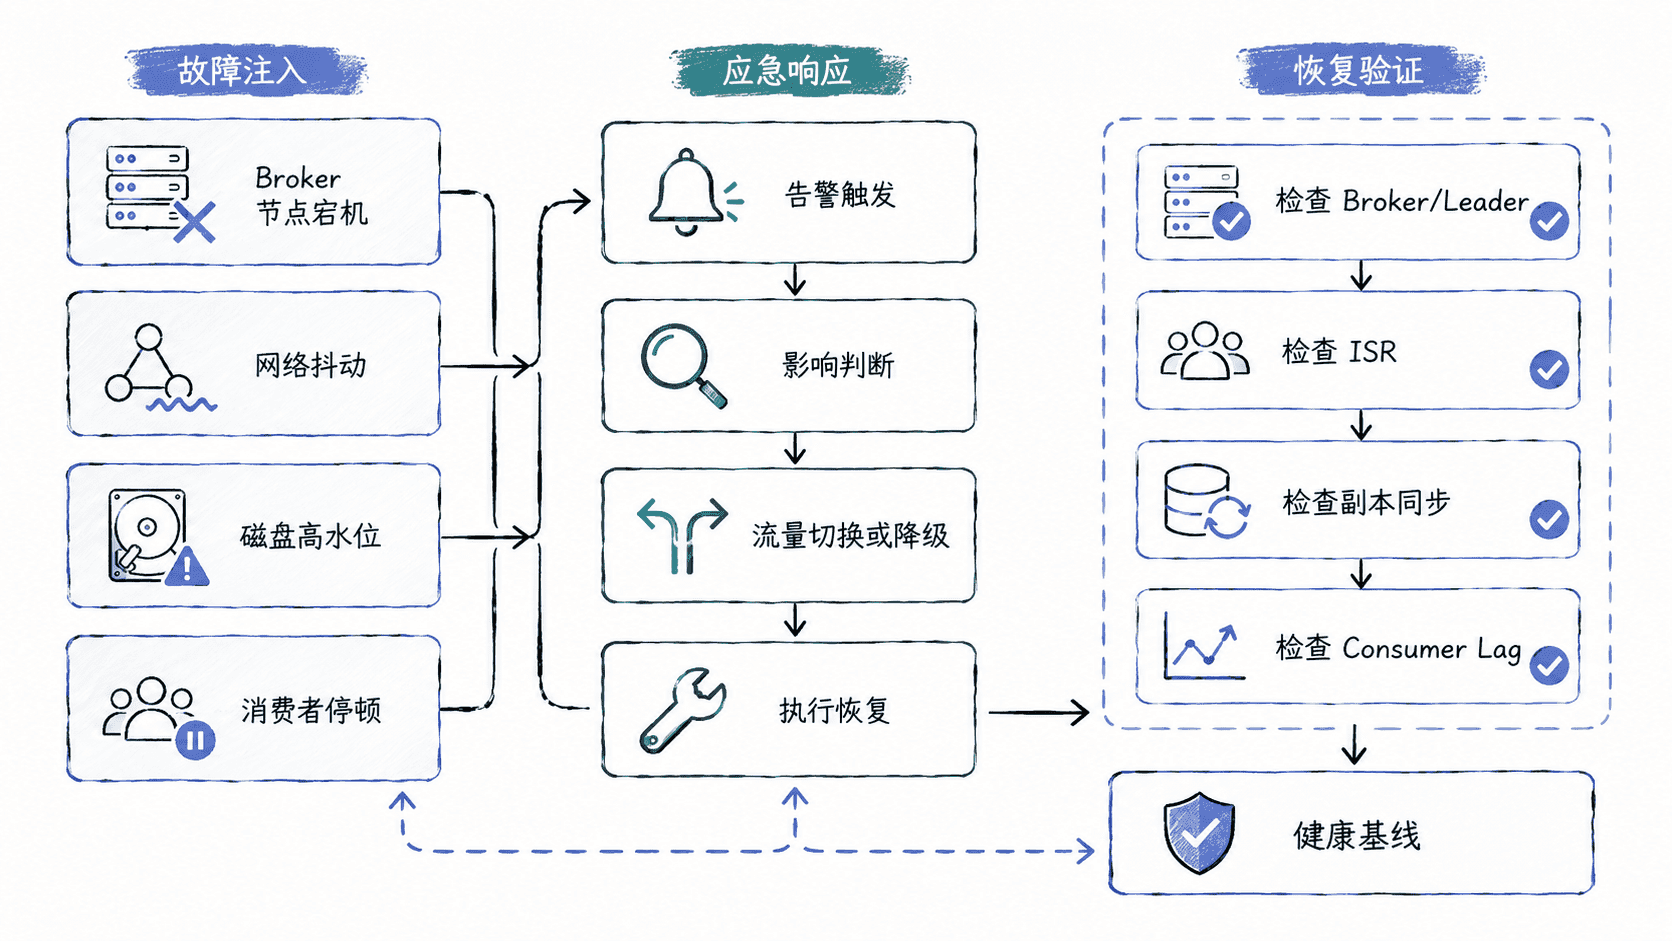
按固定顺序执行而不是临场发挥
每个场景都按同一控制面执行:先确认基线正常,再注入故障;只要达到预设终止条件就立即回滚。终止条件应提前写进预案,例如“出现不可用分区”“磁盘剩余空间低于安全下限”或“业务错误率超过阈值”,避免为了完成演练而扩大事故面。
恢复时不要只看进程重新启动。Broker 回归后要等待副本追平并重新进入 ISR;网络恢复后要确认请求延迟和重试率回落;磁盘处理后要确认日志目录恢复可写;消费者恢复后要观察 Lag 是持续下降,而不是只停止增长。
用同一组命令做恢复验收
故障回滚后重新检查 Topic 副本状态,并查看目标消费组。下面的命令把两个最重要的验收面放在一起。
set -euo pipefail
BOOTSTRAP="${BOOTSTRAP:-localhost:9092}"
TOPIC="${TOPIC:-drill-topic}"
GROUP="${GROUP:-drill-consumer}"

kafka-topics.sh --bootstrap-server "$BOOTSTRAP" --describe --topic "$TOPIC"
kafka-consumer-groups.sh --bootstrap-server "$BOOTSTRAP" --describe --group "$GROUP"
预期结果
Topic: drill-topic  Partition: <ID>  Leader: <ID>  Replicas: <ID>,<ID>,<ID>  Isr: <ID>,<ID>,<ID>
GROUP            TOPIC        PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG
drill-consumer   drill-topic  <ID>       <VALUE>         <VALUE>         <VALUE>
验收时重点看两个趋势:目标分区的 ISR 应恢复到预期副本数,消费组 Lag 应在消费者恢复后持续下降。如果 Broker 已启动但 ISR 长时间不全,或消费者进程正常但 Lag 不下降,恢复流程仍未结束。
把结果沉淀成可执行预案
一次有效演练至少留下四类记录:故障注入时间、首个有效告警时间、完成切换或止损的时间、恢复到健康基线的时间。把每个阶段的负责人、回滚动作和终止条件写进预案,并记录本次演练暴露出的缺口。
最终判断标准不是“故障被制造出来了”,而是团队能在受控范围内发现故障、限制影响、完成恢复,并用 Kafka 自身状态和业务侧指标证明系统已经真正回到可服务状态。