
消息队列 / 系统课时
Kafka 高吞吐设计思路
Kafka 高吞吐设计思路
Kafka 的高吞吐不是来自某个单独的“快”技术,而是把磁盘访问、网络传输、内存缓存和并行执行放在同一条数据路径上优化。本课重点解释五个互相叠加的机制,以及它们为什么能提高吞吐、又分别会带来什么代价。
学习目标
- 解释顺序写盘、批处理、页缓存与零拷贝各自减少了什么开销
- 理解 Partition 如何把单条日志的顺序约束转化为集群并行能力
- 判断提高吞吐时常见的延迟、内存、分区数量与复制成本权衡
高吞吐来自一条连续的数据路径
Producer 不会把每条消息都当成一次独立的磁盘事务处理。更典型的路径是先在客户端聚合批次,再通过网络发送;Broker 接收后按 Partition 追加到日志文件,操作系统利用页缓存吸收大量读写;Consumer 拉取历史数据时,又尽量减少从文件到网络之间的重复复制。
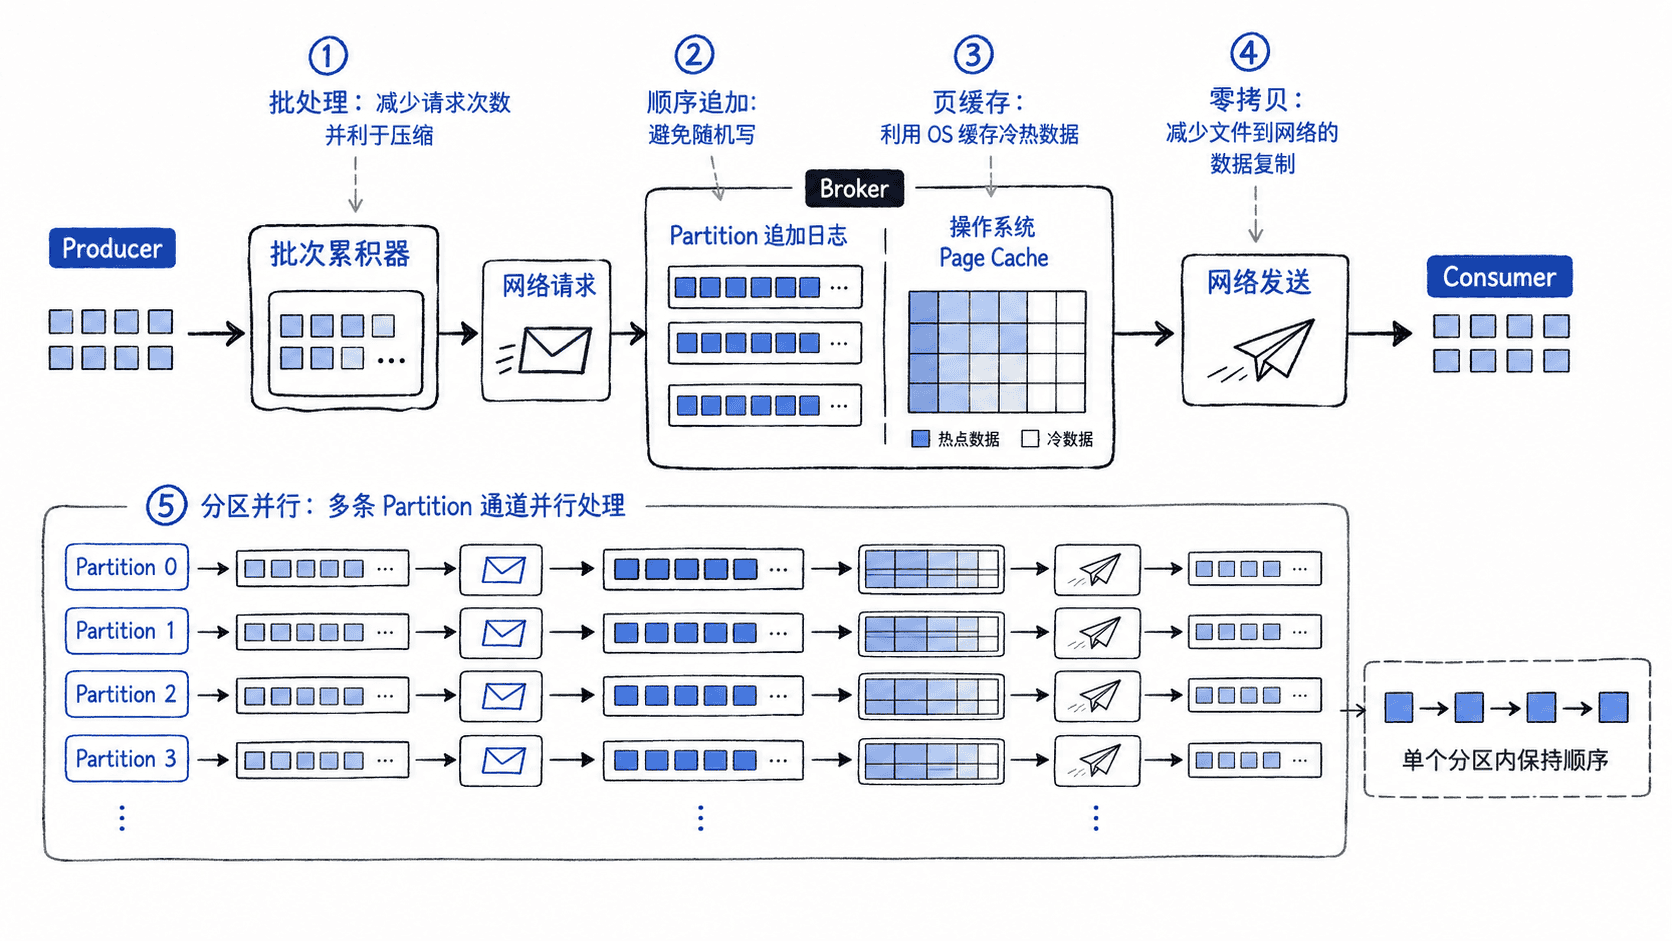
这几个机制不是互相替代的选项。批处理减少“消息次数”带来的固定成本,顺序写盘改善存储访问模式,页缓存减少直接磁盘访问压力,零拷贝优化读取后的传输路径,Partition 则让多条日志可以同时工作。
顺序写盘为什么比想象中快
Kafka 的 Partition 本质上是追加日志。新记录写到日志末尾,不需要像随机更新型存储那样频繁在磁盘不同位置寻找并覆盖数据。连续追加更容易形成较大的顺序 I/O,也更适合操作系统做预读、合并与缓存。
这里的重点不是“磁盘比内存快”,而是访问模式足够友好。即使底层仍然需要持久化,顺序追加也通常比大量随机小写更容易获得稳定吞吐。Kafka 再通过分段日志、批量刷写和复制机制,把持久化工作组织成可连续处理的数据流。
批处理把固定成本摊薄
网络请求、系统调用、协议头和压缩都有固定成本。如果一条记录就发送一次请求,这些固定成本会被重复支付。Producer 会按 Partition 聚合多条记录形成 Record Batch,再把批次一起发送给 Broker。
批次越大,单位消息承担的网络和协议开销通常越低,压缩算法也更容易从同一批记录中找到重复模式。不过批次不是越大越好:等待批次凑满会增加排队时间,客户端也需要占用更多缓冲内存。
因此,高吞吐调优经常是在“更大的 batch”和“可接受的等待延迟”之间取平衡,而不是简单追求最大批次。
页缓存与零拷贝减少数据搬运
Broker 读写日志时会大量利用操作系统 Page Cache。写入可以先进入页缓存,由操作系统按策略刷新到底层存储;近期写入的数据也很可能仍然留在内存中,Consumer 随后读取时就不必再次等待物理磁盘完成完整随机访问。
这种设计还有一个重要效果:Kafka 不需要自己维护一套庞大的对象缓存,从而避免在 JVM 堆中重复保存同一份消息数据。内存更适合交给操作系统统一管理,而 Broker 把重点放在日志组织、复制和请求处理上。
Consumer 读取已落在日志文件中的数据时,传统路径可能需要在内核缓冲区与用户态缓冲区之间多次复制,再从用户态交回内核网络栈。Kafka 在适用路径上利用操作系统能力,让文件数据更直接地进入网络发送流程,从而减少 CPU 复制和上下文切换。
所谓“零拷贝”描述的是减少不必要的数据搬运,不是保证任何环境下都完全没有复制。启用 TLS、需要重新编码或遇到不同平台实现时,实际数据路径可能发生变化,因此它应被理解为一种重要优化路径,而不是绝对承诺。
Partition 把顺序约束变成并行能力
单个 Partition 要保持日志顺序,因此它不适合无限拆分成任意并发写入;Kafka 的做法是让 Topic 拥有多个 Partition。不同 Partition 可以由不同 Broker、不同线程和不同 Consumer 并行处理,于是整个 Topic 的吞吐不再只依赖一条日志。
分区并行也带来边界:更多 Partition 会增加元数据、文件句柄、复制、Leader 管理和消费组重新分配的成本。分区数量过少会限制并行度,过多又会让集群管理成本上升,所以应按目标吞吐、消费者并行度和可接受运维成本一起估算。
设计时要同时看吞吐与代价
| 机制 | 主要收益 | 典型代价或边界 |
|---|---|---|
| 顺序追加 | 提高存储访问连续性 | 单 Partition 仍有顺序边界 |
| 批处理 | 摊薄网络、协议与压缩固定成本 | 批次等待会增加延迟并占用内存 |
| Page Cache | 降低热数据磁盘读取压力 | 不等价于已经完成可靠持久化 |
| 零拷贝 | 减少 CPU 复制与上下文切换 | TLS 等路径可能削弱收益 |
| 分区并行 | 扩展生产与消费并发度 | 分区过多增加元数据和协调成本 |
真正有效的高吞吐设计,是让这些机制在同一条链路上互相配合:Producer 用批次提高传输效率,Broker 用顺序日志和页缓存稳定承接写入,读取路径尽量减少复制,最后再用多个 Partition 横向扩展并行度。任何单项参数脱离端到端链路单独放大,都可能把吞吐问题变成延迟、内存或集群管理问题。