
消息队列 / 系统课时
消费积压监控与定位
消费积压监控与定位
消费积压不是单一故障,而是“写入速度、消费能力、分区分布和下游耗时”失去平衡后的结果。本课用消费组 Lag 作为入口,沿分区和成员分布逐层定位,并根据根因选择恢复策略。
学习目标
- 能读懂消费组的 CURRENT-OFFSET、LOG-END-OFFSET 与 LAG。
- 能区分整体吞吐不足、热点分区、消费者异常和下游瓶颈。
- 能根据 Lag 趋势验证恢复是否真正生效。
先确认 Lag 是否真的在增长
先用 Kafka 自带工具查看消费组。示例假设消费组为 order-worker,Broker 地址为本机 9092;实际环境按部署地址替换。
BOOTSTRAP=127.0.0.1:9092
GROUP=order-worker
kafka-consumer-groups.sh \
  --bootstrap-server "$BOOTSTRAP" \
  --group "$GROUP" \
  --describe
预期输出类似:
GROUP         TOPIC   PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG      CONSUMER-ID  HOST   CLIENT-ID
order-worker  orders  0          <VALUE>         <VALUE>         <VALUE>  <ID>         /<IP>  <ID>
order-worker  orders  1          <VALUE>         <VALUE>         <VALUE>  <ID>         /<IP>  <ID>
其中 LAG = LOG-END-OFFSET - CURRENT-OFFSET。一次快照只能说明“现在积压多少”,不能说明“积压是否恶化”,因此至少要连续观察 Lag、生产速率和消费速率的趋势。
用趋势和分区分布判断根因
如果总 Lag 持续上升,同时消费速率长期低于生产速率,通常是整体处理能力不足;如果只有少数分区上涨,则更像 Key 倾斜、热点分区或某个消费者处理异常。若所有分区突然一起上涨,还要检查消费者是否发生频繁 Rebalance、实例重启或下游依赖超时。
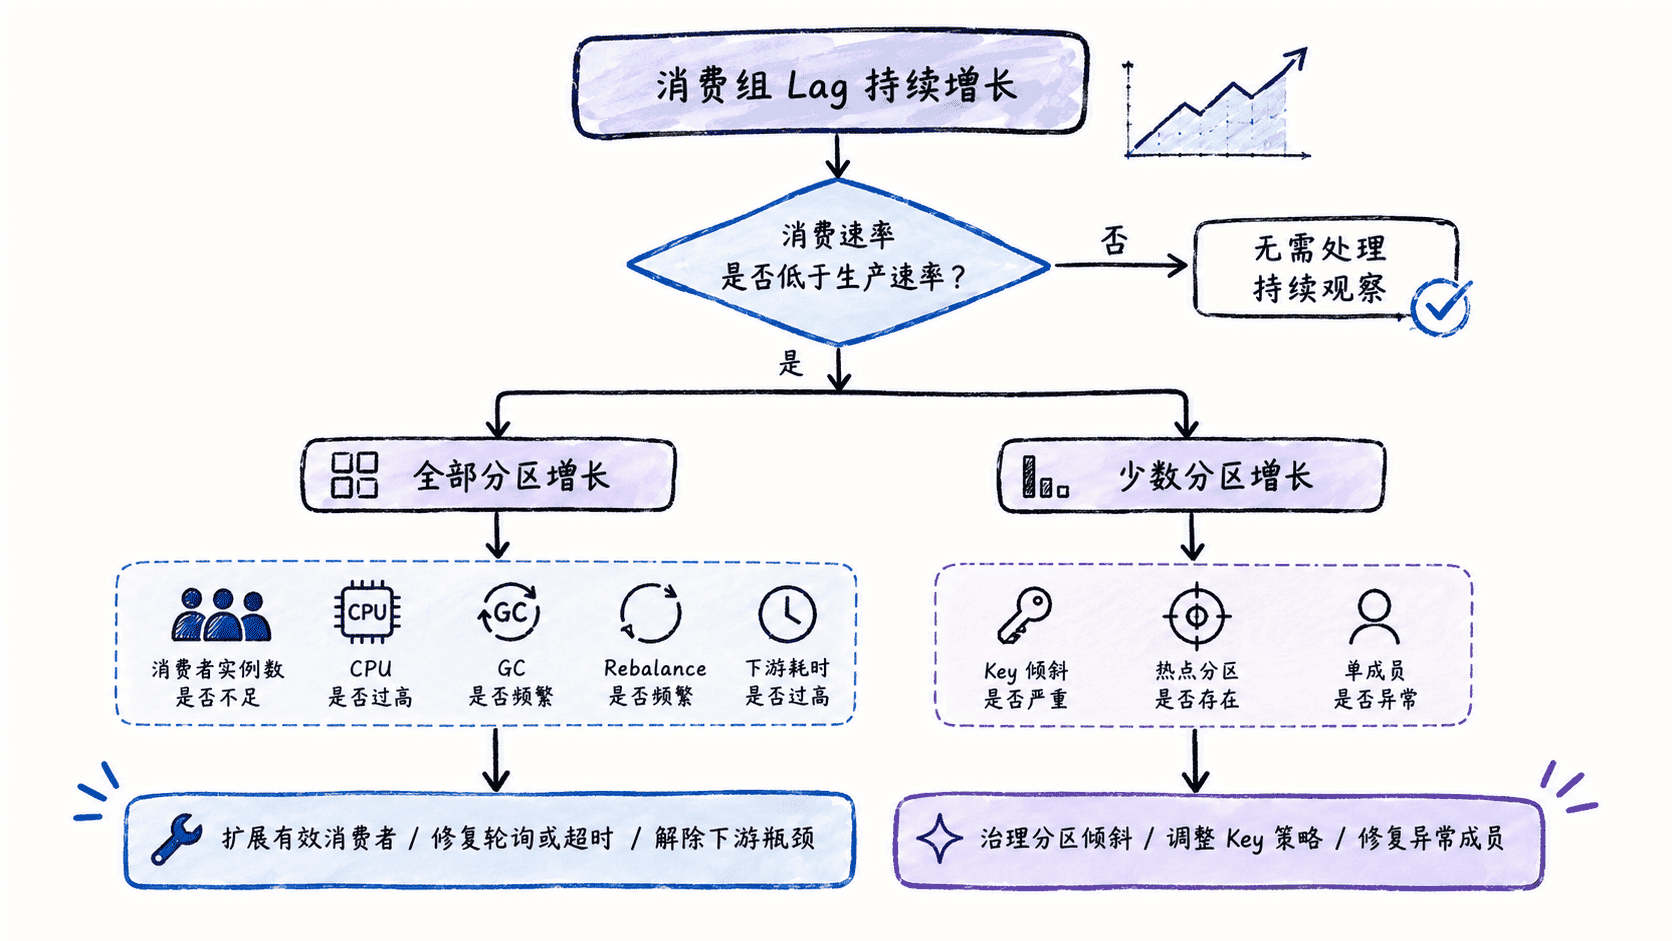
判断时优先比较每个 Partition 的 Lag,而不是只看消费组总和。总 Lag 可能掩盖热点:一个分区持续堆积、其他分区几乎为空时,单纯增加消费者实例并不会改善这个热点分区的处理能力。
把积压分成四类处理
整体吞吐不足:消费者处理稳定,但消费速率长期低于生产速率。先确认分区数是否允许增加并行度,再扩展消费者;同一消费组的有效并行消费者数量通常不会超过可分配分区数。
分区倾斜:少数分区 Lag 明显高于其他分区。检查消息 Key 是否把大量流量固定到少数分区;这种情况应治理 Key 或分区策略,而不是只扩实例。
消费者不稳定:Lag 伴随频繁 Rebalance、实例重启或长时间 Poll。检查处理耗时、max.poll.interval.ms、会话超时以及 GC 暂停,避免业务处理阻塞消费循环。
下游瓶颈:消费者仍在拉取,但数据库、HTTP 服务或磁盘写入变慢。此时盲目扩消费者可能把压力继续放大到下游,应先恢复下游容量或降低单次处理压力。
制定恢复顺序
恢复时先止住 Lag 增长,再追求清零。整体吞吐不足时,提高有效消费并行度或缩短单条处理时间;热点分区时优先修复 Key 分布;消费者不稳定时先消除 Rebalance 和长暂停;下游饱和时先保护依赖系统。
可以用“净排空速率”估算恢复时间:当消费速率稳定高于生产速率后,净排空速率等于两者之差,预计恢复时间约为“当前 Lag ÷ 净排空速率”。如果两者几乎相等,Lag 即使不再增长,也不会很快消失。
验证是否真正恢复
恢复后的正确迹象不是“某一刻 Lag 变小”,而是连续多个观察窗口中总 Lag 呈下降趋势,各分区都在推进,消费速率稳定高于生产速率,同时 Rebalance、错误率和下游延迟没有恶化。
当 Lag 下降到正常基线后,仍应保留一段观察时间。只有积压趋势、成员稳定性、分区分布和下游耗时同时恢复,才能确认问题已经解除,而不是暂时被流量波动掩盖。