
消息队列 / 系统课时
事务消费与隔离级别
事务消费与隔离级别
Kafka 会把事务写入过的记录保留在分区日志里,即使事务最终被中止。消费端若仍使用默认隔离级别,就可能读到这些业务上应当无效的数据。本课用可复现实验说明两种隔离级别、LSO 边界以及生产环境该如何选择。
学习目标
- 区分
read_committed与read_uncommitted的可见记录范围 - 理解打开中的事务为什么会让
read_committed暂时落后 - 配置并验证消费端不会读取已中止事务中的记录
中止记录为什么仍然存在
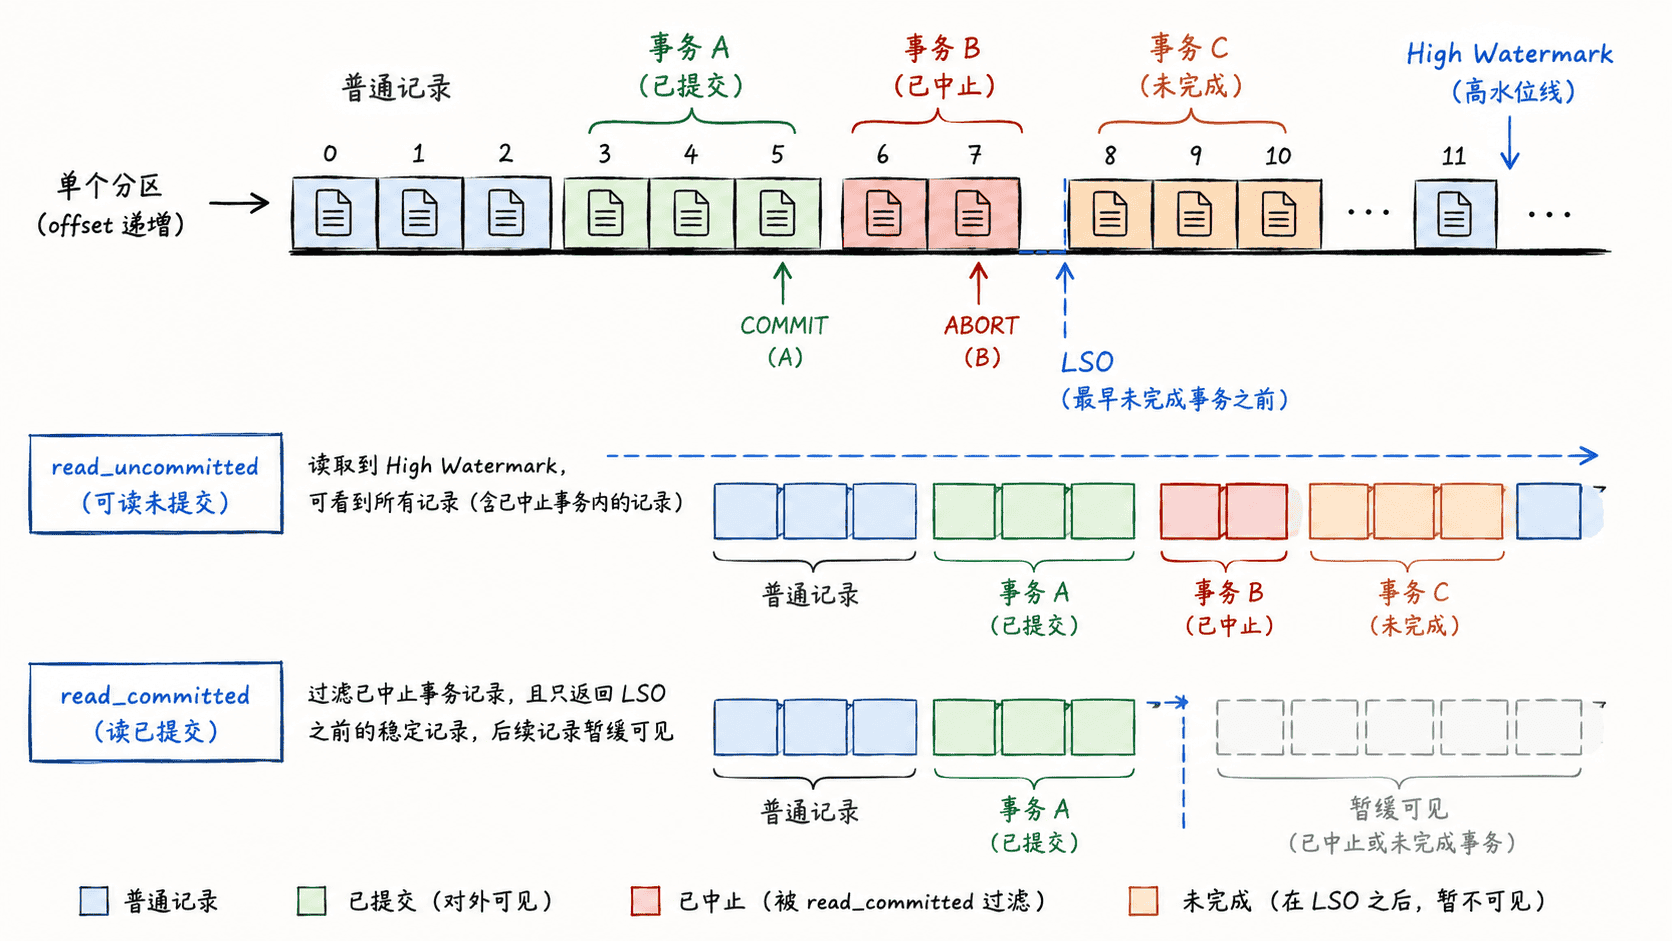
Kafka 的事务不是在中止时把已经追加的数据从日志中物理删除。事务生产者先按正常追加路径写入记录,随后再写入提交或中止控制信息。这样既保持了分区日志顺序,也让消费者能够依据事务状态决定哪些记录可见。
因此,物理存在与业务可见是两件事。非事务记录在两种隔离级别下都可读取;事务记录则要结合事务状态和消费端的 isolation.level 判断。
两个隔离级别的实际差异
read_uncommitted 是普通消费者的默认值。它允许返回所有已经写入并达到高水位线的业务记录,包括后来被事务标记为中止的记录,适合只关心底层日志内容、允许看到未提交数据的诊断场景。
read_committed 只返回非事务记录和已经成功提交事务中的记录,并跳过已中止事务中的业务记录。若分区里存在尚未结束的事务,它还会受 Last Stable Offset(LSO)限制:最早未完成事务之后的记录会暂时等待,即使其中有别的记录已经写到更靠后的 offset。
这意味着监控中看到 read_committed 消费者落后于日志末尾,不一定是消费能力不足,也可能只是存在持续时间较长的打开事务。排查时应同时检查事务持续时间,而不是只看 lag。
用可复现实验验证隔离行为
下面的 Java 程序会创建一个单分区测试主题,依次写入一个已提交事务记录、一个已中止事务记录和另一个已提交事务记录,再用两种隔离级别从头读取。运行环境需要能连接 Kafka,并允许创建副本因子为 1 的测试主题。
import java.time.Duration;
import java.util.ArrayList;
import java.util.List;
import java.util.Properties;
import java.util.UUID;

import org.apache.kafka.clients.admin.Admin;
import org.apache.kafka.clients.admin.AdminClientConfig;
import org.apache.kafka.clients.admin.NewTopic;
import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.apache.kafka.clients.consumer.ConsumerRecord;
import org.apache.kafka.clients.consumer.ConsumerRecords;
import org.apache.kafka.clients.consumer.KafkaConsumer;
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.apache.kafka.clients.producer.ProducerRecord;
import org.apache.kafka.common.TopicPartition;
import org.apache.kafka.common.serialization.StringDeserializer;
import org.apache.kafka.common.serialization.StringSerializer;

public class TxIsolationDemo {
    public static void main(String[] args) throws Exception {
        if (args.length != 1) {
            throw new IllegalArgumentException(
                    "usage: TxIsolationDemo <bootstrapServers>");
        }

        String brokers = args[0];
        String topic = "tx-isolation-" + System.currentTimeMillis();

        Properties adminProps = new Properties();
        adminProps.put(AdminClientConfig.BOOTSTRAP_SERVERS_CONFIG, brokers);
        try (Admin admin = Admin.create(adminProps)) {
            admin.createTopics(List.of(new NewTopic(topic, 1, (short) 1)))
                    .all().get();
        }

        Properties producerProps = new Properties();
        producerProps.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, brokers);
        producerProps.put(ProducerConfig.TRANSACTIONAL_ID_CONFIG,
                "tx-isolation-demo-" + UUID.randomUUID());
        producerProps.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG,
                StringSerializer.class.getName());
        producerProps.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG,
                StringSerializer.class.getName());

        try (KafkaProducer<String, String> producer =
                     new KafkaProducer<>(producerProps)) {
            producer.initTransactions();

            producer.beginTransaction();
            producer.send(new ProducerRecord<>(topic, "k1", "committed-1")).get();
            producer.commitTransaction();

            producer.beginTransaction();
            producer.send(new ProducerRecord<>(topic, "k2", "aborted-1")).get();
            producer.abortTransaction();

            producer.beginTransaction();
            producer.send(new ProducerRecord<>(topic, "k3", "committed-2")).get();
            producer.commitTransaction();
        }

        System.out.println("read_uncommitted="
                + readAll(brokers, topic, "read_uncommitted"));
        System.out.println("read_committed="
                + readAll(brokers, topic, "read_committed"));
    }

    private static List<String> readAll(
            String brokers, String topic, String isolationLevel) {
        Properties props = new Properties();
        props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, brokers);
        props.put(ConsumerConfig.ISOLATION_LEVEL_CONFIG, isolationLevel);

        List<String> values = new ArrayList<>();
        try (KafkaConsumer<String, String> consumer = new KafkaConsumer<>(
                props, new StringDeserializer(), new StringDeserializer())) {
            TopicPartition partition = new TopicPartition(topic, 0);
            consumer.assign(List.of(partition));
            consumer.seekToBeginning(List.of(partition));

            int emptyPolls = 0;
            while (emptyPolls < 2) {
                ConsumerRecords<String, String> records =
                        consumer.poll(Duration.ofMillis(500));
                if (records.isEmpty()) {
                    emptyPolls++;
                    continue;
                }
                emptyPolls = 0;
                for (ConsumerRecord<String, String> record : records) {
                    values.add(record.value());
                }
            }
        }
        return values;
    }
}
预期输出(忽略 Kafka 客户端自身日志):
read_uncommitted=[committed-1, aborted-1, committed-2]
read_committed=[committed-1, committed-2]
实验里两次读取的是同一份分区日志,差异只来自消费隔离级别。生产环境只要下游承担业务处理、计费、状态更新等不能接受脏数据的职责,就应显式配置 isolation.level=read_committed,不要依赖默认值。
别把隔离级别当成完整的恰好一次
read_committed 解决的是“哪些 Kafka 记录可见”,并不会自动让你的业务处理只执行一次。消费者若读到一条已提交记录,处理完业务后进程崩溃,而位移还没有提交,重启后仍可能再次处理它。
另外,enable.auto.commit 控制消费位移是否自动提交,与事务记录是否可见是两个独立维度。需要把“产生结果”和“推进消费位移”绑定成一个原子动作时,还要使用 Kafka 事务把结果消息和位移放进同一事务边界。