
消息队列 / 系统课时
日志段与索引文件
日志段与索引文件
Kafka 并不是把一个分区写进单个无限增长的文件,而是把分区日志切成多个 Log Segment,并用稀疏 Offset Index 与 Time Index 缩小定位范围。本篇从文件关系、活跃段和一次按 offset 查找入手,建立磁盘读写的完整心智模型。
学习目标
- 说清
.log、.index、.timeindex与 segment base offset 的对应关系 - 理解活跃段滚动后为什么才能进入保留、删除或压缩流程
- 能解释 broker 按 offset 或时间戳定位消息时如何减少扫描范围
一个分区为什么要切成多个日志段
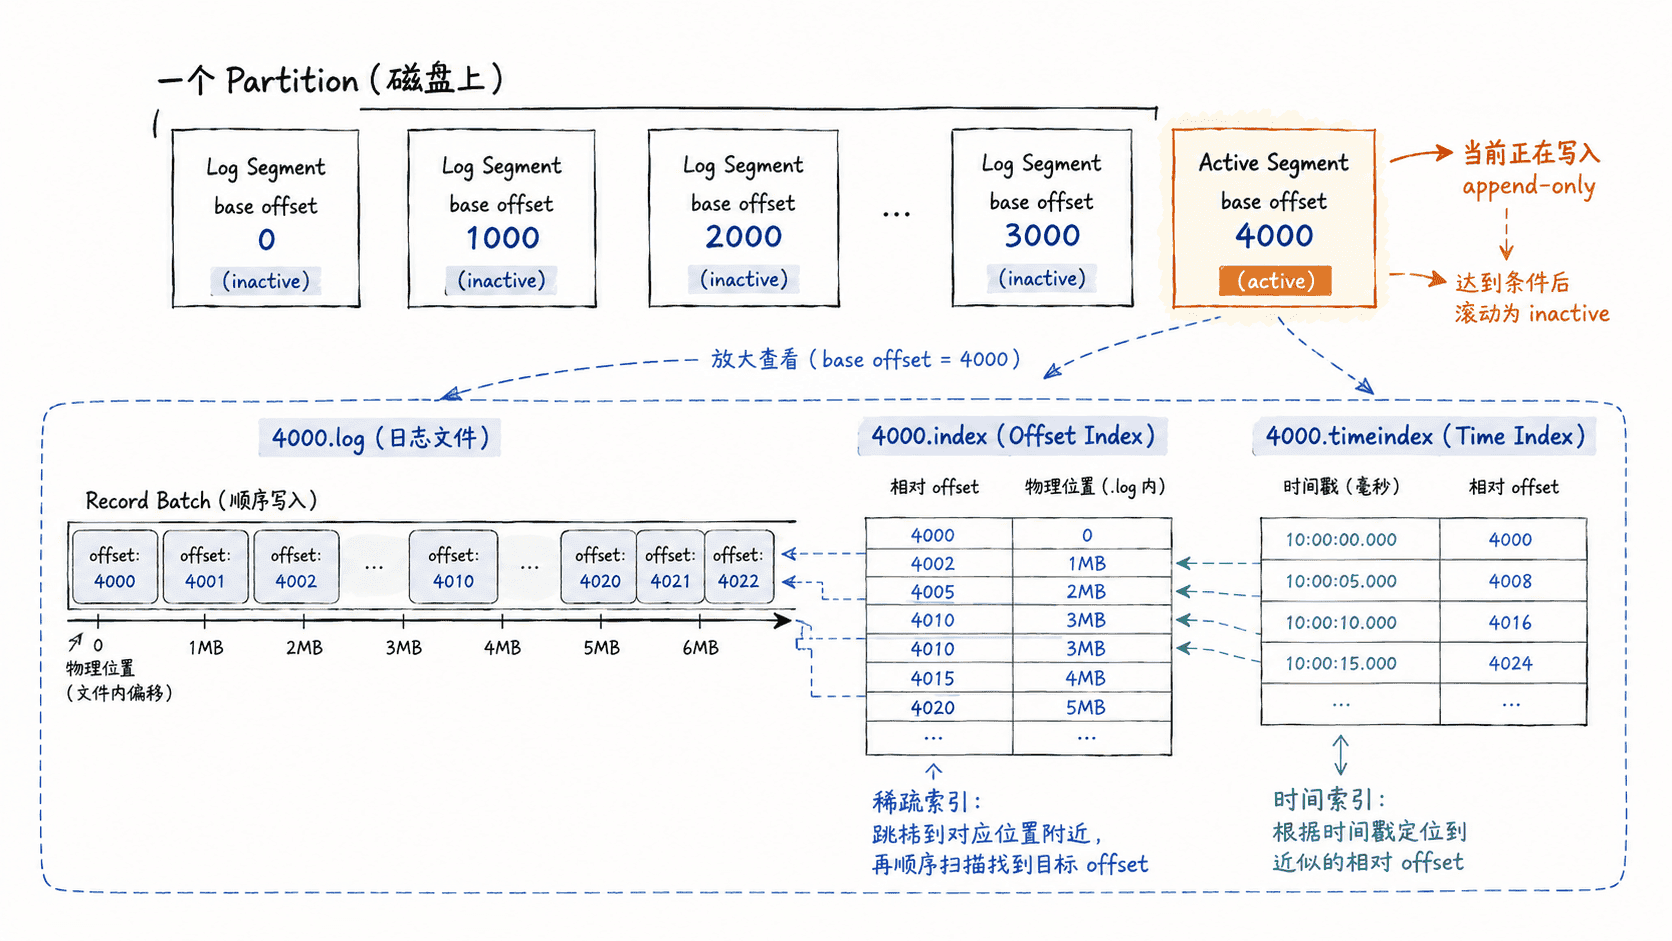
分区仍然是一条按 offset 递增的有序日志,但磁盘上会被拆成多个 segment。每个 segment 以自己的 base offset 命名,同一 base offset 通常对应数据文件、offset 索引和时间索引。例如 00000000000001000000.log 与同名的 .index、.timeindex 属于同一段。
.log 保存真正的 Record Batch;.index 不是“每条消息一行”的完整目录,而是稀疏地记录“相对 offset → 文件物理位置”;.timeindex 则稀疏记录“时间戳 → 相对 offset”。索引越稀疏,文件越小,但定位到近似位置后需要顺序扫描更多数据。
用目录文件观察 segment
如果可以访问 broker 的日志目录,可以直接查看某个 topic-partition 目录。下面的命令只筛选 segment 的三类核心文件;把 <PATH>、<TOPIC> 替换为实际日志目录和主题名。
for f in <PATH>/<TOPIC>-0/*.log <PATH>/<TOPIC>-0/*.index <PATH>/<TOPIC>-0/*.timeindex; do
  [ -e "$f" ] && basename "$f"
done | sort
预期输出示例:
<BASE_OFFSET_1>.index
<BASE_OFFSET_1>.log
<BASE_OFFSET_1>.timeindex
<BASE_OFFSET_2>.index
<BASE_OFFSET_2>.log
<BASE_OFFSET_2>.timeindex
实际 base offset 通常显示为补零后的十进制数字,segment 数量也会随数据量和滚动条件变化。关键不是文件有几组,而是同一组文件共享 base offset,并共同服务于同一段数据。
活跃段如何滚动
每个分区只有最末尾的 segment 处于活跃状态,新 Record Batch 只追加到这个 active segment。达到 segment.bytes,或满足基于时间的滚动条件后,broker 会关闭当前段并创建一个以新 base offset 命名的 segment。
滚动很重要,因为删除保留和日志压缩通常以非活跃 segment为处理对象,而不是在正在追加的文件中随意挖掉记录。因此即使某条消息已经超过 retention.ms,也可能要等它所在的 segment 滚动并满足清理条件后,磁盘文件才真正被删除。
broker 如何按 offset 找到消息
假设消费者请求 offset 1054321。broker 不会从分区开头顺序扫描,而是先选择“base offset 不大于目标值且最接近目标值”的 segment,再在该段的 Offset Index 中查找最接近目标 offset 的索引项。
索引项只能把读取位置缩小到一个附近范围,因此 broker 接着从 .log 的对应物理位置顺序读取 Record Batch,直到找到目标 offset 或确认它不在该段。这个设计把“全量随机查找”变成了“小索引定位 + 局部顺序读”,更符合磁盘和页缓存的访问特性。
按时间戳查询时思路类似:Time Index 先把目标时间缩小到附近的 offset,再结合日志内容确认具体位置。它不是第二套消息存储,而是为“按时间找 offset”提供稀疏导航。
容易混淆的边界
.index 和 .timeindex 都不是消息副本,真正的数据仍在 .log。索引损坏时可以依据日志重建,因此不要把索引文件理解成独立事实来源。
活跃段也不是特殊格式,它只是当前仍在追加的最后一个 segment。理解“分区有序日志 → 多个 segment → 每段三类文件 → 稀疏定位后顺序扫描”这条链路,就能解释 Kafka 为什么既保持追加写,又能在大日志中较快定位消息。