
消息队列 / 系统课时
Consumer Poll 循环
Consumer Poll 循环
Kafka Consumer 的核心不是“收到一条消息就结束”,而是持续执行订阅、拉取、反序列化、业务处理与再次 poll() 的循环。本课用一个可运行的 Java 示例串起完整路径,并说明为什么 KafkaConsumer 通常只能由单一线程驱动。
学习目标
- 说清
subscribe()、poll()、反序列化与业务处理之间的执行关系 - 写出一个可持续运行并能正常退出的 Consumer Poll 循环
- 理解
KafkaConsumer的线程约束以及耗时处理对消费稳定性的影响
Poll 循环在做什么
调用 subscribe() 只是声明“我要消费哪些主题”,真正开始加入消费组、获得分区并拉取记录,要靠后续持续调用 poll()。一次 poll() 可能返回零条或多条记录,业务处理完成后需要再次调用 poll(),Consumer 才会持续推进。
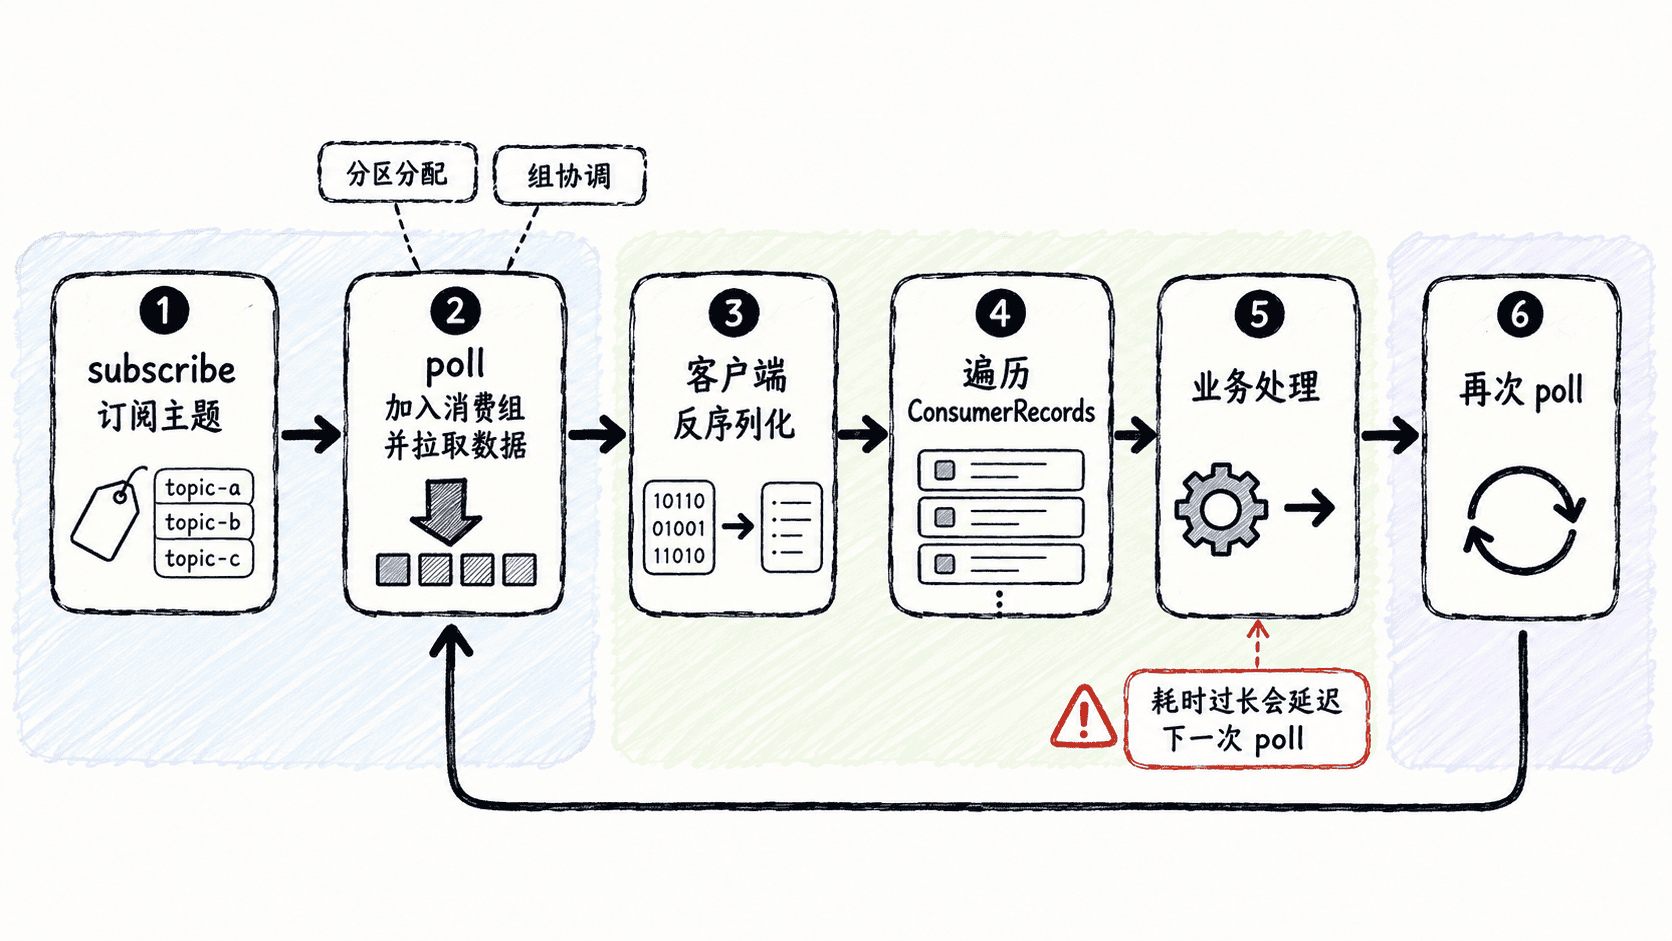
这里最容易产生的误解是把 poll() 当成单纯的“取一批消息”API。实际上,消费组成员身份、分区分配结果以及应用是否按时继续轮询,都与 Poll 循环紧密相关,因此主线程不能长时间完全停在 poll() 之外。
写出最小可运行循环
下面示例假设本机 Kafka 已存在主题 orders,并使用字符串作为 key 和 value。程序注册关闭钩子,在退出时调用 wakeup() 打断阻塞中的 poll(),最终由消费线程执行 close()。
import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.apache.kafka.clients.consumer.ConsumerRecord;
import org.apache.kafka.clients.consumer.ConsumerRecords;
import org.apache.kafka.clients.consumer.KafkaConsumer;
import org.apache.kafka.common.errors.WakeupException;
import org.apache.kafka.common.serialization.StringDeserializer;

import java.time.Duration;
import java.util.List;
import java.util.Properties;

public class PollLoopDemo {
    public static void main(String[] args) {
        Properties props = new Properties();
        props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        props.put(ConsumerConfig.GROUP_ID_CONFIG, "orders-worker");
        props.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
        props.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG, StringDeserializer.class.getName());
        props.put(ConsumerConfig.AUTO_OFFSET_RESET_CONFIG, "earliest");

        KafkaConsumer<String, String> consumer = new KafkaConsumer<>(props);
        Runtime.getRuntime().addShutdownHook(new Thread(consumer::wakeup));

        try {
            consumer.subscribe(List.of("orders"));
            while (true) {
                ConsumerRecords<String, String> records = consumer.poll(Duration.ofSeconds(1));
                for (ConsumerRecord<String, String> record : records) {
                    // 业务处理应尽量可控,避免长时间阻塞下一次 poll。
                    System.out.printf(
                            "partition=%d offset=%d key=%s value=%s%n",
                            record.partition(), record.offset(), record.key(), record.value());
                }
            }
        } catch (WakeupException ignored) {
            // shutdown hook 触发的正常退出路径。
        } finally {
            consumer.close();
        }
    }
}
预期输出
partition=0 offset=0 key=<ID> value=<VALUE>
partition=0 offset=1 key=<ID> value=<VALUE>
实际分区、offset、key 和 value 取决于主题中的数据,可能与示例不同。若当前没有可返回的记录,poll() 可以得到空集合,循环仍会继续。
反序列化发生在哪里
Consumer 从 Broker 拉回的是字节数据,key.deserializer 与 value.deserializer 决定这些字节如何转换成 Java 对象。示例使用 StringDeserializer,因此 ConsumerRecord<String, String> 中的 key 和 value 已经是字符串,业务代码无需再次手动解码。
反序列化失败会阻止对应记录正常交给业务代码。生产系统应让 Producer 与 Consumer 对消息格式保持一致;如果使用 JSON、Avro 或 Protobuf,还要让反序列化器与对应 schema 或目标类型匹配。
单线程约束与耗时处理
KafkaConsumer 不是线程安全对象。最稳妥的模型是让一个专用线程负责 subscribe()、poll()、位移管理和 close();wakeup() 是少数可从其他线程调用、用于打断轮询的接口之一。
业务处理如果可能耗时很长,可以把记录提交到工作线程池,但主线程仍要维护 Poll 循环,并自行处理背压、异常和 offset 提交时机。尤其要关注 max.poll.interval.ms:两次 poll() 间隔超过该上限时,消费者可能被判定为未能及时处理并导致分区重新分配。
稳定的 Consumer 主循环应持续、可预测地调用 poll();真正需要并行化的是业务处理能力,而不是破坏 Consumer 客户端本身的线程模型。