
消息队列 / 系统课时
再均衡触发与影响
再均衡触发与影响
再均衡不是“消费者偶尔重连”这么简单,而是消费组重新确认成员和分区所有权的过程。本课聚焦三类高频触发:成员变化、订阅或分区变化、超时失活,并说明它们为什么会带来消费停顿、Lag 抬升和重复处理风险。
学习目标
- 判断成员、订阅和超时三类 Rebalance 触发源
- 理解分区撤销、重新分配与恢复消费之间的停顿窗口
- 用消费组状态和位移信息定位重复消费与 Lag 抖动
再均衡到底在重算什么
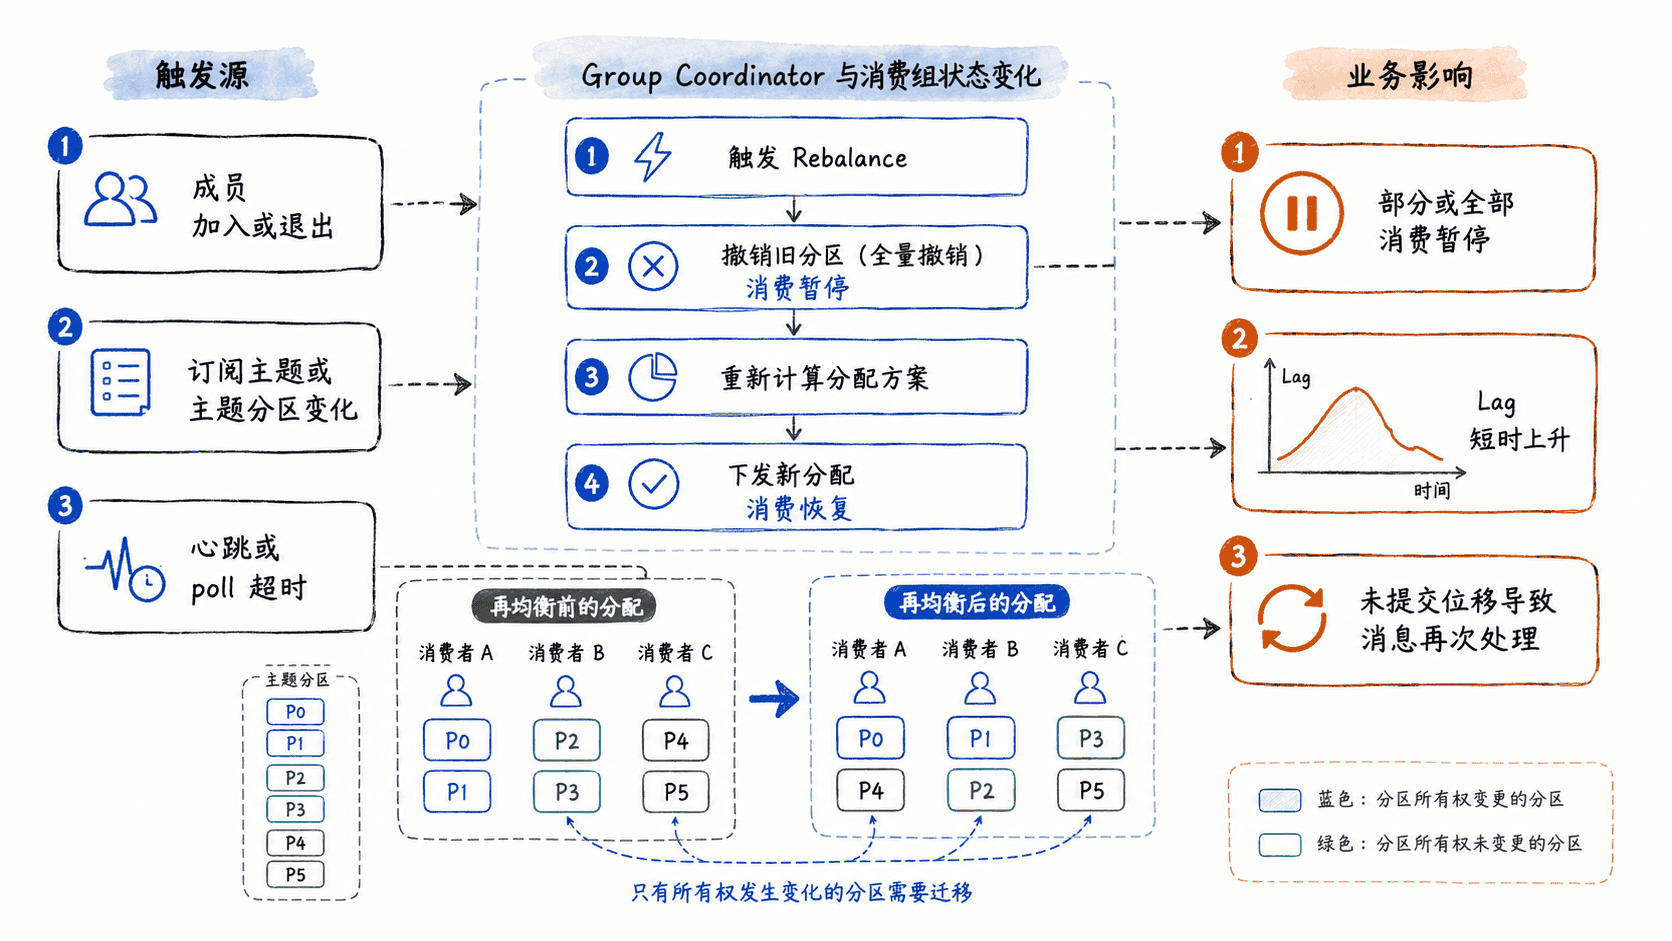
同一个 group.id 下,Kafka 必须保证一个分区在同一时刻只交给组内一个消费者处理。成员集合或可消费分区发生变化后,原有“消费者 → 分区”映射可能不再有效,消费组就需要重新形成分配结果。
在传统 eager 再均衡中,消费者会先撤销已有分区,再等待新的分配完成。即使最终某个分区仍回到原消费者手里,它也可能经历一次短暂停顿,因此频繁 Rebalance 会直接表现为吞吐下降和 Lag 波动。
三类常见触发源
成员变化最直观:新实例加入、实例正常退出、进程崩溃或网络隔离后被判定失活,都会改变组内成员集合。扩容与缩容本身不是坏事,但滚动发布如果让实例频繁进出,就可能连续触发再均衡。
订阅变化同样会改变分配约束。例如某个消费者修改订阅主题,或被订阅主题增加了分区,消费组需要重新决定这些分区该由谁接管。这里变化的不是消息内容,而是“哪些资源需要被分给哪些成员”。
超时则通常来自两条时间线。session.timeout.ms 用于判断成员是否长时间失去有效心跳;max.poll.interval.ms 则限制两次 poll() 之间允许的最大处理间隔。业务处理过慢、阻塞 I/O 或一次拉取后做重计算,都可能让消费者失去组成员资格。
停顿为什么会放大为重复消费
分区被撤销时,旧消费者必须停止处理该分区;新消费者拿到分区后,会从已提交位移继续读取。如果旧消费者已经完成了业务处理,却还没来得及提交对应位移,那么新消费者会再次读到这段消息。
因此,在“处理成功后提交位移”的 at-least-once 模式里,Rebalance 期间出现少量重复并不意味着 Broker 存了两份消息,而是新的分区所有者从较早的已提交位置恢复。业务侧应通过幂等写入、唯一业务键或去重表承受这类重复。
反过来,如果先提交位移再完成业务副作用,故障时可能跳过尚未真正处理完成的消息。再均衡风险不能只靠调超时解决,位移提交时机必须与业务一致性策略一起设计。
用命令确认当前分配
假设本机 Kafka 已启动,消费组名为 order-workers,主题为 orders。先查看每个分区当前由谁消费以及已提交位移:
bin/kafka-consumer-groups.sh \
  --bootstrap-server localhost:9092 \
  --describe \
  --group order-workers
预期输出
GROUP          TOPIC   PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG  CONSUMER-ID  HOST       CLIENT-ID
order-workers  orders  0          <VALUE>         <VALUE>         <VALUE>  <ID>         /<IP>      <ID>
order-workers orders 1 <VALUE> <VALUE> <VALUE> <ID> /<IP> <ID><VALUE>、<ID> 和 <IP> 会随运行状态变化。滚动停止或新增一个消费者后重复执行命令,重点比较分区所有者是否变化以及 Lag 是否突然上升;如果应用日志同时出现分区 revoke/assign 事件,就能把业务停顿与 Rebalance 对齐。
降低再均衡的业务冲击
先从“减少无意义触发”入手:保证消费循环持续调用 poll(),避免在消费线程里执行不可控的长任务,并让实例退出有明确的生命周期管理。随后再根据正常处理耗时设置超时,而不是直接把所有阈值放大。
对于滚动发布或短暂进程抖动,下一步通常是引入静态成员;对于确实需要重新分配的场景,则可以使用协作式再均衡,让未发生所有权变化的分区继续消费。两者解决的问题不同:前者减少触发次数,后者减少每次触发时的迁移范围。