
消息队列 / 系统课时
Topic 与 Partition 模型
Topic 与 Partition 模型
Kafka 用 Topic 对消息做逻辑分类,但真正承担写入、存储和并行消费的是 Partition。本课把这两层关系拆开:你会看到消息如何落入多个分区、分区内为什么能保持顺序,以及顺序保证为什么不能自然扩展到整个 Topic。
学习目标
- 区分 Topic 的逻辑命名空间与 Partition 的物理并行单元
- 理解分区内有序、跨分区无全局顺序的边界
- 能创建多分区 Topic,并通过描述命令验证分区布局
Topic 是逻辑入口,Partition 才是日志
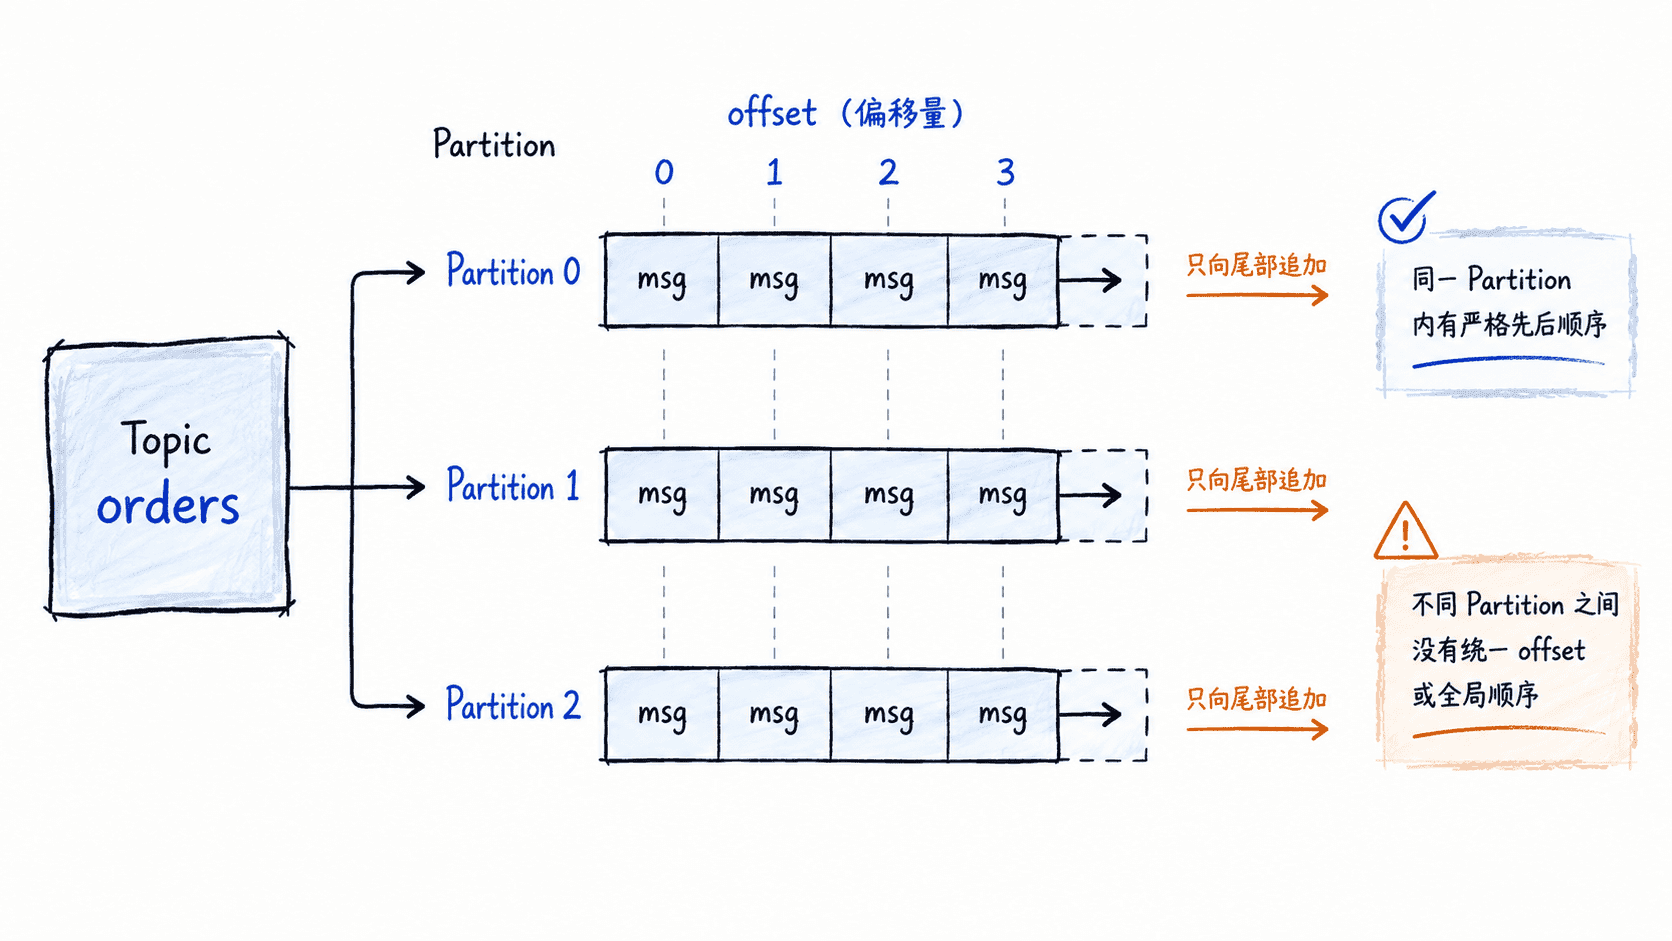
Topic 可以理解为一类消息的逻辑名称,例如 orders、payments 或 user-events。生产者向 Topic 发送消息时,Kafka 会把每条消息路由到其中一个 Partition;每个 Partition 本质上是一条只追加的日志,并拥有独立的偏移量序列。
同一个 Topic 可以有一个或多个 Partition。分区越多,生产和消费越容易并行,但也意味着消息被拆散到多条日志中。消费者读取时,真正处理的是具体分区,而不是一条全局统一的 Topic 日志。
分区决定并行度
Partition 是 Kafka 的并行基本单位。一个 Partition 在同一个消费者组内的同一时刻最多只会分配给一个消费者,因此某个 Topic 有 6 个 Partition 时,一个消费者组最多可以让 6 个消费者同时获得有效分工;再增加消费者只会出现空闲成员。
分区数也影响生产端并行写入和 Broker 间的数据分布。设计时不能只追求“越多越快”:过多分区会增加元数据、文件句柄、Leader 选举和恢复成本。通常先依据目标吞吐量、消费者并行度和可接受运维成本确定规模,再通过压测验证。
顺序保证只存在于分区内部
Kafka 为每个 Partition 单独维护递增 offset。消息一旦按顺序写入同一 Partition,消费者就能按该分区的日志顺序读取,因此“同一业务实体必须有序”通常要转化为“相关消息必须进入同一 Partition”。
跨 Partition 没有可比较的全局 offset。例如 Partition 0 的 offset 100 与 Partition 1 的 offset 80 不能表示谁在整个 Topic 中更早。即使两条消息由同一个生产者先后发送,只要它们被路由到不同分区,消费者也不应依赖全局先后关系。
创建并验证多分区 Topic
下面用 Kafka 自带命令创建一个 3 分区 Topic。示例假设 Broker 已运行在 localhost:9092。
kafka-topics.sh --bootstrap-server localhost:9092 --create --topic orders --partitions 3 --replication-factor 1
kafka-topics.sh --bootstrap-server localhost:9092 --describe --topic orders
预期输出如下,Leader 与副本编号会随实际集群不同:
Created topic orders.
Topic: orders    PartitionCount: 3    ReplicationFactor: 1
Topic: orders    Partition: 0    Leader: <ID>    Replicas: <ID>    Isr: <ID>
Topic: orders    Partition: 1    Leader: <ID>    Replicas: <ID>    Isr: <ID>
Topic: orders    Partition: 2    Leader: <ID>    Replicas: <ID>    Isr: <ID>
看到 PartitionCount: 3,说明 Topic 已被拆成三条独立日志。后续生产者写入的每条消息只会进入其中一个分区,并在该分区内获得唯一递增的 offset。
设计时先问顺序,再问并行
如果业务只要求单个用户、订单或设备内部有序,可以用对应标识作为 Key,把相关消息稳定路由到同一 Partition,同时保留不同实体之间的并行能力。如果业务真的要求所有消息全局有序,最直接的方式是只使用一个 Partition,但吞吐与消费并行度也会被限制在单分区范围内。
因此,Topic 解决“消息属于哪一类”,Partition 解决“这一类消息如何拆分、并行和排序”。理解这层边界,是后续设计 Key、消费者组和副本布局的基础。