
消息队列 / 系统课时
容量估算与压测验证
容量估算与压测验证
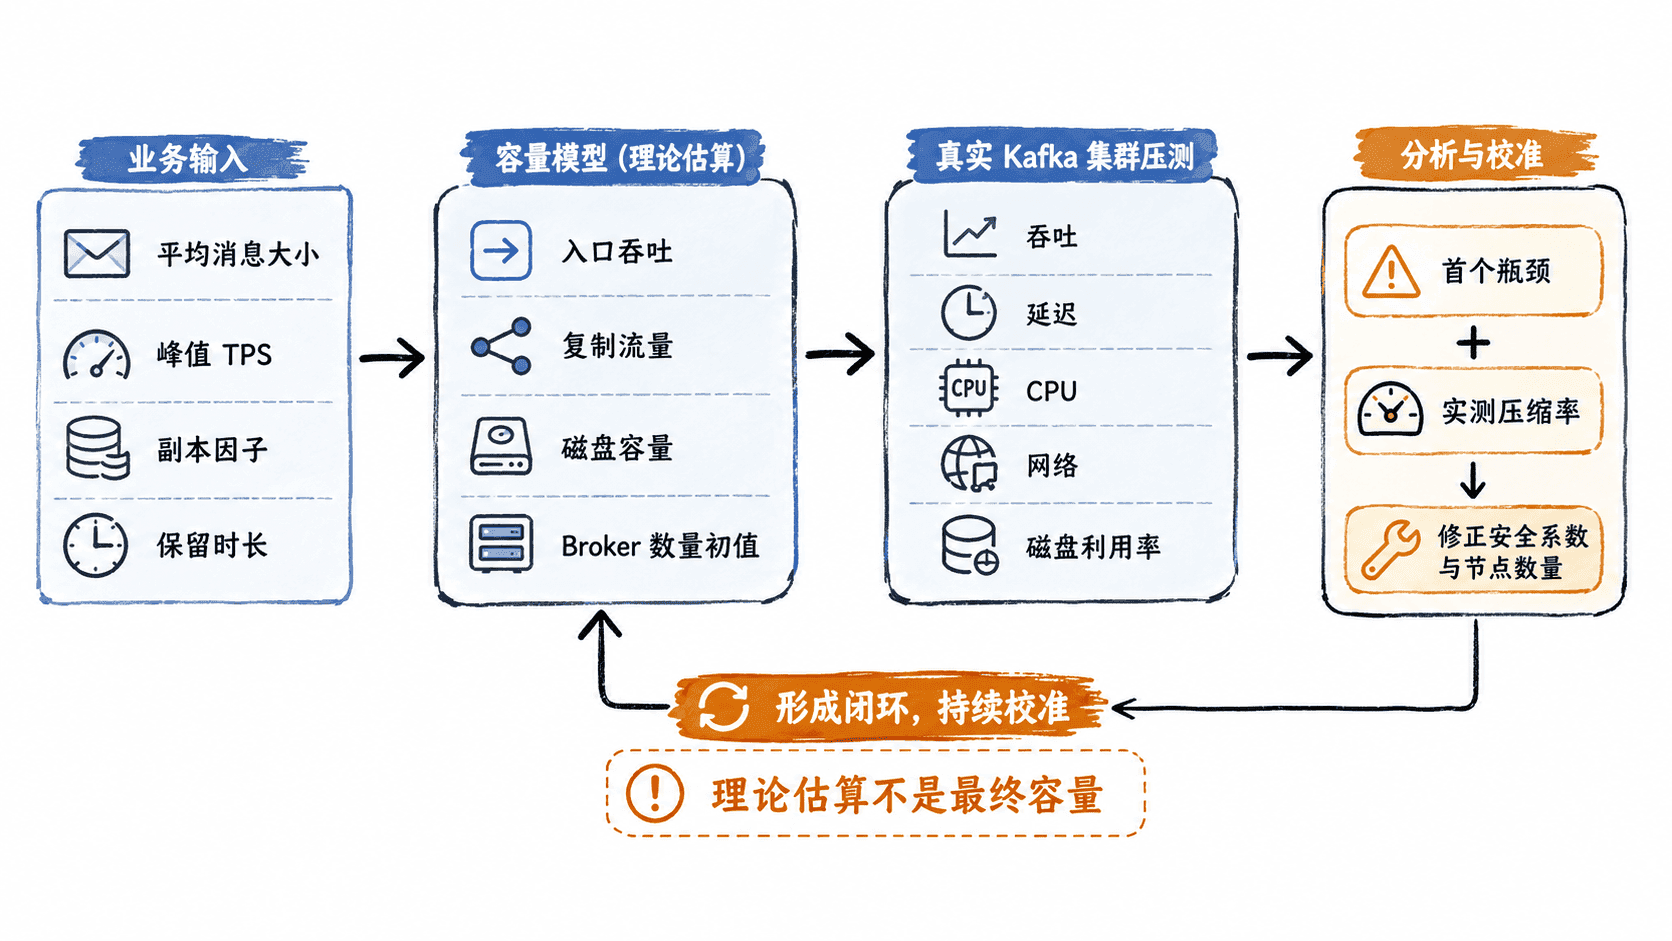
容量规划不能停在电子表格里。本课先用消息大小、峰值 TPS、副本因子和保留时间推导吞吐与存储需求,再通过 Kafka 自带性能测试工具验证单节点和集群能力,并用实测结果反向修正容量模型。
学习目标
- 从业务峰值参数估算网络吞吐、Broker 写入量和日志容量
- 使用 Kafka Producer 性能测试工具执行可重复的基准压测
- 根据吞吐、延迟和资源利用率为容量模型加入安全系数
把业务指标转换为资源需求
容量估算至少需要四个输入:平均消息大小 、峰值消息速率 、副本因子 和保留时间 。先算业务写入吞吐:
如果平均消息为 1 KiB,峰值为 50,000 条/s,则业务侧原始吞吐约为 48.8 MiB/s。副本因子为 3 时,Broker 集群内部还要承担副本复制流量,因此磁盘和网络不能只按照 Producer 到 Leader 的入口流量规划。
保留容量可以用近似模型:
这个结果应再乘以安全系数,并使用真实压缩率校准。容量模型应以峰值或明确的高分位业务负载作为输入,而不是直接使用全天平均 TPS,否则短时间流量尖峰很容易突破节点能力。
把集群能力拆成瓶颈预算
Kafka 的可用吞吐不是 CPU、网卡或磁盘某一个指标决定的,而是最先饱和的资源决定的。规划时至少检查 Producer 入口网络、Leader 磁盘写入、副本复制网络与磁盘、Consumer 出口网络,以及 Broker CPU。
例如某 Broker 在压测中可以稳定处理 100 MB/s,但此时磁盘利用率已经接近极限,那么容量模型就不能继续按 CPU 剩余比例线性放大。生产目标负载通常应明显低于压测得到的极限值,为副本恢复、流量波动和后台维护保留空间。
用 Producer 压测验证写入能力
测试前应创建专用 Topic,并让分区数、副本因子、消息大小、压缩方式和生产环境尽量一致。下面使用 Kafka 自带的 kafka-producer-perf-test.sh 发送 100 万条、每条 1024 字节的消息。<PORT> 替换为测试集群实际端口。
bin/kafka-producer-perf-test.sh \
  --topic capacity-benchmark \
  --num-records 1000000 \
  --record-size 1024 \
  --throughput -1 \
  --producer-props \
  bootstrap.servers=broker1:<PORT>,broker2:<PORT>,broker3:<PORT> \
  acks=all \
  compression.type=lz4
预期输出会包含发送速率、数据吞吐和延迟统计,具体数值取决于硬件、Kafka 版本与测试环境:
<VALUE> records sent, <VALUE> records/sec (<VALUE> MB/sec), <VALUE> ms avg latency, <VALUE> ms max latency.
<VALUE> records sent, <VALUE> records/sec (<VALUE> MB/sec), <VALUE> ms avg latency, <VALUE> ms max latency.
不要只记录最高 MB/s。至少同时保存稳定阶段吞吐、平均与尾部延迟,以及测试期间 CPU、网卡和磁盘利用率。压测开始后的短暂突发成绩不能代表长期可持续容量。
用阶梯负载找到安全容量
相比一次把流量打满,更实用的方法是阶梯式增加目标吞吐。例如从预估峰值的 50% 开始,每轮提高负载并保持足够长时间,观察延迟、CPU、网络和磁盘是否出现非线性恶化。
如果从 70 MB/s 提升到 80 MB/s 后吞吐只增加少量,但延迟突然上升、磁盘队列持续积压,那么 80 MB/s 已经接近或超过该环境的稳定边界。容量规划应使用稳定边界以下的目标值,而不是把极限测试结果当成单 Broker 配额。
压测还应覆盖故障场景。正常三节点集群能承担峰值,不代表一台 Broker 下线、Leader 转移和副本追赶时仍有足够资源。因此至少需要验证正常状态与少一个 Broker 后的降级状态。
用实测结果反推节点数量
假设业务峰值需要 300 MB/s 的有效入口吞吐,而压测表明单 Broker 在满足目标延迟并保留运维余量后,只适合承担 60 MB/s,则吞吐维度至少需要 5 个 Broker。随后还必须分别检查磁盘容量、分区数量、网络和故障冗余,最终取各约束计算出的最大节点数。
容量模型应保存“输入假设”和“实测基线”两组数据。消息大小、压缩率、流量模式或硬件变化后重新压测,而不是继续沿用旧结论。这样得到的 Broker 数量不是一次性的猜测,而是一套可以随着业务增长反复校准的工程模型。