
消息队列 / 系统课时
Kafka Streams 处理模型
Kafka Streams 处理模型
Kafka Streams 把“持续到来的事件”和“会随事件更新的状态”统一放进一个处理拓扑。理解 KStream、KTable、GlobalKTable、State Store 与 Changelog Topic 的关系后,你就能判断一段流处理逻辑是在处理事件历史、维护当前视图,还是依赖可恢复的本地状态。
学习目标
- 读懂 Kafka Streams 拓扑以及 Source、Processor、Sink 之间的数据流
- 区分 KStream、KTable 与 GlobalKTable 的语义和适用场景
- 解释状态存储为何需要本地 Store,以及故障后如何恢复
拓扑是运行时的处理蓝图
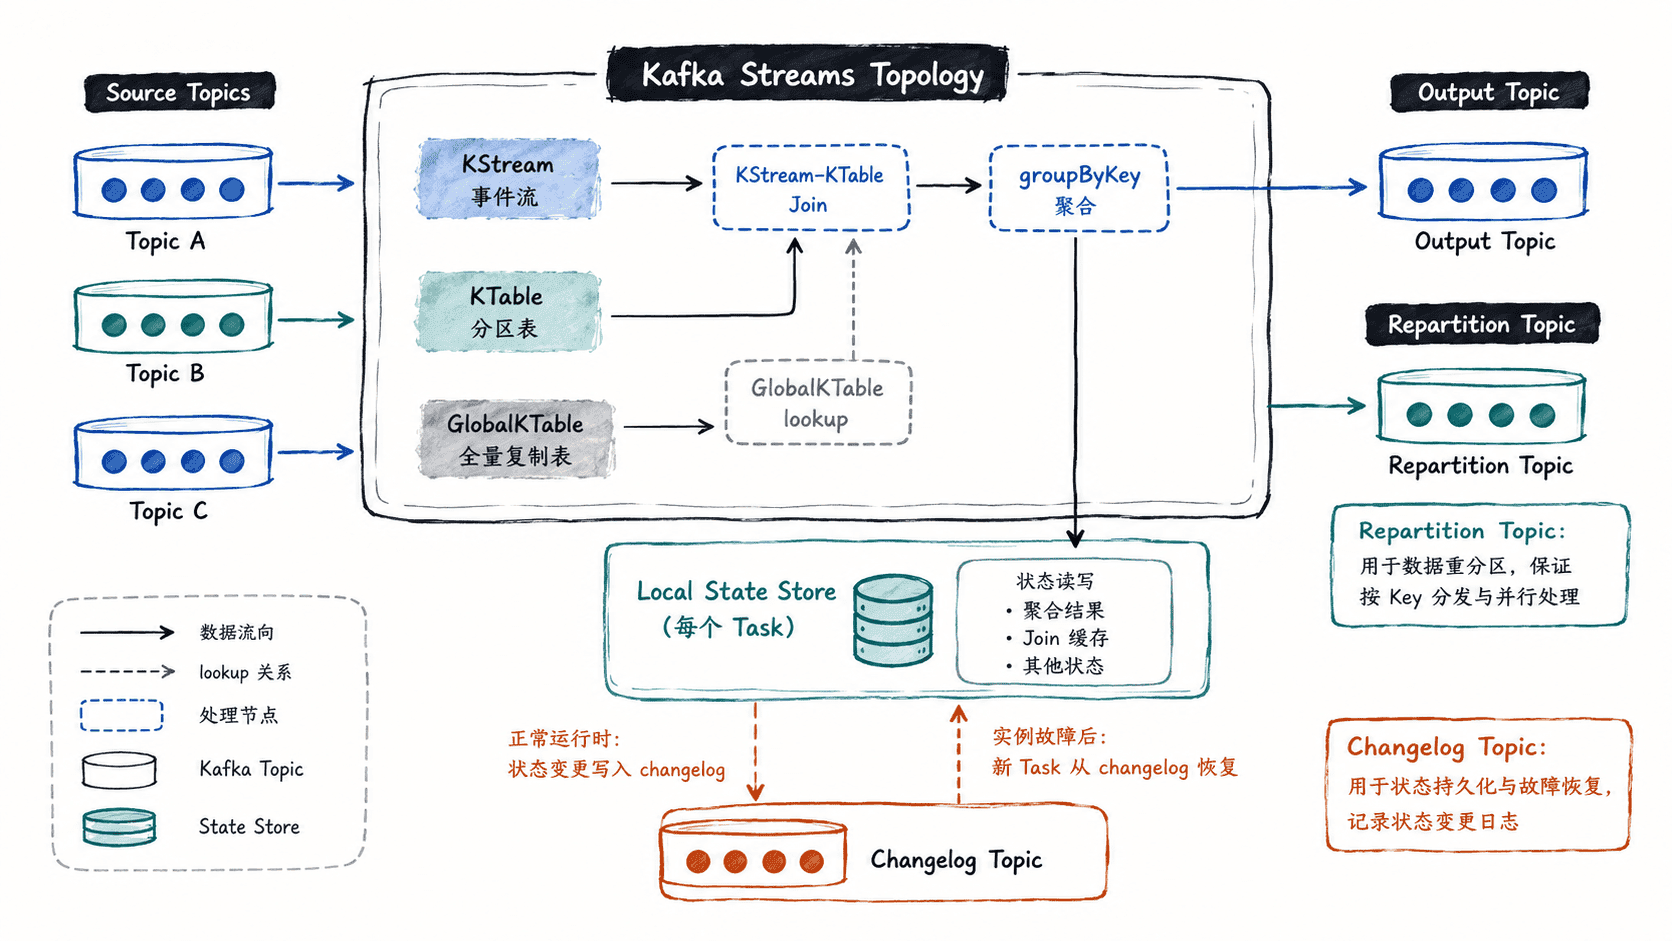
Kafka Streams 应用先通过 DSL 或 Processor API 构建 Topology。拓扑中的 Source 从 Kafka Topic 读取记录,Processor 执行过滤、映射、聚合或 Join,Sink 再把结果写回 Kafka。应用启动后,一个拓扑会被拆成多个 Task,Task 按输入分区并行执行。
这里最重要的不是“有多少个算子”,而是数据是否需要重新按 Key 分区,以及某个算子是否需要状态。mapValues 这类逐条变换通常无状态;groupByKey().count()、窗口聚合和很多 Join 则需要维护状态,并可能引入内部 Topic。
KStream、KTable 与 GlobalKTable 的区别
KStream 表示事件记录流,同一个 Key 出现十次就是十个独立事件,适合订单、点击、日志等“历史不可被后续记录覆盖”的数据。KTable 表示按 Key 更新的当前视图,同一个 Key 的新值会替换旧值,适合账户状态、用户配置等变更表。
GlobalKTable 也是表语义,但每个 Streams 实例都会消费其源 Topic 的全部分区,并在本地保留完整副本。它适合体量可控、读频繁的小型参考数据。代价是每个实例都要承担完整数据量,因此不能把大型事实表简单改成 GlobalKTable 来逃避重新分区。
| 抽象 | 核心语义 | 本地数据范围 | 常见用途 |
|---|---|---|---|
KStream |
每条记录都是事件 | 当前 Task 对应分区 | 事件处理、过滤、转换 |
KTable |
每个 Key 的最新状态 | 当前 Task 对应分区 | 当前视图、按 Key Join |
GlobalKTable |
每个 Key 的最新状态 | 每个实例保存全量 | 小型维表、参考数据 Join |
状态存储让聚合可以增量执行
有状态算子不能每来一条消息就从头扫描全部历史,因此 Kafka Streams 会使用本地 State Store 保存中间状态。持久化键值 Store 通常由本地存储引擎承载,Processor 可以按 Key 直接读取和更新结果。
下面的 Java 示例同时创建 KStream、KTable、GlobalKTable,并把按 Key 的计数结果物化到名为 orders-by-key-store 的状态存储。代码假设 Kafka 已在 localhost:9092 运行,输入 Topic 已创建。
import java.util.Properties;

import org.apache.kafka.common.serialization.Serdes;
import org.apache.kafka.common.utils.Bytes;
import org.apache.kafka.streams.KafkaStreams;
import org.apache.kafka.streams.StreamsBuilder;
import org.apache.kafka.streams.StreamsConfig;
import org.apache.kafka.streams.kstream.GlobalKTable;
import org.apache.kafka.streams.kstream.KStream;
import org.apache.kafka.streams.kstream.KTable;
import org.apache.kafka.streams.kstream.Materialized;
import org.apache.kafka.streams.kstream.Produced;
import org.apache.kafka.streams.state.KeyValueStore;

public class ProcessingModelDemo {
    public static void main(String[] args) {
        Properties props = new Properties();
        props.put(StreamsConfig.APPLICATION_ID_CONFIG, "processing-model-demo");
        props.put(StreamsConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        props.put(StreamsConfig.DEFAULT_KEY_SERDE_CLASS_CONFIG, Serdes.String().getClass());
        props.put(StreamsConfig.DEFAULT_VALUE_SERDE_CLASS_CONFIG, Serdes.String().getClass());

        StreamsBuilder builder = new StreamsBuilder();
        KStream<String, String> orders = builder.stream("orders");
        KTable<String, String> customerTier = builder.table("customer-tier");
        GlobalKTable<String, String> storeRegion = builder.globalTable("store-region");

        // KTable Join 按流记录当前 Key 查询客户等级。
        KStream<String, String> enriched = orders.leftJoin(
                customerTier,
                (order, tier) -> order + "|tier=" + String.valueOf(tier));

        // 计数是有状态操作,显式物化为可命名的本地 KeyValueStore。
        enriched.groupByKey()
                .count(Materialized.<String, Long, KeyValueStore<Bytes, byte[]>>as("orders-by-key-store")
                        .withKeySerde(Serdes.String())
                        .withValueSerde(Serdes.Long()))
                .toStream()
                .to("order-counts", Produced.with(Serdes.String(), Serdes.Long()));

        System.out.println("topology-ready: " + (storeRegion != null));
        KafkaStreams streams = new KafkaStreams(builder.build(), props);
        Runtime.getRuntime().addShutdownHook(new Thread(streams::close));
        streams.start();
    }
}
预期输出至少会先出现下面这一行;随后 Kafka Streams 自身日志会因版本和日志配置不同而变化:
topology-ready: true示例中的 GlobalKTable 只是为了展示其建模位置,没有参与计算;实际项目应在确有“每实例全量参考表”需求时再使用它,而不是为了消除 Join 复杂度而默认引入。
Changelog Topic 负责把本地状态变成可恢复状态
State Store 在本机,因此实例退出、磁盘丢失或 Task 被调度到另一台机器时,不能只依赖旧目录。对于需要日志备份的状态存储,Kafka Streams 会把状态更新写入内部 Changelog Topic;新实例接管 Task 后,可以先恢复 Store,再继续处理输入。
Changelog Topic 与 Repartition Topic 用途不同:前者保护状态,后者改变记录的分区方式。例如在 groupBy 改变 Key 后继续聚合,通常需要先重新分区;而聚合结果本身又可能需要 Changelog 作为恢复来源。
用语义选择抽象而不是按性能猜
如果你关心“每一次发生了什么”,优先从 KStream 思考;如果你关心“某个 Key 现在是什么状态”,使用 KTable;只有当参考表足够小、每个实例都值得保存完整副本时,才考虑 GlobalKTable。
一旦出现聚合、窗口或需要历史上下文的 Join,就要继续追问两个问题:状态存在哪里,故障后从哪里恢复。能同时回答这两个问题,才算真正读懂 Kafka Streams 的处理模型。