
消息队列 / 系统课时
消息队列与事件流平台
消息队列与事件流平台
消息队列和事件流平台都会传递消息,但它们解决问题的中心不同:传统队列更关注把任务可靠交给某个消费者,事件流平台则把持续产生的事件保存成可重复读取的记录。本节通过消费模型、数据保留和重放能力理解两者差异,并明确 Kafka 的适用边界。
学习目标
- 区分消息队列与事件流平台在数据保留和消费方式上的核心差异
- 解释 Kafka 中持久化事件日志和消费者位置的基本关系
- 判断任务分发、事件重放和持续数据管道分别更适合哪类模型
两类系统关注的中心不同
传统消息队列通常围绕“把一项工作交给消费者完成”设计。消息进入队列后由消费者领取并处理,同一工作通常希望只由一个消费者实例执行;处理确认后,这条消息的业务使命基本结束。
事件流平台更关注“记录发生过什么”。事件按照追加顺序写入持久化日志,不同消费者可以维护各自的读取位置,因此同一份历史数据可以被多个应用独立读取,也可以在需要时重新消费。
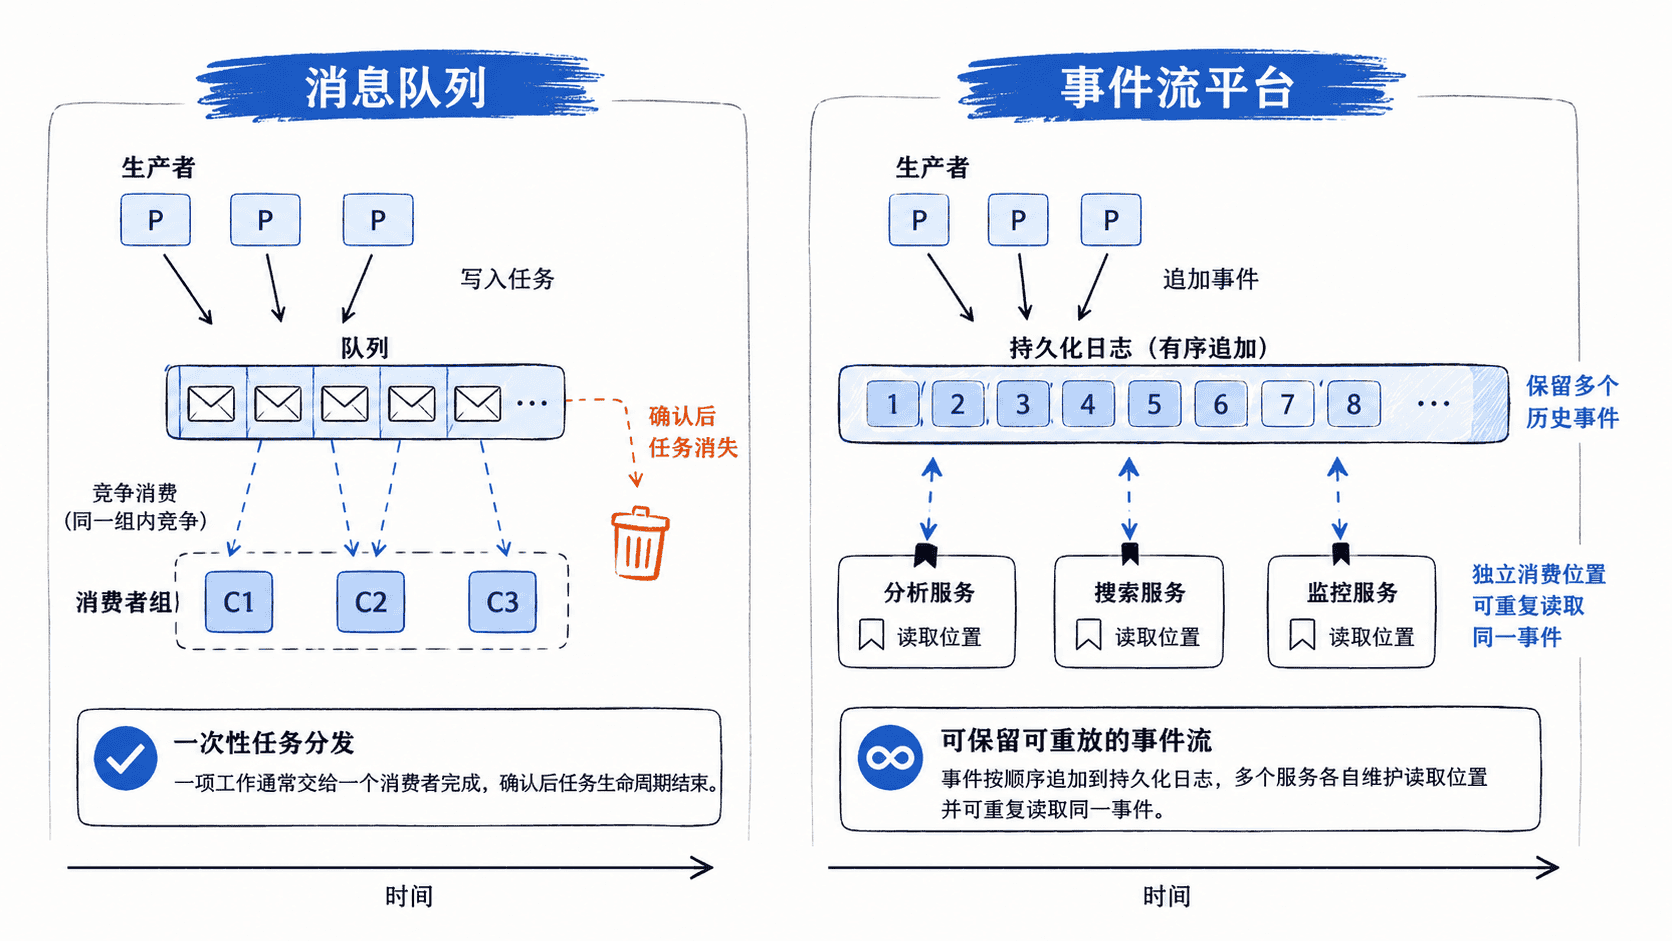
这不是说两类系统完全互斥,而是设计重心不同。现代产品往往同时具备队列和流处理能力,所以判断时应关注具体的数据生命周期与消费语义,而不是只看产品名称。
数据是否在消费后继续存在
队列模型通常把消息视为待完成任务。消费者成功确认后,系统可以删除或不再向其他消费者提供这项任务。因此它很适合发送邮件、生成缩略图、后台作业等工作分发场景。
事件流平台通常按照时间或存储容量保留数据,而不是因为某个消费者读过就立即删除。消费者保存自己的读取位置,读取行为和数据保留彼此分离。这意味着新消费者加入后仍可能从历史位置开始处理。
这种模型尤其适合日志采集、业务事件、实时分析和变更数据捕获,因为多个下游系统往往需要以不同速度消费同一份数据。
Kafka 为什么更接近事件流平台
Kafka 的核心抽象是持续追加的分区日志。生产者把记录写入主题的分区,记录在保留周期内继续存在;消费者按照偏移量读取,并自行维护已经处理到的位置。
因此,同一个主题可以同时服务多个互不干扰的消费者组。例如搜索索引系统读取订单事件建立检索数据,实时分析系统读取同一批事件计算指标,新的审计程序还可以从较早位置重新读取历史事件。
Kafka 不是所有队列需求的替代品
如果业务核心是大量独立任务的逐条领取、复杂优先级、单条消息延迟投递或非常灵活的消息级路由,专门的消息队列产品可能更直接。Kafka 更擅长高吞吐的持续事件流、按分区保持顺序、多个消费者组独立读取,以及基于历史数据重新处理。
选择模型时,可以先判断消息代表什么:如果它主要表示“请完成这项工作”,首先考虑任务队列语义;如果它表示“这件事已经发生,并且以后可能还有多个系统需要读取”,事件流模型通常更自然。Kafka 可以覆盖部分队列场景,但它最有价值的地方,是把事件作为一份可持续保存和重复消费的数据记录。