
消息队列 / 系统课时
接入指标、日志与告警
接入指标、日志与告警
本课把订单事件平台的可观测性补齐:统一采集生产失败、消费延迟、处理耗时、重试与死信指标,同时让日志能够定位到具体事件,并用 Prometheus 规则把异常转成可执行的告警。
学习目标
- 为订单事件链路定义低基数、可聚合的核心指标
- 用结构化日志串联事件、分区、偏移量与重试上下文
- 为失败、积压、慢处理和死信建立可验证的告警规则
先确定可观测信号
不要先从“能采什么”出发,而要从故障动作倒推信号。生产失败回答消息是否离开发送端;消费延迟回答积压是否扩大;处理耗时回答消费者是否变慢;重试与死信回答错误是否正在被放大或已经无法自动恢复。
| 信号 | 建议指标 | 主要判断 |
|---|---|---|
| 生产失败 | order_event_produce_failures_total |
发送端持续失败或突增 |
| 消费延迟 | order_event_consumer_lag |
消费速度落后于生产速度 |
| 处理耗时 | order_event_processing_seconds |
p95/p99 是否超过处理目标 |
| 重试次数 | order_event_retries_total |
短暂错误是否演变成重试风暴 |
| 死信数量 | order_event_dlq_total |
是否出现无法自动恢复的事件 |
指标标签只保留 topic、consumerGroup、result 这类有限集合。orderId、eventId、异常消息等高基数字段应进入日志,而不是进入 Prometheus 标签,否则时间序列数量会快速膨胀。
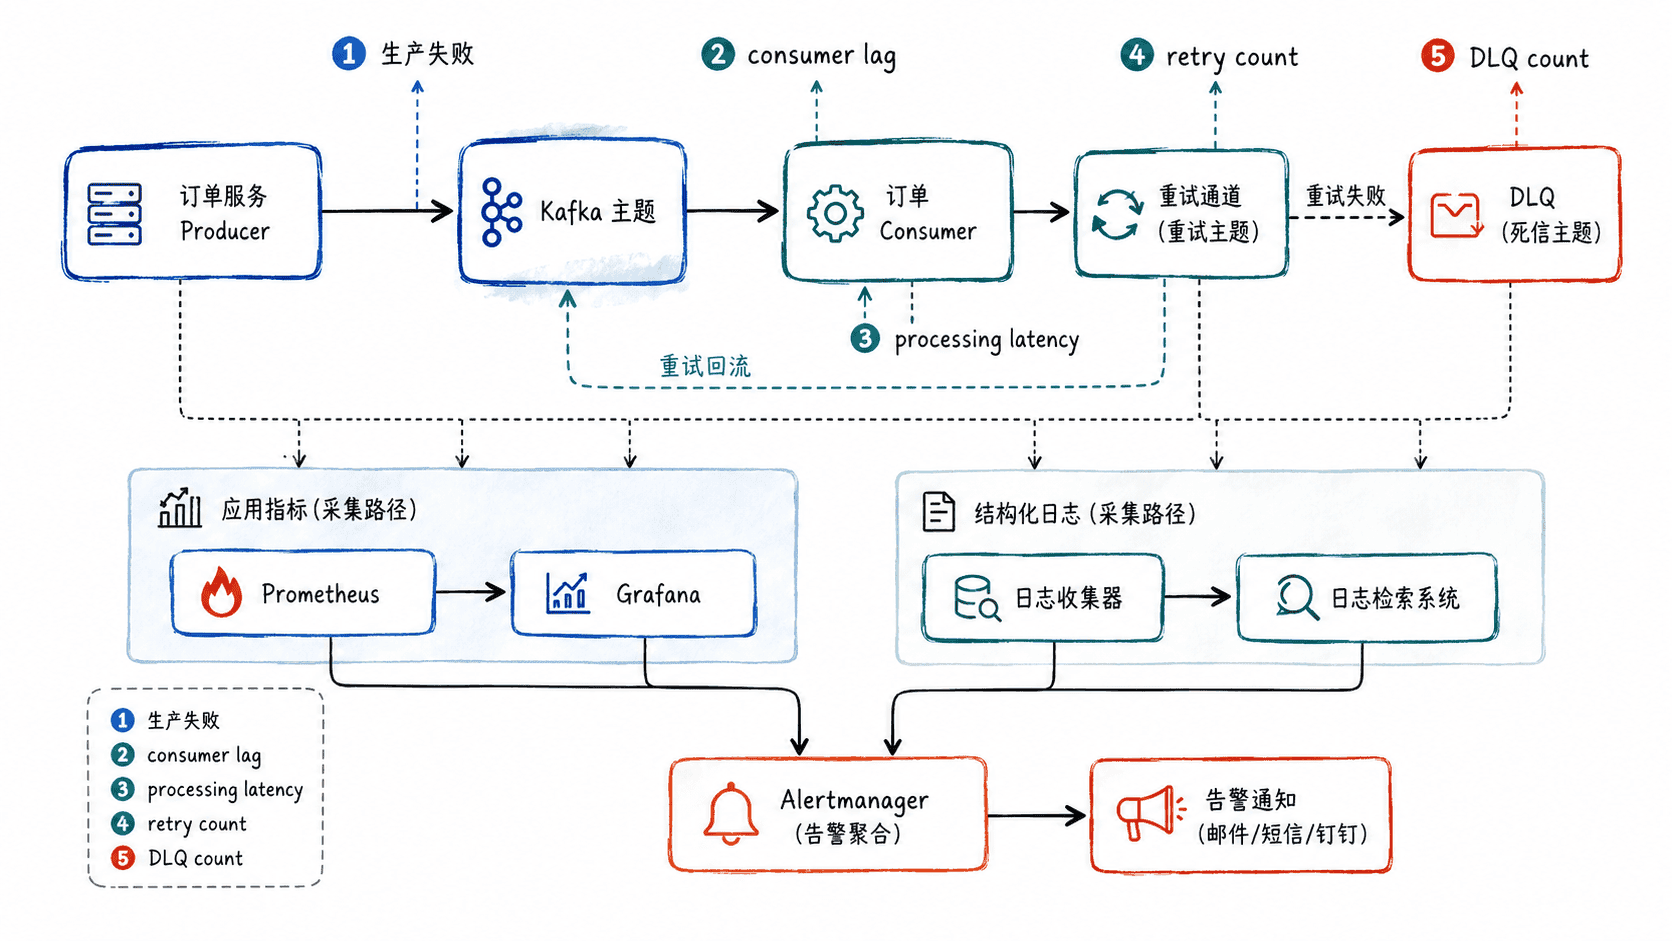
在 Spring Boot 中埋入业务指标
以 Spring Boot 3、Actuator 和 Micrometer 为例,先引入 Actuator 与 Prometheus Registry,并开放 Prometheus 端点。以下依赖片段加入现有 Maven pom.xml 的 dependencies 节点。
<dependency>
  <groupId>org.springframework.boot</groupId>
  <artifactId>spring-boot-starter-actuator</artifactId>
</dependency>
<dependency>
  <groupId>io.micrometer</groupId>
  <artifactId>micrometer-registry-prometheus</artifactId>
</dependency>
配置片段如下。生产环境应同时通过网络策略或鉴权限制 Actuator 暴露范围。
management:
  endpoints:
    web:
      exposure:
        include: health,prometheus
  metrics:
    tags:
      application: order-event-platform
业务侧只记录能够驱动运维动作的指标。下面的组件负责生产失败、重试、死信和处理耗时;消费延迟可由 Kafka Exporter/JMX Exporter 采集后统一映射到 order_event_consumer_lag,避免应用进程重复扫描消费组位点。
import io.micrometer.core.instrument.Counter;
import io.micrometer.core.instrument.MeterRegistry;
import io.micrometer.core.instrument.Timer;
import org.springframework.stereotype.Component;

@Component
public class OrderEventMetrics {
    private final Counter produceFailures;
    private final Counter retries;
    private final Counter dlq;
    private final Timer processing;

    public OrderEventMetrics(MeterRegistry registry) {
        this.produceFailures = Counter.builder("order.event.produce.failures")
                .description("Failed order-event sends")
                .register(registry);
        this.retries = Counter.builder("order.event.retries")
                .description("Order-event retry attempts")
                .register(registry);
        this.dlq = Counter.builder("order.event.dlq")
                .description("Order events sent to DLQ")
                .register(registry);
        this.processing = Timer.builder("order.event.processing")
                .description("Order-event processing latency")
                .publishPercentileHistogram()
                .register(registry);
    }

    public void recordProduceFailure() {
        produceFailures.increment();
    }

    public void recordRetry() {
        retries.increment();
    }

    public void recordDlq() {
        dlq.increment();
    }

    public Timer.Sample startProcessing() {
        return Timer.start();
    }

    public void stopProcessing(Timer.Sample sample) {
        sample.stop(processing);
    }
}
这是集成片段:发送回调失败时调用 recordProduceFailure(),监听器入口创建 Timer.Sample,处理完成后停止计时;每次重试和进入死信恢复器时分别递增对应 Counter。接入后可直接验证导出结果。
curl -s http://localhost:<PORT>/actuator/prometheus | grep '^order_event_'预期输出
order_event_produce_failures_total <VALUE>
order_event_retries_total <VALUE>
order_event_dlq_total <VALUE>
order_event_processing_seconds_count <VALUE>
order_event_processing_seconds_sum <VALUE>
<PORT> 与 <VALUE> 会随环境和流量变化;只要指标名存在且数值随测试事件变化,就说明埋点链路已生效。
用日志补足事件级上下文
指标负责“发现异常”,日志负责“解释异常”。每条消费日志至少保留 eventId、orderId、topic、partition、offset、attempt、durationMs 和最终结果;异常时再记录异常类型与根因。不要把完整消息体默认写入日志,订单事件可能包含隐私数据,且大消息会显著增加日志成本。
建议输出为稳定的键值格式,例如:
event=order_event_processed eventId=<ID> orderId=<ID> topic=order-events partition=<VALUE> offset=<VALUE> attempt=<VALUE> durationMs=<VALUE> result=success当告警提示某个消费组积压时,可以先按时间窗口过滤 result=failed 或 attempt>1,再用 eventId 定位同一事件的重试与死信轨迹,这比在指标里增加事件级标签更安全。
把指标变成告警规则
告警必须同时包含阈值、持续时间和动作。瞬时尖峰通常只记录,不立即通知;持续异常才升级为告警。下面示例假设 Prometheus 已能采到前述五类指标。
groups:
  - name: order-event-platform
    rules:
      - alert: OrderEventProduceFailures
        expr: rate(order_event_produce_failures_total[5m]) > 0
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "订单事件持续生产失败"
      - alert: OrderEventConsumerLagHigh
        expr: order_event_consumer_lag > 5000
        for: 10m
        labels:
          severity: warning
        annotations:
          summary: "订单事件消费积压持续升高"
      - alert: OrderEventProcessingP95Slow
        expr: histogram_quantile(0.95, sum by (le) (rate(order_event_processing_seconds_bucket[5m]))) > 1
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "订单事件处理 p95 超过 1 秒"
      - alert: OrderEventRetryBurst
        expr: increase(order_event_retries_total[10m]) > 100
        for: 5m
        labels:
          severity: warning
        annotations:
          summary: "订单事件重试次数异常"
      - alert: OrderEventDlqDetected
        expr: increase(order_event_dlq_total[5m]) > 0
        for: 1m
        labels:
          severity: critical
        annotations:
          summary: "订单事件进入死信队列"
阈值 5000、1 秒和 100 次只是演示值,正式环境应按峰值流量、消费者并发和业务 SLO 校准。保存规则后先做语法检查,再交给 Prometheus 加载。
promtool check rules <PATH>/order-event-alerts.yml预期输出
Checking <PATH>/order-event-alerts.yml
  SUCCESS: <VALUE> rules found
最终验收不要只看规则文件是否加载成功,还要主动制造一次可控失败、一次重试和一次死信,确认指标变化、日志可检索、告警能够触发并带上明确的处置方向。