
消息队列 / 系统课时
Kafka 事务基础
Kafka 事务基础
幂等生产者能消除单个分区上的重试重复,但不能让多条记录作为一个整体提交。本课使用 transactional.id 和 KafkaProducer 的事务 API 完成提交与中止,并通过 read_committed 验证只有已提交事务对消费者可见。
学习目标
- 说明
transactional.id、事务协调器与事务记录之间的关系 - 使用
initTransactions()、beginTransaction()、commitTransaction()和abortTransaction() - 用
read_committed验证提交与中止的可见性差异
事务把哪些写入绑定在一起
Kafka 事务可以把同一个 Producer 对多个分区、甚至多个 Topic 的一组写入纳入同一事务。事务提交后,这组记录才会对采用 read_committed 隔离级别的消费者整体可见;事务中止后,这类消费者会跳过相应记录。
transactional.id 标识一个逻辑上的事务生产者。Producer 初始化事务能力时会与 Transaction Coordinator 协作,获得用于后续事务的生产者身份;Coordinator 负责追踪事务状态,并在相关分区上完成提交或中止标记。
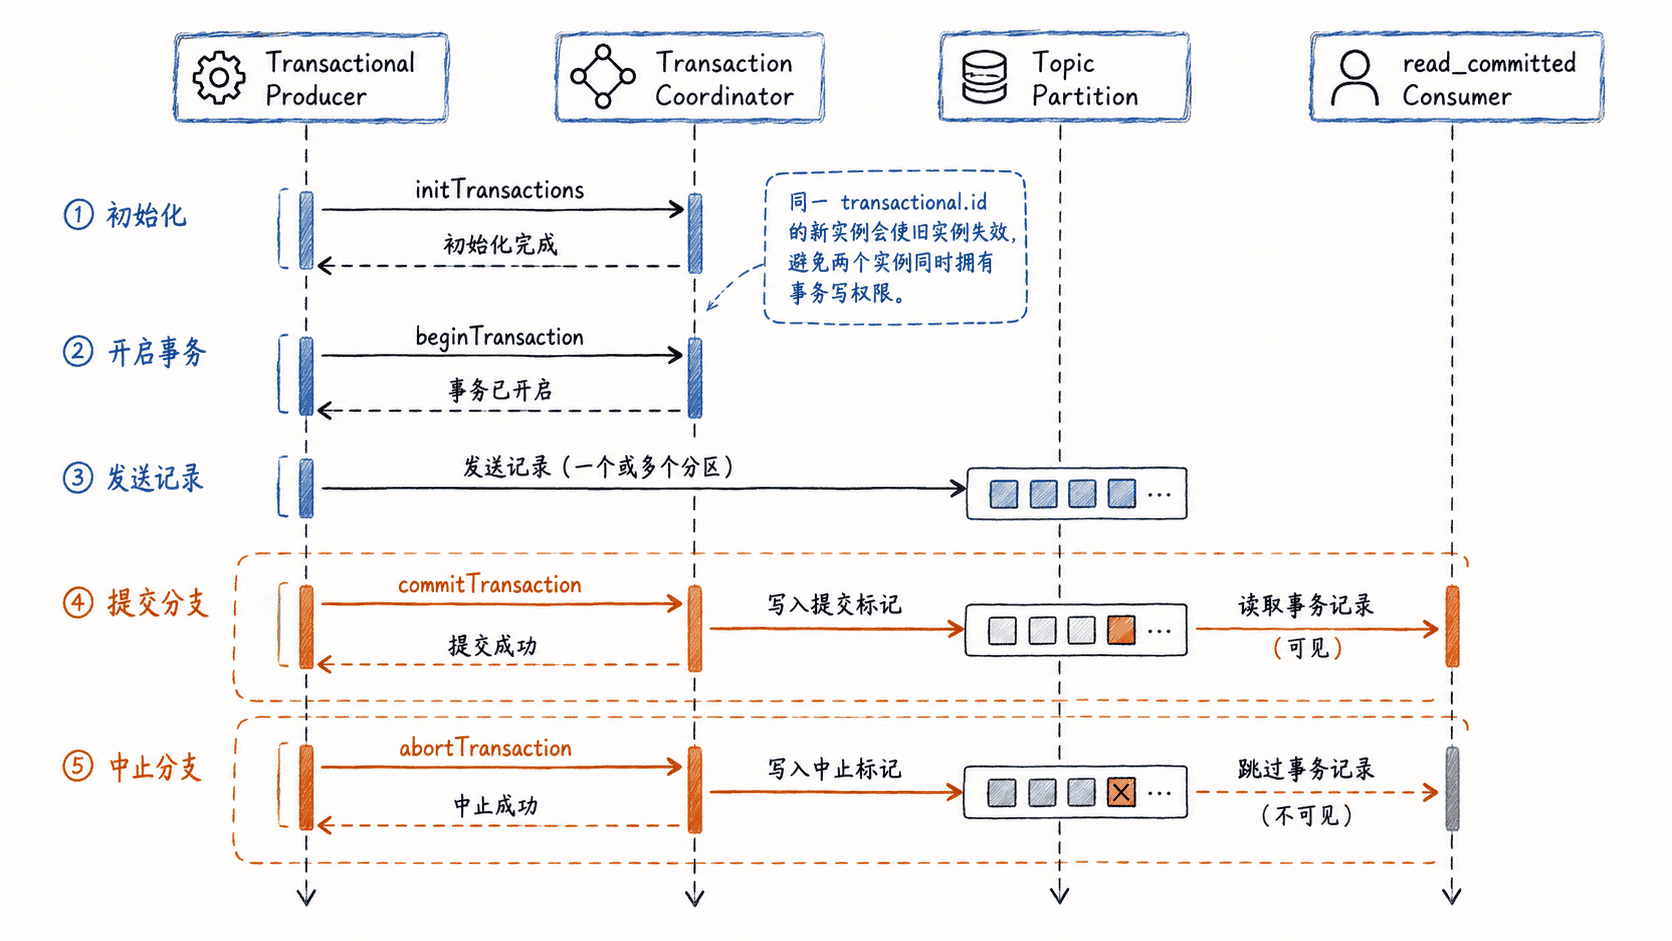
五个核心动作
transactional.id 需要在创建 Producer 时配置。对同一个逻辑生产者,它应在重启后保持稳定;同时运行的不同实例必须使用不同值,否则新实例初始化后可能使旧实例被 fencing,旧实例不能继续提交事务。
initTransactions():初始化事务能力,并处理同一transactional.id之前未完成的事务状态。beginTransaction():开始一个新的事务边界。commitTransaction():提交当前事务,使其中记录对read_committed消费者可见。abortTransaction():中止当前事务,使其中记录不会被read_committed消费者当作有效结果读取。
配置了 transactional.id 后,Producer 会使用幂等写入能力,因此事务是在幂等基础上增加跨记录、跨分区的原子提交语义。
完整提交与中止示例
下面示例假设 transaction-demo 是一个全新的 Topic。第一个事务提交两条记录,第二个事务发送一条记录后主动中止,便于后续直接验证可见性。
import java.util.Properties;
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerConfig;
import org.apache.kafka.clients.producer.ProducerRecord;
import org.apache.kafka.common.serialization.StringSerializer;

public class TransactionProducerDemo {
    public static void main(String[] args) throws Exception {
        String bootstrapServers = args.length > 0 ? args[0] : "localhost:9092";
        Properties props = new Properties();
        props.put(ProducerConfig.BOOTSTRAP_SERVERS_CONFIG, bootstrapServers);
        props.put(ProducerConfig.KEY_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        props.put(ProducerConfig.VALUE_SERIALIZER_CLASS_CONFIG, StringSerializer.class.getName());
        // 同一逻辑实例重启时保持稳定;并发实例要使用不同 transactional.id。
        props.put(ProducerConfig.TRANSACTIONAL_ID_CONFIG, "orders-writer-1");
        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            producer.initTransactions();
            producer.beginTransaction();
            try {
                producer.send(new ProducerRecord<>("transaction-demo", "k1", "committed-A")).get();
                producer.send(new ProducerRecord<>("transaction-demo", "k2", "committed-B")).get();
                producer.commitTransaction();
                System.out.println("transaction-1: committed");
            } catch (Exception e) {
                // 当前事务内任一步失败时,中止事务,不把部分成功暴露给 read_committed 消费者。
                producer.abortTransaction();
                throw e;
            }
            producer.beginTransaction();
            producer.send(new ProducerRecord<>("transaction-demo", "k3", "aborted-C")).get();
            producer.abortTransaction();
            System.out.println("transaction-2: aborted");
        }
    }
}
预期输出:
transaction-1: committed
transaction-2: aborted
用 read_committed 验证
在上述全新 Topic 上运行控制台消费者,并把隔离级别设为 read_committed。它会读取第一个事务的两条记录,而跳过第二个已中止事务中的 aborted-C。
kafka-console-consumer.sh --bootstrap-server localhost:9092 --topic transaction-demo --from-beginning --isolation-level read_committed --max-messages 2预期输出:
committed-A
committed-B
实际启动脚本路径可能因 Kafka 安装方式而不同,可将命令名替换为环境中的 <PATH>。如果使用默认的 read_uncommitted 读取方式,则可能看到已中止事务产生的记录,因此验证事务语义时必须明确消费者隔离级别。
transactional.id 的边界
同一个 transactional.id 只应代表一个同时活跃的逻辑写入者。新实例接管这个 ID 后,旧 Producer 后续可能收到 fencing 相关异常;这类错误不能靠继续重试旧实例解决,应关闭旧 Producer,并由拥有当前事务身份的实例继续工作。
Kafka 事务只原子化 Kafka 内部的相关写入,并不会自动把关系数据库更新、HTTP 请求或第三方系统操作纳入同一个事务。如果业务要求“数据库变更与 Kafka 事件不可分割”,通常需要 Outbox、CDC 或其他跨系统一致性设计,而不是直接把外部操作塞进 Kafka 事务。
事务适用于真正需要一组 Kafka 写入共同提交的场景;如果需求只是避免发送重试造成重复,幂等生产者更简单,开销和运维复杂度也更低。