
消息队列 / 系统课时
批处理与压缩配置
批处理与压缩配置
Producer 吞吐并不是由某一个“越大越好”的参数决定。batch.size、linger.ms、buffer.memory 和 compression.type 分别控制批次上限、等待时间、待发送缓冲容量与批次压缩方式,调优时必须同时观察吞吐、尾延迟、内存和 CPU。
学习目标
- 理解四个 Producer 配置在发送链路中的作用边界
- 能写出一组偏吞吐型的批处理与压缩配置
- 能用同一负载对比参数调整前后的吞吐、延迟与资源变化
批次是怎样形成的
Producer 会按目标分区累积待发送记录。同一分区的批次达到 batch.size 上限时可以立即发送;未达到上限时,linger.ms 允许短暂等待更多记录进入同一批次。buffer.memory 约束整个 Producer 用于待发送记录的缓冲空间,而压缩是在批次层面进行,因此更充实的批次通常也更利于压缩。
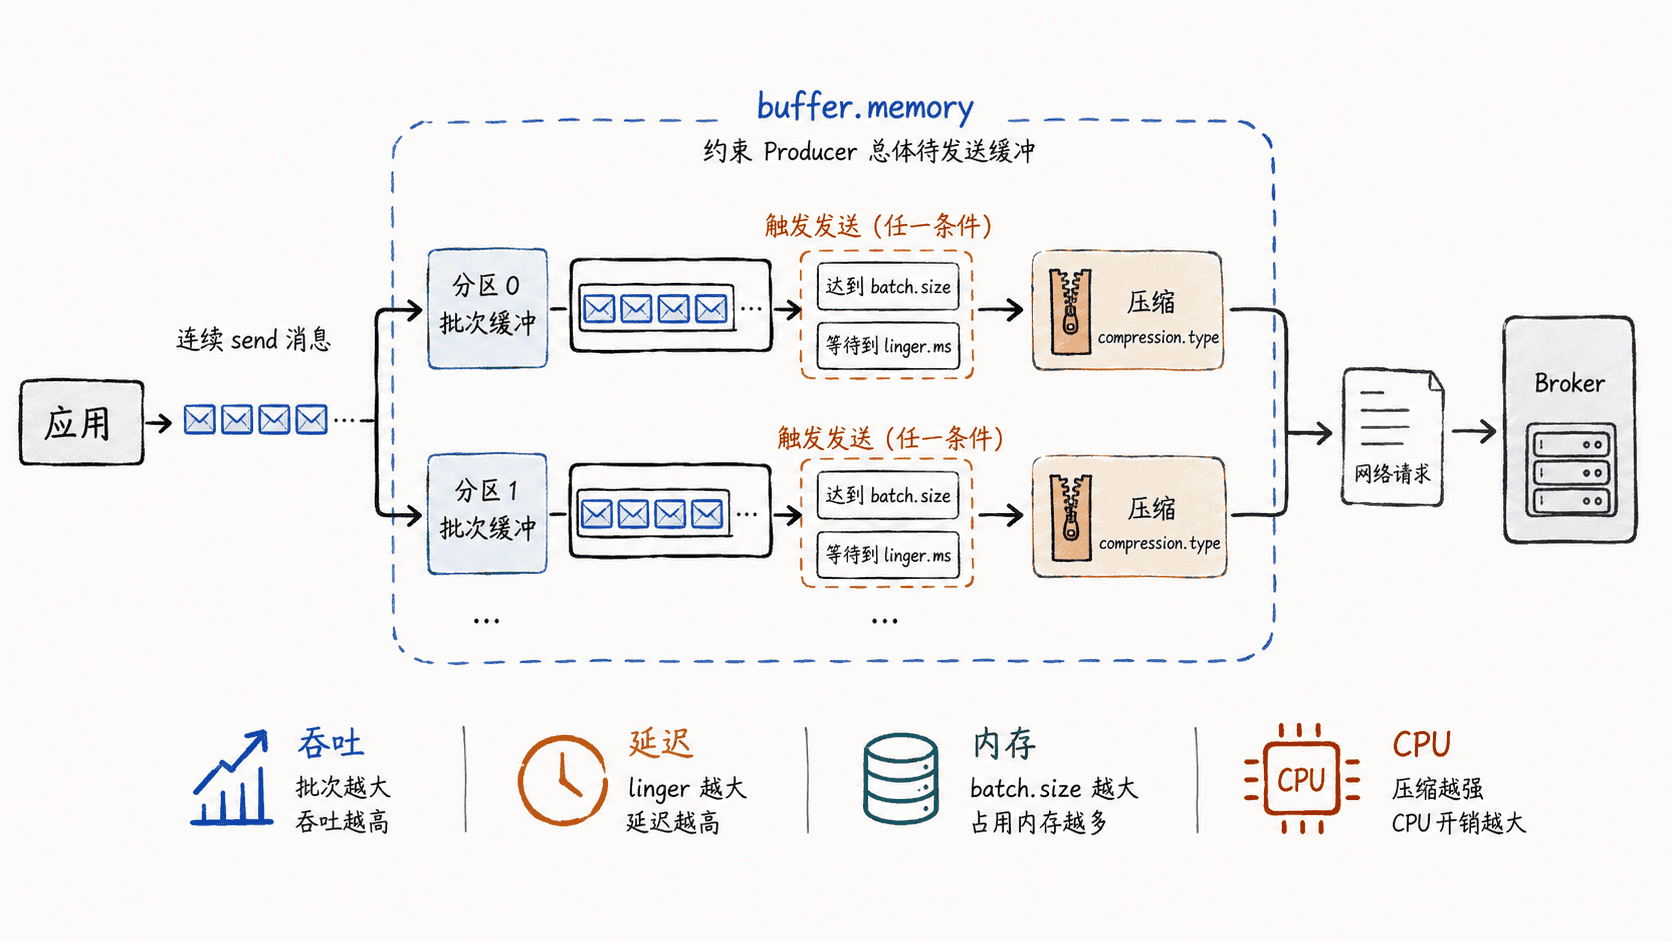
这四个参数不要孤立理解:
| 配置 | 直接作用 | 调得过激时的风险 |
|---|---|---|
batch.size |
单个分区批次的目标上限 | 太小导致请求增多;太大增加缓冲占用 |
linger.ms |
批次未满时最多再等多久 | 太高会增加低流量场景延迟 |
buffer.memory |
Producer 待发送记录的总体缓冲预算 | 太小更容易因背压而阻塞发送线程 |
compression.type |
对批次进行压缩 | 更省网络,但增加压缩与解压 CPU |
配置一个偏吞吐的起点
下面是一组可作为压测起点的 Producer 配置,不是生产环境的固定答案。数值应结合平均消息大小、活跃分区数、目标延迟和 JVM 内存重新测量。
bootstrap.servers=localhost:9092
key.serializer=org.apache.kafka.common.serialization.StringSerializer
value.serializer=org.apache.kafka.common.serialization.StringSerializer

batch.size=65536
linger.ms=10
buffer.memory=67108864
compression.type=zstd
生效行为:同一分区会尽量形成更大的批次,批次未满时最多额外等待约 10 ms;Producer 为待发送数据保留约 64 MiB 的缓冲预算,并使用 Zstandard 压缩批次。压缩还会使用额外内存和 CPU,因此 buffer.memory 不等于 Producer 进程的总内存上限。
按约束逐项调优
先固定消息大小、发送速率、分区数、acks 和 Broker 环境,只改一个变量,否则无法判断收益来自哪里。建议从低风险顺序开始:先观察批次是否过小,再小幅提高 linger.ms,随后评估 batch.size,最后比较不同压缩算法对网络与 CPU 的影响。
当发送速度持续高于 Broker 消化速度时,扩大 batch.size 并不能解决背压;此时待发送数据仍会消耗 buffer.memory。缓冲空间耗尽后,新的发送调用可能等待可用内存,并受 max.block.ms 约束。因此调优不能只看 records/s,还要同时看发送延迟、客户端 CPU、网络流量和缓冲等待。
验证配置是否真的有效
同一压测流量下至少记录四类结果:每秒发送记录数、平均与高分位发送延迟、Producer 进程 CPU/内存、网络发送字节数。若提高 linger.ms 后吞吐几乎不变但尾延迟明显上升,应回退;若启用压缩后网络显著下降而 CPU 仍有余量,则压缩是有效收益。
判断参数是否合适的标准不是“批次越大越好”,而是在业务允许的延迟和内存范围内,让请求更密集、网络更经济,并且不把瓶颈转移到客户端 CPU 或缓冲等待。