
消息队列 / 系统课时
确认机制与重试策略
确认机制与重试策略
本课解决 Producer 发送失败时“到底等多久、重试几次、何时算成功”的问题。完成后你能把 acks、retries、request.timeout.ms 与 delivery.timeout.ms 放到同一条投递链路里,既提高可靠性,又避免无界等待和失控重试。
学习目标
- 区分
acks=0、acks=1与acks=all的确认强度和失败窗口 - 用请求超时与投递总时限共同约束 Producer 重试
- 理解幂等生产如何降低客户端重试造成的重复与乱序风险
先把四个参数放到同一条链路
acks 决定一次 Produce 请求满足什么条件才算被 broker 确认;request.timeout.ms 限制客户端等待这一次请求响应的时间;遇到可重试错误后,retries 控制最多允许多少次自动重试;delivery.timeout.ms 则给单条记录从 send() 返回后到最终成功或失败设置总预算。
| 配置 | 核心含义 | 关键风险 |
|---|---|---|
acks=0 |
不等待 broker 确认 | 客户端通常无法感知发送失败,retries 基本无法发挥作用 |
acks=1 |
leader 本地写入后即可确认 | leader 在副本同步前故障时可能丢失已确认记录 |
acks=all |
等待当前 ISR 满足确认要求 | 延迟通常更高,但提供最强的可用确认语义 |
acks=all 仍要与 broker/topic 的 min.insync.replicas 配合:当可用 ISR 数量不足时,broker 会拒绝写入,而不是把“全确认”退化成单副本确认。
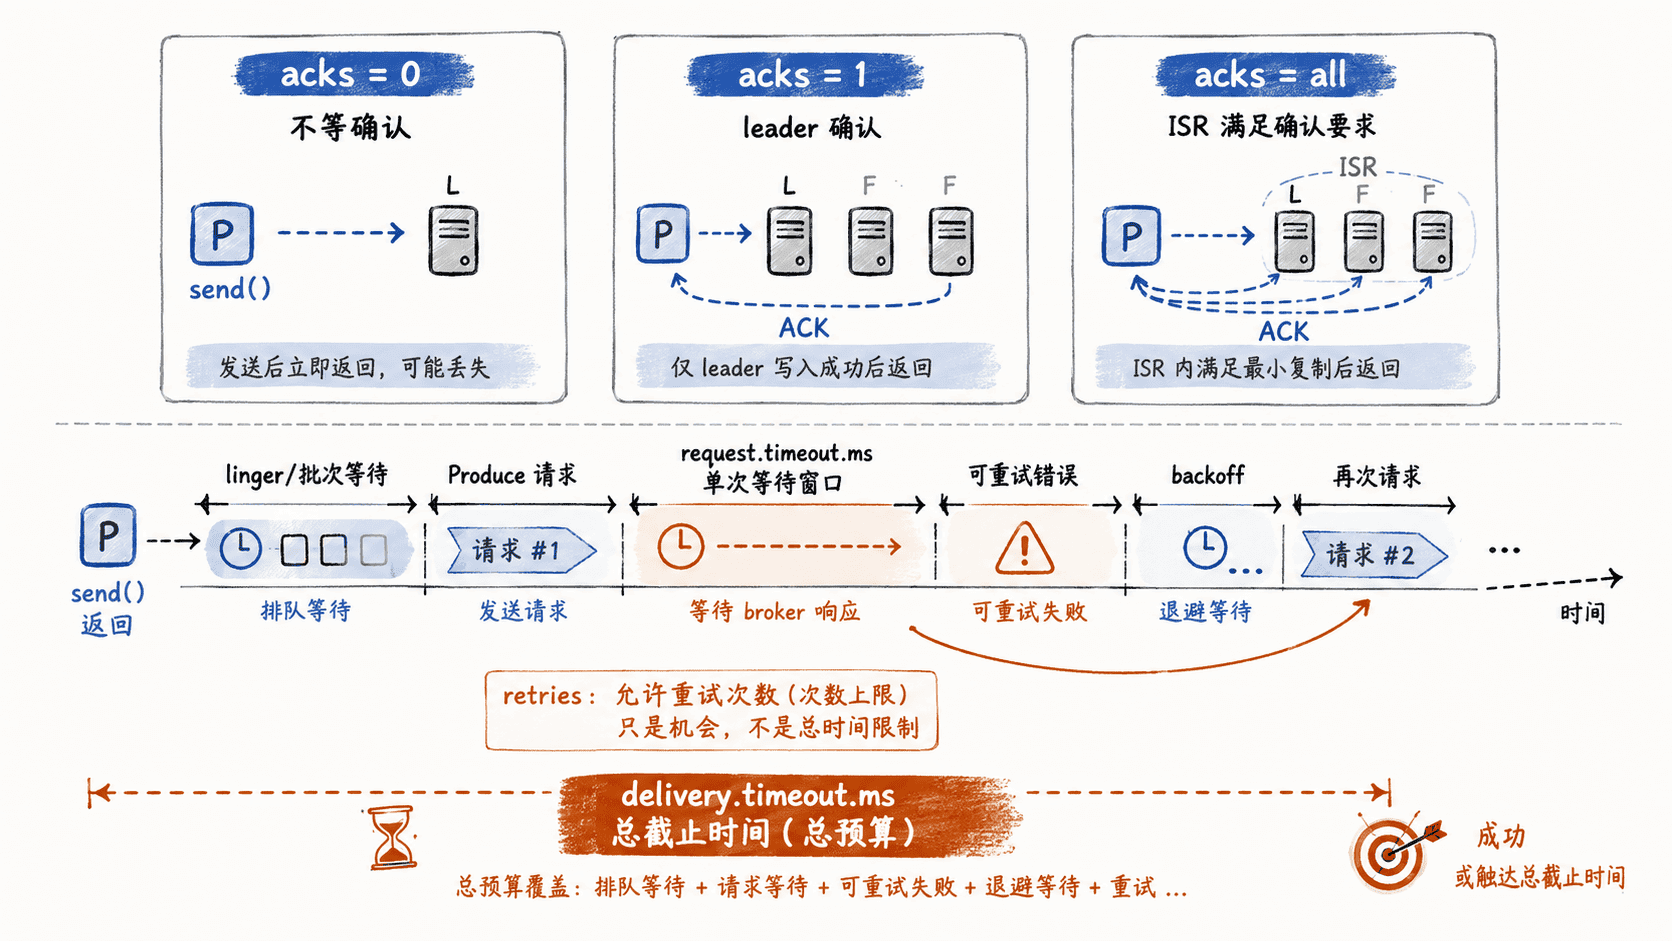
配一组有界的可靠性参数
下面是 Producer 配置片段,适合“宁可明确失败,也不希望长时间悬挂”的常见业务。显式写出最大 retries 是为了说明它不会导致无限等待:真正约束单条记录生命周期的是 delivery.timeout.ms。
bootstrap.servers=localhost:9092
acks=all
enable.idempotence=true
retries=2147483647
request.timeout.ms=30000
delivery.timeout.ms=120000
linger.ms=5
预期结果:集群健康时记录在满足 acks=all 后成功;遇到短暂网络或 broker 故障时,客户端会在总投递预算内自动重试;如果一直无法完成投递,记录最迟在 delivery.timeout.ms 约束下进入失败路径。不可重试错误或更早到期的批次可能让失败提前发生。
这里有一个必须满足的关系:delivery.timeout.ms 应不小于 request.timeout.ms + linger.ms。不要用“把 retries 调得很大”代替总时限设计,因为一次投递还包含批次等待、重试退避、元数据刷新和多次请求等待。
幂等性决定重试是否安全
现代 Kafka Java Producer 在没有冲突配置时默认启用幂等性。显式设置 enable.idempotence=true 时,需要 acks=all、retries>0,并让 max.in.flight.requests.per.connection 不超过 5;这能让 Producer 自身对同一记录的网络重试避免重复写入,并保持分区内发送顺序。
如果显式关闭幂等性,同时允许重试且 max.in.flight.requests.per.connection>1,前一个批次失败重试、后一个批次先成功时,就可能发生同一分区内的重排。
失败后只做一次明确决策
应用层不要在 send() 之后立刻再套一个无条件重试循环,否则会与客户端内部重试叠加。更稳妥的做法是先让 Producer 在 delivery.timeout.ms 内完成自己的重试,只有收到最终失败后,业务层才决定记录告警、进入补偿队列、持久化待重放事件或直接失败。
生产环境调参时,先确定业务允许的最大投递延迟,再给 delivery.timeout.ms 设上界;随后设置合理的单次 request.timeout.ms,最后确认 acks、幂等性和 broker 端副本策略一致。这样重试次数可以很大,但等待时间始终是有界且可解释的。