
消息队列 / 系统课时
部署 Sink Connector
部署 Sink Connector
这一课把 Kafka Topic 的数据可靠写入外部系统,并把最容易出问题的批量、幂等、重试和限流放进同一套配置与验收流程。最终要确认的不只是 Connector 在运行,还要确认目标端没有重复、堆积或被重试风暴压垮。
学习目标
- 配置 Sink Connector 的目标 Topic、批量写入与重试参数
- 用幂等写入降低任务重启或重复投递造成的数据重复
- 结合 Task 状态、消费滞后和目标端限流判断写入健康度
明确 Sink 的可靠性边界
Kafka Connect Sink Task 会从 Kafka 拉取记录,再批量写入目标系统。一次批次在目标端成功但 offset 尚未提交时发生重启,记录可能再次投递,因此目标写入最好具备幂等语义。
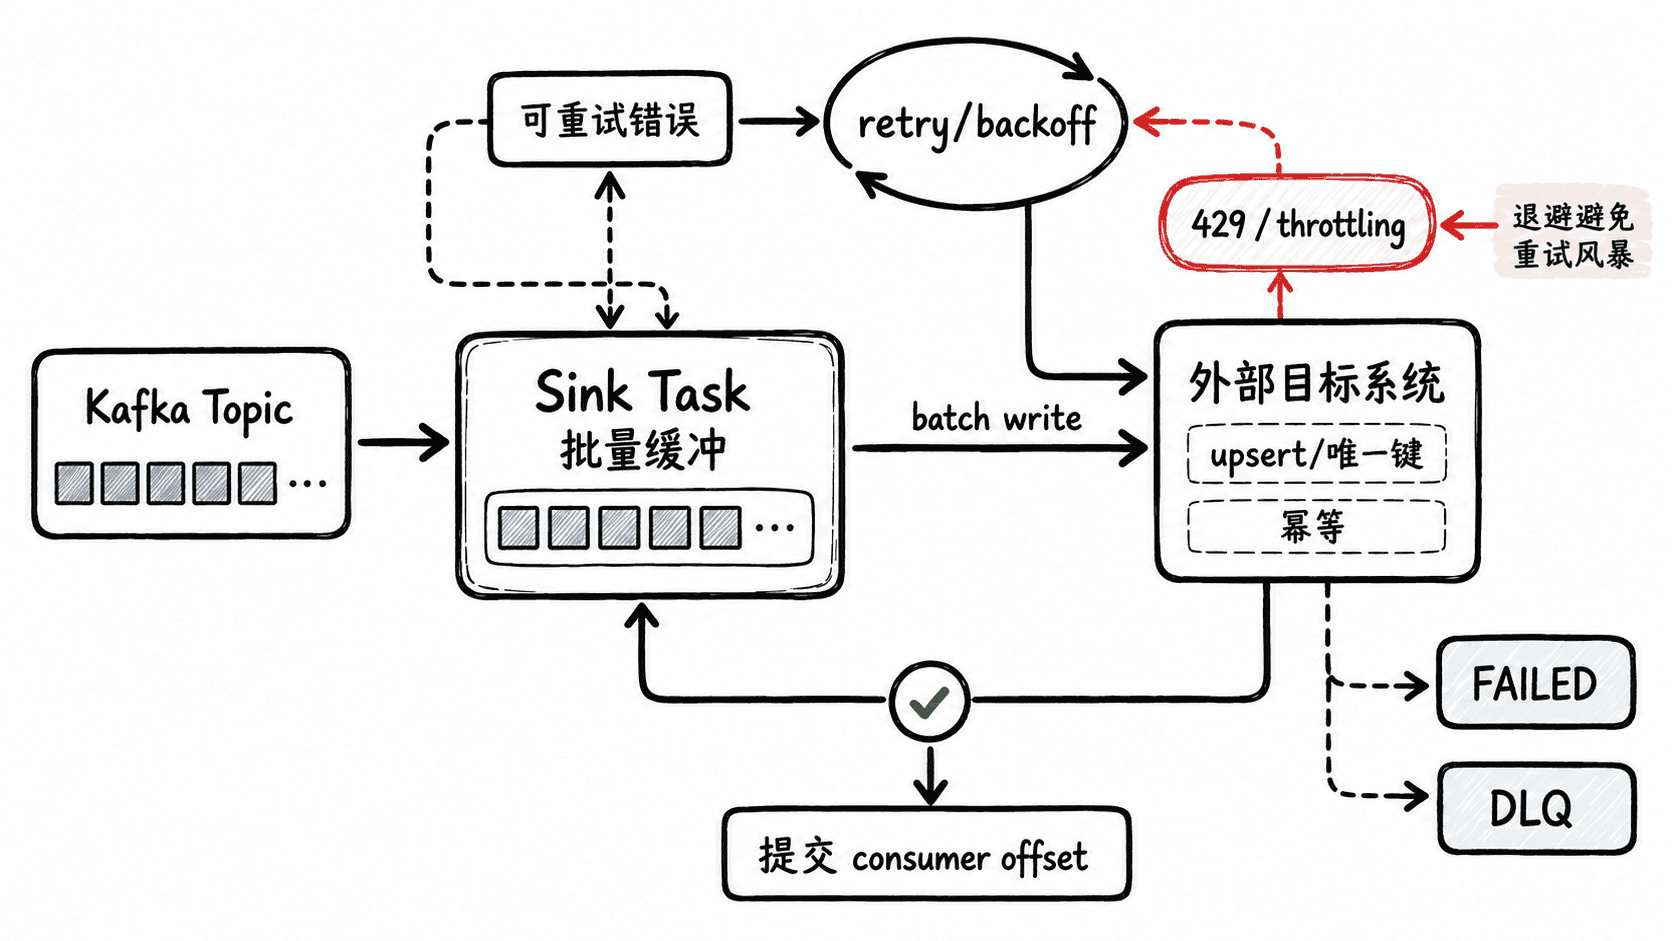
这里以常见的 JDBC Sink 为例。示例假设 Worker 已安装 JDBC Sink 插件,orders.enriched 中的记录包含 order_id 字段,数据库已存在 orders 表并以该字段为主键。
配置批量、幂等与重试
batch.size 控制单次数据库写入量,过小会增加往返开销,过大则会扩大单批失败成本。insert.mode=upsert 配合稳定主键,可以让同一业务记录重复到达时更新原行,而不是继续插入副本。
curl -s -X POST http://localhost:8083/connectors \
  -H 'Content-Type: application/json' \
  -d '{
    "name": "orders-jdbc-sink",
    "config": {
      "connector.class": "io.confluent.connect.jdbc.JdbcSinkConnector",
      "tasks.max": "2",
      "topics": "orders.enriched",
      "connection.url": "jdbc:postgresql://db:5432/app",
      "connection.user": "connect",
      "connection.password": "<VALUE>",
      "table.name.format": "orders",
      "insert.mode": "upsert",
      "pk.mode": "record_value",
      "pk.fields": "order_id",
      "batch.size": "500",
      "max.retries": "8",
      "retry.backoff.ms": "3000",
      "errors.tolerance": "all",
      "errors.deadletterqueue.topic.name": "sink-errors"
    }
  }'
预期结果
{"name":"orders-jdbc-sink","config":{"connector.class":"io.confluent.connect.jdbc.JdbcSinkConnector","tasks.max":"2","topics":"orders.enriched","connection.url":"jdbc:postgresql://db:5432/app","connection.user":"connect","connection.password":"<VALUE>","table.name.format":"orders","insert.mode":"upsert","pk.mode":"record_value","pk.fields":"order_id","batch.size":"500","max.retries":"8","retry.backoff.ms":"3000","errors.tolerance":"all","errors.deadletterqueue.topic.name":"sink-errors"},"tasks":[],"type":"sink"}密码示例使用 <VALUE> 占位符,生产环境不要把真实凭据直接写进可共享配置;优先使用 Connect ConfigProvider 或平台的密钥管理能力。
验证 Task 与目标端写入
先检查 Connector 与 Task 状态,再查询目标表。只有状态正常且目标端实际出现数据,才算写入链路建立成功。
curl -s http://localhost:8083/connectors/orders-jdbc-sink/status

psql 'postgresql://connect:<VALUE>@db:5432/app' \
  -c 'SELECT order_id, status FROM orders ORDER BY order_id LIMIT 5;'
预期输出
{"name":"orders-jdbc-sink","connector":{"state":"RUNNING","worker_id":"<IP>:<PORT>"},"tasks":[{"id":0,"state":"RUNNING","worker_id":"<IP>:<PORT>"}],"type":"sink"}
 order_id  | status
-----------+--------
 <ID>      | <VALUE>
Task 数量可能小于 tasks.max,因为最终并行度还受 Topic 分区数和 Connector 实现约束。若 Task 为 FAILED,先读 trace,不要仅通过反复重启掩盖认证、表结构或序列化错误。
处理限流与重试风暴
外部系统出现 429、超时或连接池耗尽时,最危险的做法是立即高频重试。合理策略是降低批量或并发、增加退避,并观察 Kafka 侧 lag 是否持续扩大;lag 上升说明 Sink 消费速度低于生产速度。
kafka-consumer-groups.sh \
  --bootstrap-server localhost:9092 \
  --all-groups \
  --describe | grep orders.enriched
预期输出
<GROUP> orders.enriched <PARTITION> <CURRENT-OFFSET> <LOG-END-OFFSET> <LAG> <CONSUMER-ID> <HOST> <CLIENT-ID>实际 group 名称、分区和 offset 会不同。若 <LAG> 持续增加,同时目标端出现限流,应先降低 tasks.max 或目标端并发压力,再根据数据库吞吐调整 batch.size 与退避参数,而不是无限提高重试次数。
Sink Connector 的验收应同时看四件事:Task 持续运行、目标端数据正确、重复投递不会制造脏数据、发生限流或短暂故障时重试受控且 lag 能恢复。只看 REST 状态为 RUNNING,不足以证明写入链路可靠。