
消息队列 / 系统课时
Kafka Connect 架构
Kafka Connect 架构
本课把 Kafka Connect 中容易混在一起的角色拆开:Worker 提供运行时,Connector 决定连接逻辑,Task 承担并行工作,Converter 负责 Kafka 字节与 Connect 数据模型之间的转换,Offset 记录处理位置。读完后你能看懂分布式模式下它们如何协同。
学习目标
- 区分 Worker、Connector、Task、Converter 和 Offset 的职责边界
- 理解分布式 Worker 集群如何分配 Connector 与 Task
- 能通过配置和 REST 状态接口验证 Connect 是否按预期运行
运行关系先看整体
在分布式模式中,多台 Worker 使用相同的 group.id 组成一个 Connect 集群。提交 Connector 配置后,集群负责选择 Worker 运行 Connector 实例,并把它创建的多个 Task 分配到可用 Worker。Worker 故障或成员变化时会触发重新分配。
Converter 不负责访问外部系统。Source Connector 先把外部数据变成 ConnectRecord,再由 Converter 序列化后写入 Kafka;Sink Connector 则先由 Converter 把 Kafka 字节反序列化成 ConnectRecord,再交给 Connector/Task 写向外部系统。
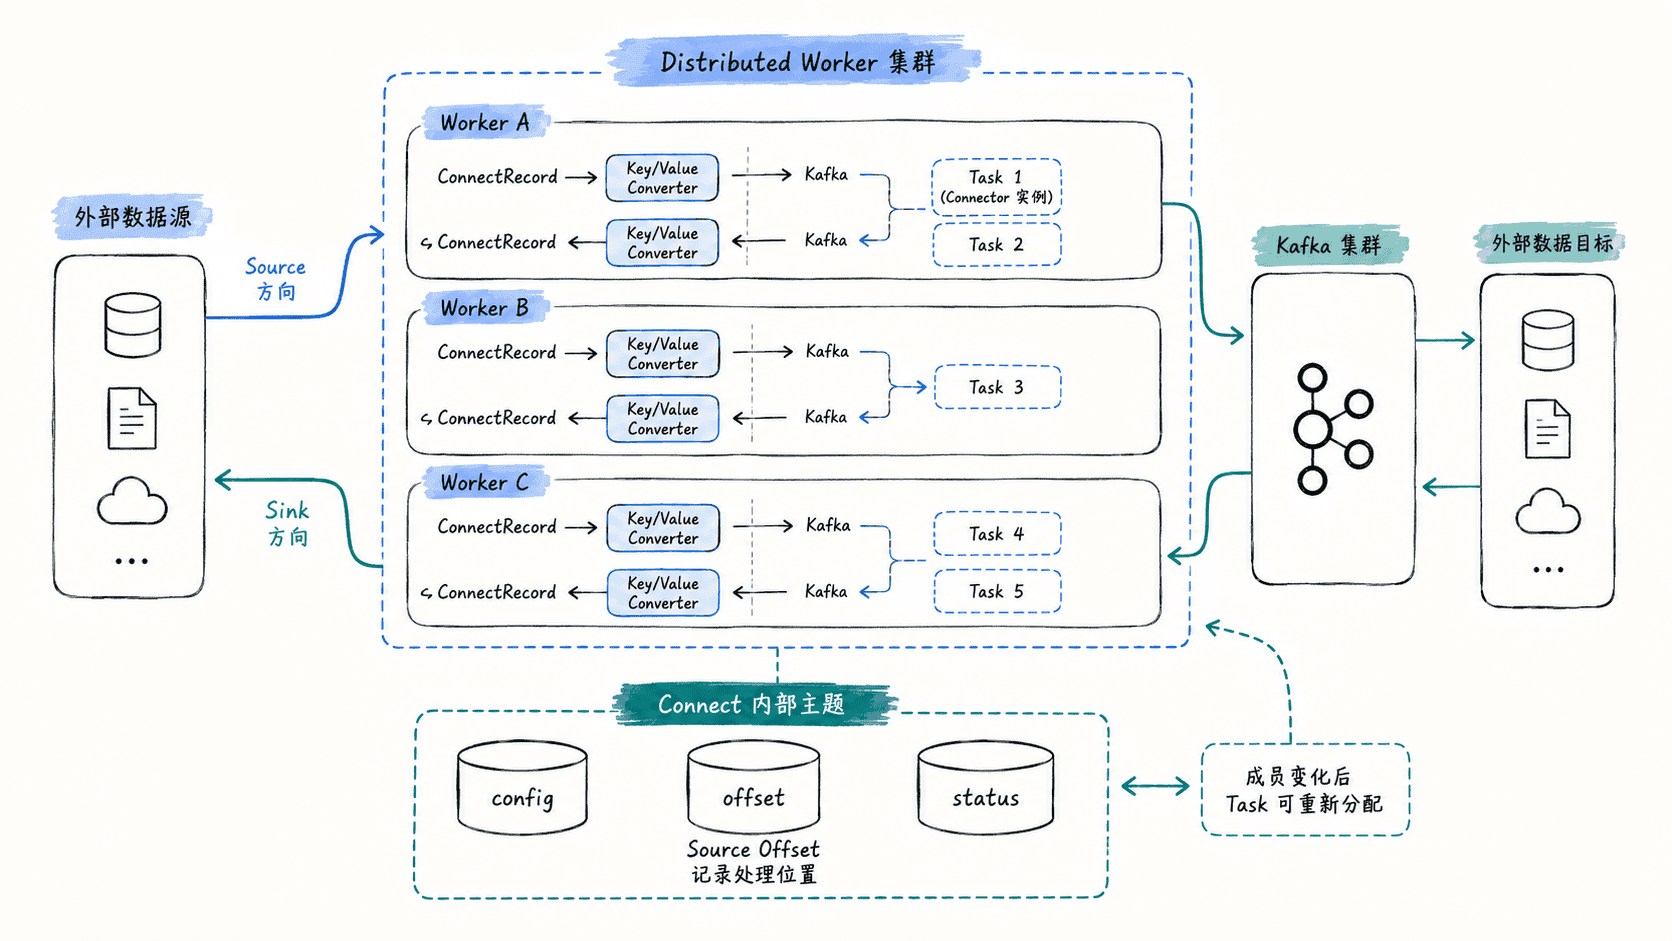
Worker 是运行时,Connector 是逻辑入口
Worker 负责加载插件、提供 REST API、执行 Connector 和 Task,并管理序列化、错误处理等通用能力。分布式 Worker 需要共享 Kafka 集群地址、group.id 和三类内部存储主题。一个最小配置可以写成:
bootstrap.servers=kafka-1:9092,kafka-2:9092,kafka-3:9092
group.id=connect-cluster-a
config.storage.topic=connect-configs
offset.storage.topic=connect-offsets
status.storage.topic=connect-status
key.converter=org.apache.kafka.connect.storage.StringConverter
value.converter=org.apache.kafka.connect.json.JsonConverter
value.converter.schemas.enable=false
这段配置生效后,使用同一 group.id 的 Worker 会加入同一个 Connect 集群;Connector 配置、Source Offset 与运行状态分别持久化到对应内部主题。验证时应确认这些主题可用,并通过 REST API 查看 Connector 状态。
Connector 本身描述“连哪里、怎么读或写、需要多少并行度”。它不会把所有数据处理都塞在一个线程里,而是根据配置创建 Task。Task 才是实际执行读取或写入的工作单元,因此吞吐扩展主要发生在 Task 层。
Task、Converter 与 Offset 各管一件事
Task 数量由 Connector 能力和配置共同决定,并不保证设置 tasks.max=10 就一定产生 10 个 Task。某些数据源天生只有一个可并行工作单元,Connector 会创建更少的 Task。
Converter 只处理 Kafka 侧的键和值编码。JSON、Avro、Protobuf 或字符串等格式的选择会影响 Kafka 中实际字节表示,但不会替代 Connector 对外部系统协议的解析。Schema Registry 之类的能力是否需要,取决于所选 Converter,而不是 Connect 架构本身强制要求。
Offset 的含义与方向有关。Source Connector 需要记录“外部数据读到哪里”,分布式模式通常把这类 Source Offset 存入 offset.storage.topic;Sink Connector 消费 Kafka 时,消费进度遵循 Kafka Consumer 的位点机制。恢复任务时,正确的 Offset 能避免从错误位置重新开始。
用 REST 状态验证分配结果
当 Connector 已创建后,可以直接查询状态,确认 Connector 实例和各 Task 当前运行在哪个 Worker。下面使用环境变量避免把地址和名称写死。
set -euo pipefail
CONNECT_URL="${CONNECT_URL:-http://localhost:8083}"
CONNECTOR="${CONNECTOR:-orders-source}"

curl -s "$CONNECT_URL/connectors/$CONNECTOR/status"
预期结果
{
  "name": "orders-source",
  "connector": {
    "state": "RUNNING",
    "worker_id": "<HOST>:<PORT>"
  },
  "tasks": [
    {
      "id": 0,
      "state": "RUNNING",
      "worker_id": "<HOST>:<PORT>"
    }
  ],
  "type": "source"
}
实际 Task 数量、worker_id 和状态会随集群分配变化。判断分布式模式是否正常,不应要求 Connector 与所有 Task 固定在同一台 Worker,而应关注它们是否处于期望状态、失败后能否重新分配,以及 Offset 是否让任务从正确位置继续处理。
理解这组边界后,排查 Connect 问题会更直接:插件和 REST 入口先看 Worker,连接参数看 Connector,吞吐与并发看 Task,数据编码看 Converter,重复或丢失风险则优先检查 Offset 与目标系统的幂等语义。