
消息队列 / 系统课时
磁盘与页缓存规划
磁盘与页缓存规划
Kafka 的日志几乎持续落盘,但性能并不只由磁盘标称吞吐决定。本课从写入量、保留周期、副本、磁盘水位和操作系统页缓存五个维度建立规划方法,并用主机命令核对实际磁盘与内存状态。
学习目标
- 根据写入速率、保留周期和副本因子估算 Broker 日志空间
- 理解 Kafka 顺序 I/O、操作系统页缓存与消费者读取之间的关系
- 使用磁盘水位和内存指标判断节点是否留有安全余量
从日志增长量开始算磁盘
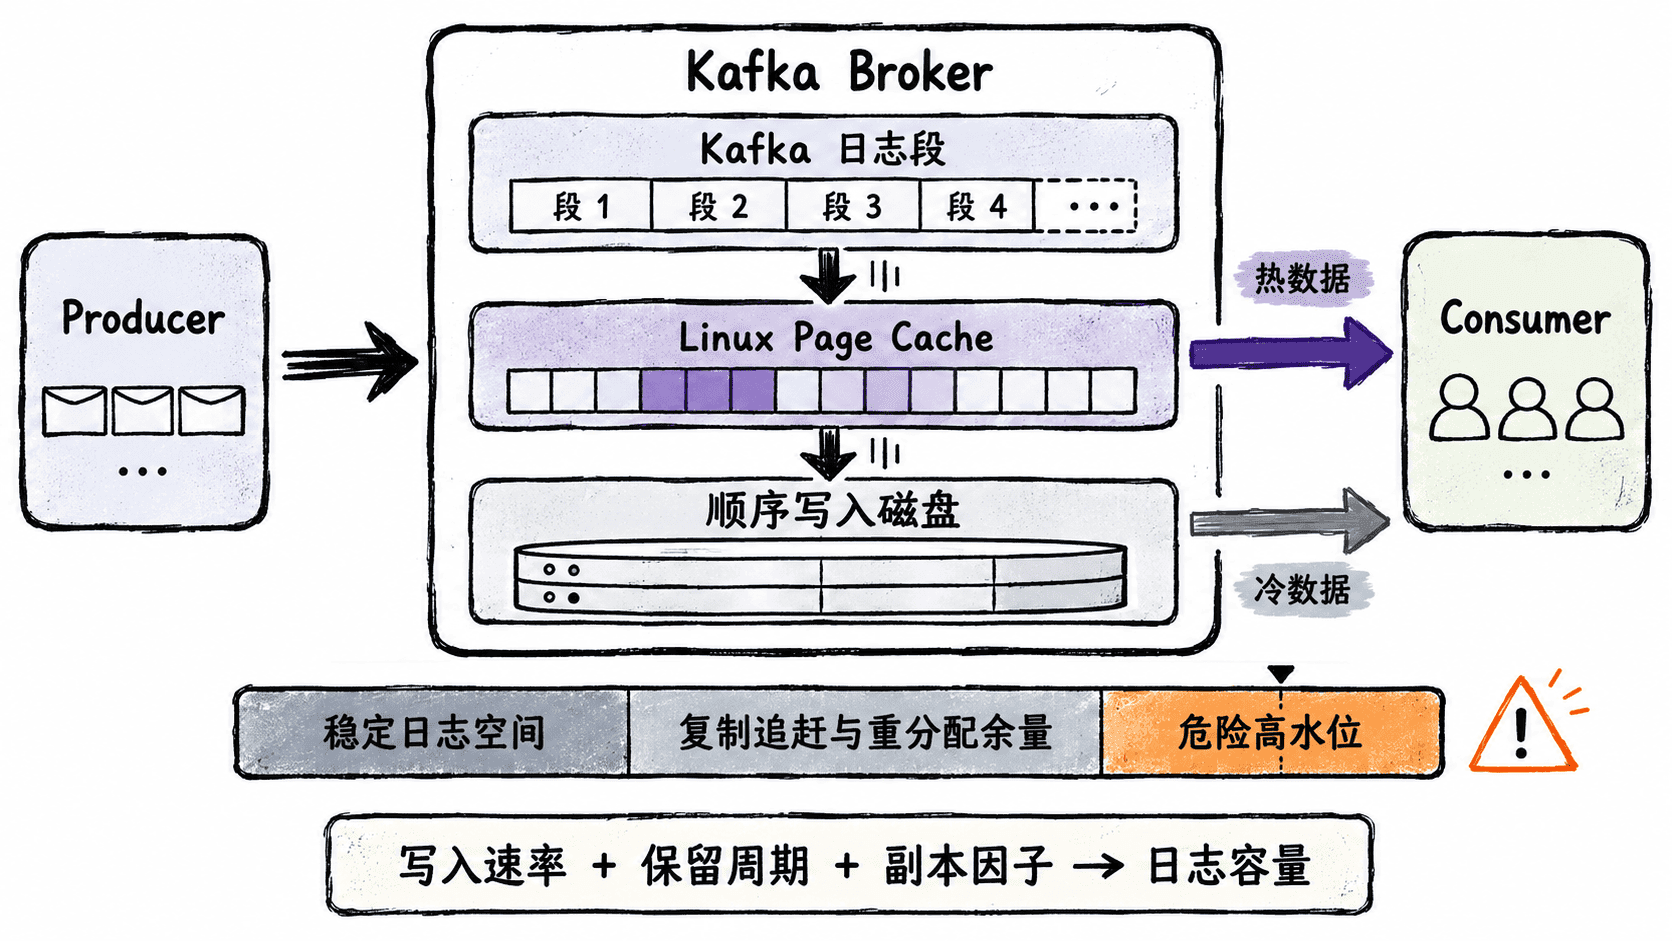
规划磁盘时不要从“这台机器有几 TB”开始,而应先计算日志每天增长多少。假设单个集群峰值业务数据写入速率为 MB/s,副本因子为 ,保留时间为 秒,则所有副本的基础日志量近似为:
例如业务数据平均写入 40 MB/s,副本因子为 3,保留 7 天,仅消息日志就约为 69 TB。实际规划还要为索引文件、日志段滚动、复制追赶、重分配和短期流量突发留出余量,因此不能把计算结果直接当作磁盘容量上限。
给磁盘留下可操作的水位
磁盘必须同时容纳正常日志和异常期间的临时增长。常见风险包括消费者无法及时处理但日志仍继续写入、Follower 长时间离线后重新同步,以及分区迁移期间新旧副本短暂共存。
可以把磁盘容量拆成“稳定数据区”和“操作余量”。例如把日常目标水位控制在 70% 左右,将剩余空间留给流量偏差、复制追赶和运维操作。具体阈值应结合磁盘规模、扩容速度和告警体系制定,而不是机械使用一个固定比例。
页缓存决定热数据读取效率
Kafka 通常依赖操作系统页缓存,而不是在 JVM 中维护巨大的应用级数据缓存。Producer 写入日志后,数据首先进入操作系统缓存并最终刷入磁盘;Consumer 如果很快读取这些日志,往往可以直接命中页缓存,减少物理磁盘读取。
因此 Broker 内存不能只按 JVM Heap 规划。给 JVM 分配过多堆内存,会压缩 Linux 可用于页缓存的空间;而堆设置过小又可能增加 GC 压力。规划时应同时观察 JVM、系统可用内存和页缓存,而不是追求“空闲内存越多越好”。Linux 会主动使用空闲内存做缓存,这是正常现象。
在 Broker 上核对实际资源
下面的命令可以同时查看 Kafka 日志目录容量、当前占用和系统内存。将 LOG_DIR 改为 Broker 实际的 log.dirs 路径。
LOG_DIR=/var/lib/kafka/data
df -h "$LOG_DIR"
du -sh "$LOG_DIR"
free -h
预期输出如下,容量和内存数值会因主机而不同:
Filesystem      Size  Used Avail Use% Mounted on
/dev/<ID>       <VALUE> <VALUE> <VALUE> <VALUE>% /var/lib/kafka
<VALUE>         /var/lib/kafka/data
               total        used        free      shared  buff/cache   available
Mem:           <VALUE>     <VALUE>     <VALUE>     <VALUE>     <VALUE>     <VALUE>
Swap:          <VALUE>     <VALUE>     <VALUE>
如果日志目录持续接近高水位,同时 available 内存仍较充足,优先解决磁盘容量问题;如果磁盘尚有余量,但消费者追赶时磁盘读取明显升高并伴随页缓存不足,则需要重新评估内存、JVM Heap 与热点工作集大小。
用增长速度校准规划
静态容量计算只能给出初始值。更可靠的方法是记录业务高峰期间日志目录每小时或每天的实际增长量,再按计划保留周期外推,并与理论写入量比较。两者差距往往来自压缩率、流量峰谷、日志清理延迟以及分区副本重新同步。
最终规划应同时满足三个条件:正常情况下磁盘长期低于目标水位;节点失效或重分配时仍有复制余量;高峰期近期写入的数据可以尽可能保留在页缓存中。只有磁盘容量和内存工作集一起规划,Kafka 的顺序 I/O 优势才能稳定发挥。