
消息队列 / 系统课时
消息键与分区路由
消息键与分区路由
生产者发送消息时,Kafka 必须决定它进入哪个 Partition。这个决定不仅影响负载是否均衡,还直接决定哪些消息能保持相对顺序。本课从 Key、默认分区器和自定义策略出发,建立一套可验证的路由设计方法。
学习目标
- 理解 Key 如何参与默认分区路由并形成局部顺序
- 分辨无 Key、稳定 Key 与自定义分区策略的适用场景
- 能识别热点 Key、分区扩容和自定义分区器带来的边界
Key 把相关消息绑定到同一分区
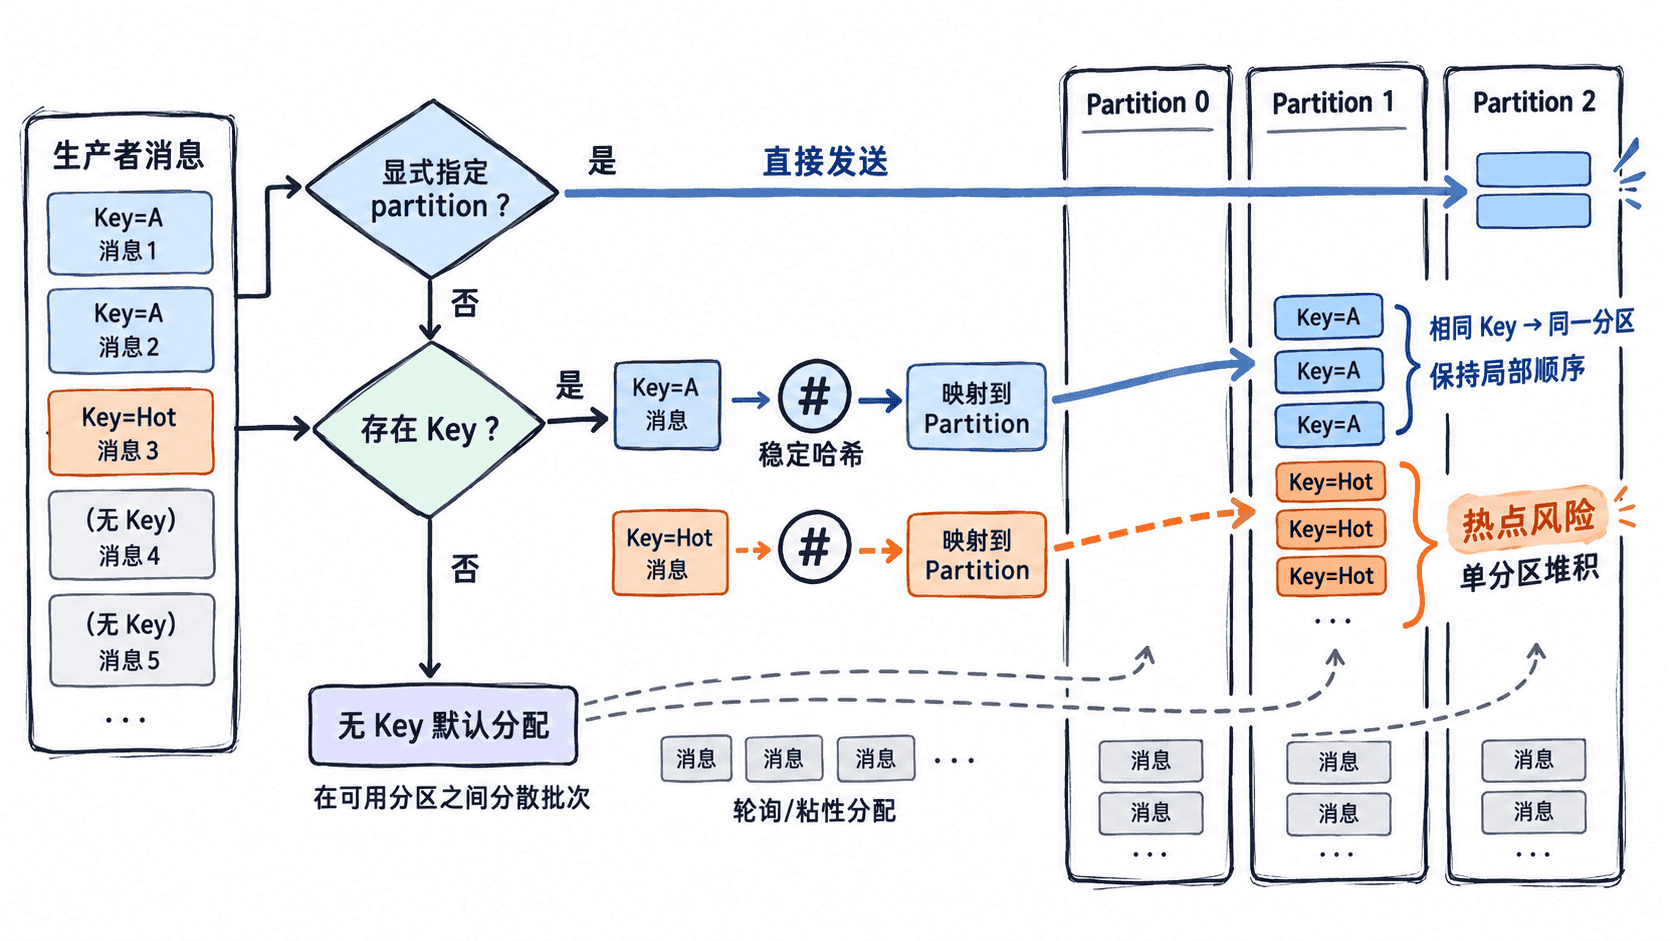
当消息携带 Key 时,Kafka 生产者会使用分区器根据 Key 计算目标 Partition。只要 Topic 的分区数量不变、分区算法不变,同一个 Key 通常会稳定映射到同一 Partition,因此同一业务实体的消息可以在该分区内保持写入顺序。
例如订单事件可以使用 orderId 作为 Key。order-1001 的“创建、支付、发货”事件会进入同一个 Partition,而其他订单可以落在不同 Partition,从而同时获得局部有序与并行处理能力。
默认路由不是简单轮询
在当前 Kafka Java Producer 中,如果记录没有显式指定 Partition,分区器会先考虑 Key;有 Key 时按 Key 的序列化字节计算分区。没有 Key 时,生产者会倾向把一批记录粘在同一可用分区上,再在合适时机切换,以提高批处理和压缩效率,而不是逐条消息机械轮询。
因此,无 Key 适合不要求实体级顺序、主要追求均衡吞吐的事件流;有 Key 适合需要把同一实体的事件固定到一个 Partition 的场景。选择 Key 时,应让不同 Key 的流量尽量分散,避免单个超高频 Key 把某个 Partition 打成热点。
用代码观察 Key 的路由结果
下面的 Java 示例使用 Kafka Producer 发送两组订单事件,并打印 Broker 返回的 Partition 与 offset。示例依赖官方 kafka-clients,并假设 orders Topic 已存在且至少有 3 个 Partition。
import java.util.Properties;
import org.apache.kafka.clients.producer.KafkaProducer;
import org.apache.kafka.clients.producer.ProducerRecord;
import org.apache.kafka.clients.producer.RecordMetadata;
import org.apache.kafka.common.serialization.StringSerializer;

public class KeyRoutingDemo {
    public static void main(String[] args) throws Exception {
        Properties props = new Properties();
        props.put("bootstrap.servers", "localhost:9092");
        props.put("key.serializer", StringSerializer.class.getName());
        props.put("value.serializer", StringSerializer.class.getName());

        try (KafkaProducer<String, String> producer = new KafkaProducer<>(props)) {
            send(producer, "order-1001", "created");
            send(producer, "order-1001", "paid");
            send(producer, "order-2002", "created");
        }
    }

    private static void send(KafkaProducer<String, String> producer,
                             String key,
                             String value) throws Exception {
        // 相同订单号作为 Key,用于稳定路由到同一分区。
        ProducerRecord<String, String> record =
                new ProducerRecord<>("orders", key, value);
        RecordMetadata meta = producer.send(record).get();
        System.out.printf("key=%s partition=%d offset=%d%n",
                key, meta.partition(), meta.offset());
    }
}
预期输出满足“相同 Key 的两条消息分区号一致”;具体 Partition 与 offset 取决于 Topic 分区数和现有数据,因此实际值可能不同:
key=order-1001 partition=<ID> offset=<ID>
key=order-1001 partition=<ID> offset=<ID>
key=order-2002 partition=<ID> offset=<ID>
验证重点不是要求 order-1001 必须落到某个固定编号,而是确认它的两条记录进入同一 Partition。若随后增加 Topic 分区数,同一个 Key 的映射结果可能改变,所以扩容期间不能把“Key 永久对应某个分区编号”当作业务契约。
自定义分区器只在明确规则下使用
默认策略通常已经能覆盖“按 Key 保序”和“无 Key 均衡吞吐”两类主要需求。自定义分区器适用于路由规则本身就是业务要求的情况,例如按租户隔离、把特殊流量送入专用分区,或为了兼容既有分片规则。
自定义策略的代价是你必须自己保证分布均衡、分区数变化时的兼容性以及异常分区的回退行为。若规则只是“同一个用户进入同一分区”,使用稳定 Key 往往比编写自定义分区器更简单,也更容易维护。
选择路由策略的判断顺序
设计路由时先判断是否存在必须有序的业务边界:有,就选择能唯一代表该边界且分布较均匀的 Key;没有,就允许生产者采用无 Key 的默认分配方式。只有当默认规则无法表达业务约束时,再考虑显式 Partition 或自定义分区器。
最终要同时验证两件事:相同 Key 是否稳定落入同一 Partition,以及各 Partition 的消息量是否过度倾斜。顺序性和负载均衡不是二选一,好的 Key 应尽量让两者同时成立。