
消息队列 / 系统课时
Kafka 的一致性与可用性取舍
Kafka 的一致性与可用性取舍
Kafka 的可靠性不是一个单独开关,而是副本数量、ISR、生产者确认方式和故障选主策略共同作用的结果。本课把这些机制串起来,帮助你判断何时应该牺牲部分可用性来保护数据,以及哪些配置会改变延迟和吞吐。
学习目标
- 理解副本、Leader、ISR 与写入确认之间的关系
- 区分
acks=0、acks=1和acks=all带来的可靠性差异 - 能为重要业务选择合理的副本与故障恢复策略
Kafka 所说的可靠写入是什么
Kafka 的每个分区拥有一个 Leader 和若干 Follower。生产者只向 Leader 写入,Follower 持续复制 Leader 的日志。正常情况下,副本越充分,单台 broker 故障造成数据丢失的概率越低,但复制和确认也会增加等待时间与网络开销。
这里要区分两个问题:记录已经写到 Leader,不等于记录已经安全存在于足够多的副本中。生产者何时收到成功响应,由 acks 决定;集群允许在多少同步副本存活时继续接受写入,则与 min.insync.replicas 有关。
ISR 如何影响故障后的写入能力
ISR 是当前能够持续跟上 Leader 的同步副本集合。Follower 落后超过允许范围后会退出 ISR;恢复追赶后可以重新加入。Leader 故障时,Kafka通常从符合条件的同步副本中选择新的 Leader,从而尽量保证新 Leader 拥有已经复制的数据。
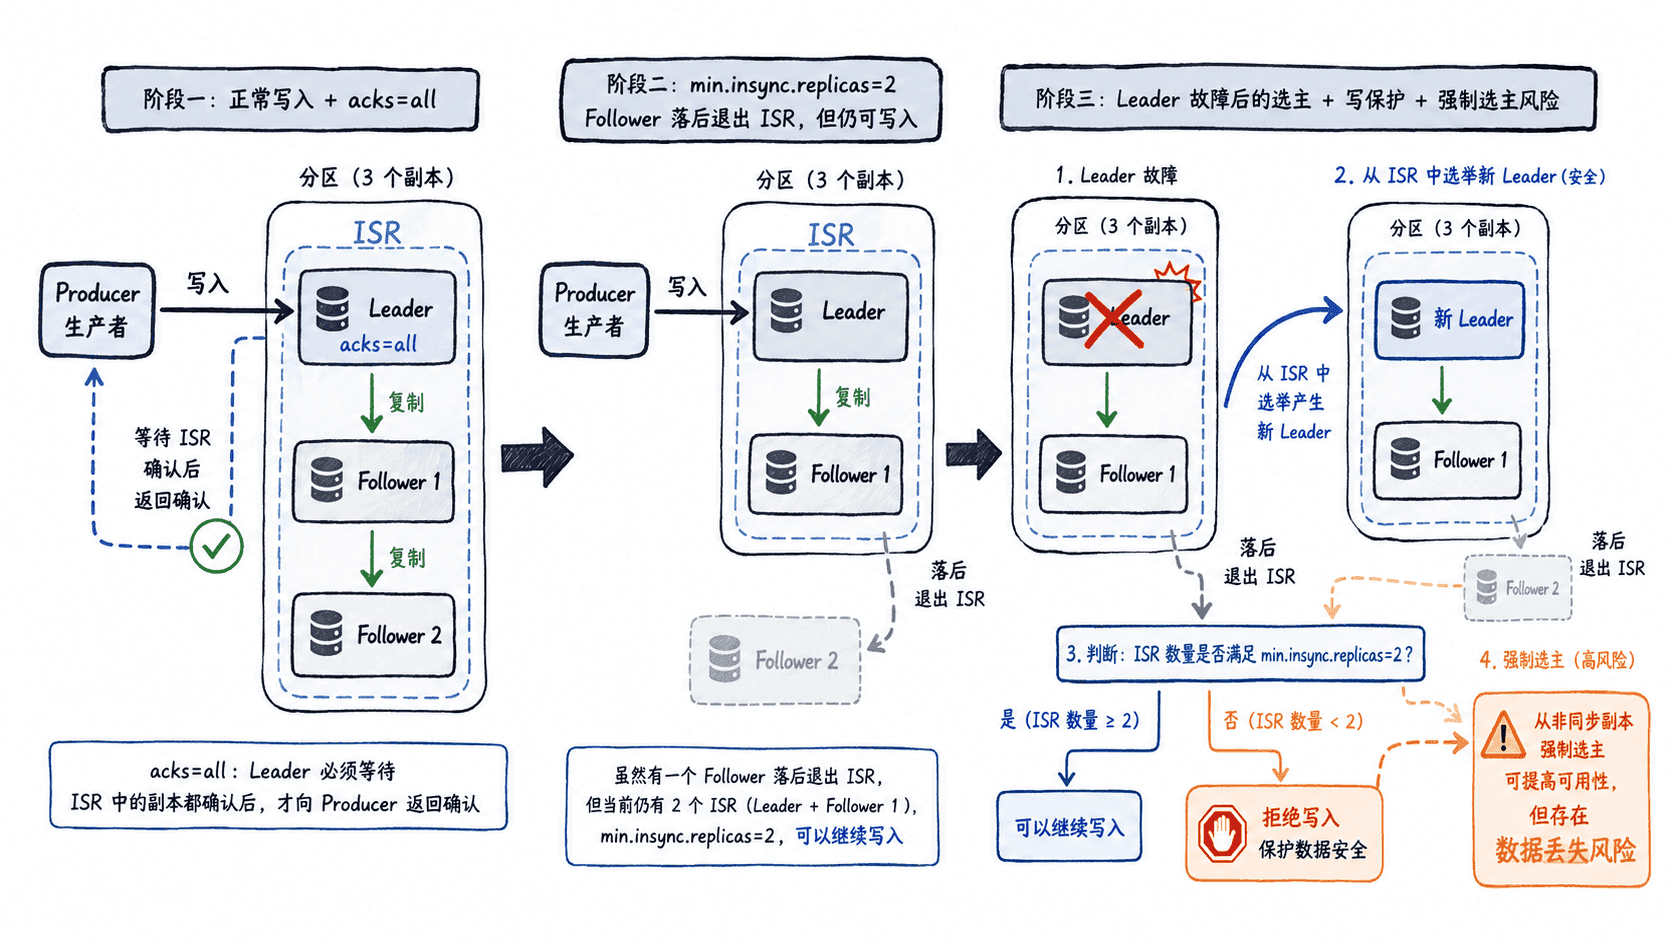
例如三副本主题设置 min.insync.replicas=2,意味着希望在可靠写入时至少维持两个同步副本。下面的命令需要在至少包含 3 个 broker 的测试集群中执行:
# 三副本主题至少保留两个同步副本,才满足可靠写入基线
kafka-topics.sh --bootstrap-server localhost:9092 --create \
  --topic reliability-demo \
  --partitions 1 \
  --replication-factor 3 \
  --config min.insync.replicas=2
预期输出:
Created topic reliability-demo.实际 broker 地址和命令路径可能不同。如果主题已经存在,创建命令会返回对应的已存在错误,而不是再次创建。
acks 决定生产者等到哪一步
| 设置 | 成功响应条件 | 主要收益 | 主要风险 |
|---|---|---|---|
acks=0 |
不等待 broker 确认 | 延迟最低、发送开销小 | 发送失败时生产者也可能不知道 |
acks=1 |
Leader 接收记录后响应 | 延迟和可靠性折中 | Leader 在副本复制前故障时可能丢失记录 |
acks=all |
当前 ISR 按要求完成确认 | 数据持久性最高 | ISR 不足时可能拒绝写入,延迟也更高 |
acks=all 不能脱离 min.insync.replicas 单独理解。假设副本因故障只剩 Leader 自己仍在 ISR,而主题要求 min.insync.replicas=2,Kafka 会拒绝这类写入,而不是为了保持服务可写而降低既定的副本保障。
生产者还可以启用幂等写入以降低重试产生重复记录的风险。可靠性要求较高时,通常会把 acks=all、合理的重试策略和幂等生产者作为一组考虑,而不是只调整其中一个参数。
故障恢复是在可用性和数据之间做选择
当 Leader 故障但 ISR 中还有可用副本时,可以通过正常 Leader 选举恢复服务,主要代价是短暂不可用。更棘手的是所有同步副本都不可用、只剩落后的非同步副本存活,此时系统面临明确取舍。
保持非同步副本不能成为 Leader,可以避免用旧日志覆盖更新的数据,但分区可能持续不可用;允许从非同步副本强制选主,则可能更快恢复服务,却可能丢失新 Leader 尚未复制到的记录。对订单、支付、库存等不能接受已确认数据回退的主题,通常应优先保护数据完整性。
一套常用的可靠性基线
对于不能轻易丢失的业务事件,可以从“三副本、acks=all、min.insync.replicas=2、幂等生产者、不从落后副本进行不安全选主”开始,再根据真实故障演练和延迟指标调整。这样一台副本故障时通常仍能继续写入,而再失去一个同步副本时会主动停止可靠写入。
如果业务更关心极低延迟,并且允许少量数据在极端故障下丢失,可以降低确认要求。关键不是寻找所谓最强配置,而是明确故障发生时究竟允许系统选择“暂时不能写”,还是选择“继续写但扩大数据风险”。