
消息队列 / 系统课时
消费端性能调优
消费端性能调优
消费端调优的目标不是单纯把 poll() 调大,而是在拉取效率、处理吞吐、下游容量和再均衡安全之间找到平衡。本课用一条可验证的调优链路,定位消费者究竟卡在 Fetch、批处理、并发度还是下游耗时,并给出参数调整顺序。
学习目标
- 区分 Fetch、Poll、业务处理和下游写入四类消费瓶颈
- 能组合调整
fetch.min.bytes、max.poll.records与并发度,而不是孤立改参数 - 能用消费组 Lag 与单批处理时间判断调优是否有效以及是否存在再均衡风险
先把瓶颈定位到正确阶段
消费者吞吐可以拆成“Broker 拉取 → 客户端缓存 → poll() 取批次 → 业务处理 → 下游写入 → 位点提交”。如果 Broker 拉取很快,但数据库写入每批都耗时数秒,继续增大 Fetch 只会扩大客户端积压;如果下游很快而每次只拿到少量记录,才应优先检查拉取与批量参数。
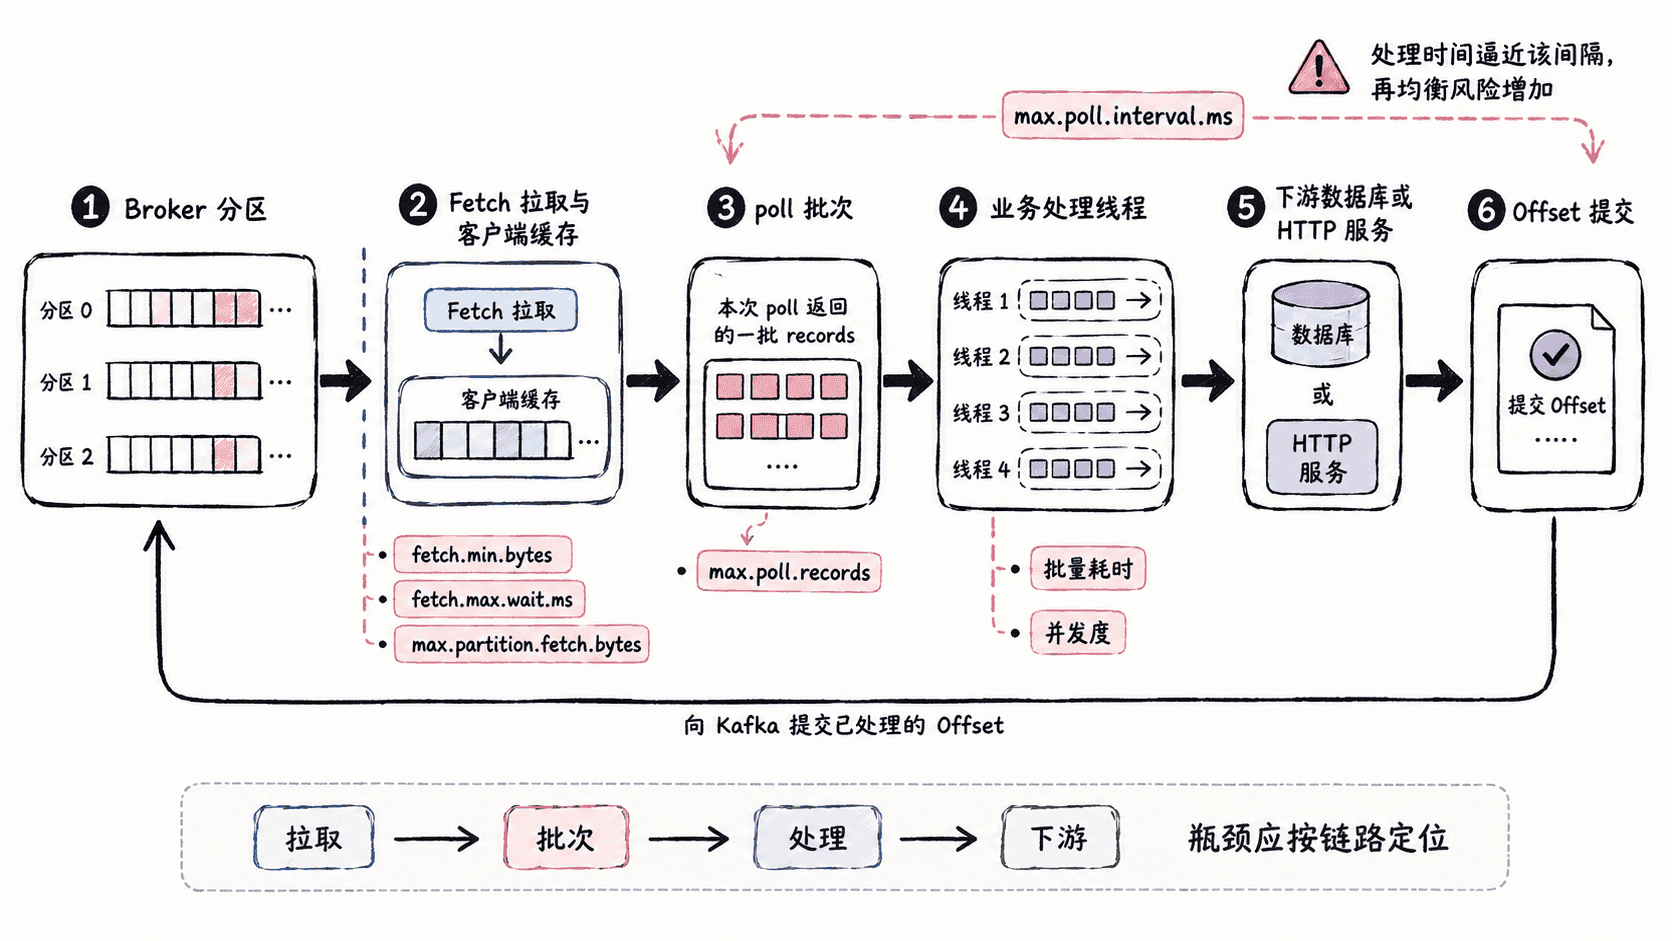
先记录三类基线:消费组 Lag 是否持续增长、应用每秒实际处理记录数、一次 poll() 后从开始处理到下一次 poll() 的耗时。只有 Lag 增长且生产速率高于消费速率时,才说明消费者确实需要扩容或优化。
调整 Fetch 与 Poll 的批量边界
fetch.min.bytes 控制 Broker 在数据不足时倾向于等待更多数据再返回,增大它通常能减少小响应数量,但会增加低流量场景的等待延迟;fetch.max.wait.ms 给这种等待设置上限。max.partition.fetch.bytes 与 fetch.max.bytes 控制单分区和一次 Fetch 的数据量边界。max.poll.records 只限制一次 poll() 交给应用的记录数,并不会直接改变底层 Fetch 缓存行为。
下面是一组用于吞吐测试的起点,不是生产环境固定答案。假设消息体较小、下游支持批量写入,可以先让每次 Fetch 更成批,再用 max.poll.records 控制应用一次处理的工作量。
bootstrap.servers=localhost:<PORT>
group.id=tuning-demo
enable.auto.commit=false
fetch.min.bytes=65536
fetch.max.wait.ms=100
max.partition.fetch.bytes=4194304
fetch.max.bytes=33554432
max.poll.records=500
max.poll.interval.ms=300000
这段配置生效后,消费者会倾向于用更大的 Fetch 响应换取更少的网络往返,同时每次 poll() 最多向业务代码交付 500 条记录。验证时不要只看平均吞吐,还要观察端到端延迟和客户端内存是否明显上升。
用并发度放大有效吞吐
同一个消费组内,一个分区在同一时刻只会分配给一个消费者,因此有效消费并发度最终受分区数限制。如果主题只有 6 个分区,启动 12 个普通消费者不会得到 12 路有效分区消费;多出的实例会处于空闲状态。
KafkaConsumer 本身不适合作为多个业务线程并发调用的共享对象。最稳妥的扩容方式通常是增加消费者实例,让每个实例独立执行 Poll 循环。若必须把处理任务交给工作线程池,应确保 Poll 线程仍能按时调用 poll(),并对分区暂停、恢复和位点提交顺序做严格控制,否则容易出现重复处理、提交越界或长时间不 Poll。
批量处理要同时压缩下游固定成本。例如数据库从“每条一次事务”改为“每批一次批量写入”,HTTP 下游从逐条请求改为支持批量接口,往往比继续增大 Kafka 参数更有效。批量越大,单批完成时间也越长,因此必须持续比较处理时间与 max.poll.interval.ms 的安全余量。
控制再均衡风险
当使用消费组管理时,如果两次 poll() 之间的间隔超过 max.poll.interval.ms,消费者会被视为无法正常推进,可能触发分区重新分配。因此不要用“把 max.poll.interval.ms 调得很大”掩盖慢处理,而应先降低 max.poll.records、优化下游批处理,或把耗时任务从 Poll 主循环中解耦。
一个实用判断是让高分位单批处理时间与 Poll 间隔保持明显余量。例如压测时发现 99 分位批处理已经接近 4 分钟,而间隔上限为 5 分钟,即使平均值只有 30 秒,也很容易在下游抖动时触发再均衡。
用 Lag 做前后对照验证
保持相同生产流量和相同下游环境,在调优前后执行消费组检查。下面命令查看 tuning-demo 的当前位点、日志末端位点与 Lag。
bin/kafka-consumer-groups.sh --bootstrap-server "localhost:<PORT>" --describe --group tuning-demo预期输出
GROUP        TOPIC       PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG   CONSUMER-ID  HOST       CLIENT-ID
tuning-demo  perf-topic  0          98500           100000          1500  <ID>         <IP>       <ID>
<PORT> 请替换为实际 Broker 监听端口,<ID> 与 <IP> 会随实例变化。真正有效的优化应表现为:在生产速率不变时,Lag 能持续下降或稳定在可接受区间,同时再均衡次数、处理错误率和端到端延迟没有恶化。若 Lag 下降但下游超时暴增,说明你只是把瓶颈从 Kafka 推到了下游,并没有获得可持续吞吐。