
消息队列 / 系统课时
分区数量规划与调整
分区数量规划与调整
分区数决定 Kafka 的并行上限,也会影响单分区吞吐、消费者扩展和按 key 路由的稳定性。本课给出一套可落地的估算方法,并演示如何安全增加分区、验证结果以及评估顺序风险。
学习目标
- 能从目标吞吐、单分区能力和消费者并行度估算初始分区数
- 能判断增加分区是否会影响按 key 的路由与局部顺序
- 能使用 Kafka 命令增加分区并完成调整后的验证
先用三个约束估算分区数
规划时不要先拍一个“看起来够大”的数字,而是分别计算写入、读取和并行消费的下限,再取最大值。设目标吞吐为 ,单分区在真实压测中的可持续写入能力为 ,可持续读取能力为 ,期望同时工作的消费者数为 ,则可用下面的基线:
这里的 和 必须来自接近生产环境的压测,因为消息大小、压缩方式、acks、磁盘与网络都会改变单分区能力。算出基线后,再按未来增长和故障余量留出适度空间,而不是直接把分区数扩大一个数量级。
例如,目标峰值为 120 MB/s,单分区写入压测约 18 MB/s、读取约 25 MB/s,同时希望最多 10 个消费者并行工作,那么三个下限分别约为 7、5、10,初始规划至少应从 10 个分区起评估。
分区不是越多越好
分区数提高后,Producer 可以把流量摊到更多日志,Consumer Group 也能获得更多并行槽位,但代价同样会增加。Broker 需要管理更多分区、副本、日志段和索引文件,控制器处理元数据与副本迁移时的工作量也会变大。
分区过多还可能把 Producer 的批次切得更碎,使单个 topic-partition 更难积累足够大的 batch。对低流量 Topic,这种拆分往往不能换来吞吐收益,反而会增加请求和管理开销。因此,应以真实瓶颈为依据扩容,而不是把“更多分区”当作默认优化手段。
增加分区会改变按 key 路由
未显式指定分区时,Kafka Producer 会根据记录内容和分区策略选择目标分区。对于带 key 的记录,常见默认行为会根据 key 的哈希结果和当前分区数确定分区,因此分区总数改变后,同一个 key 的新消息可能被映射到不同分区。
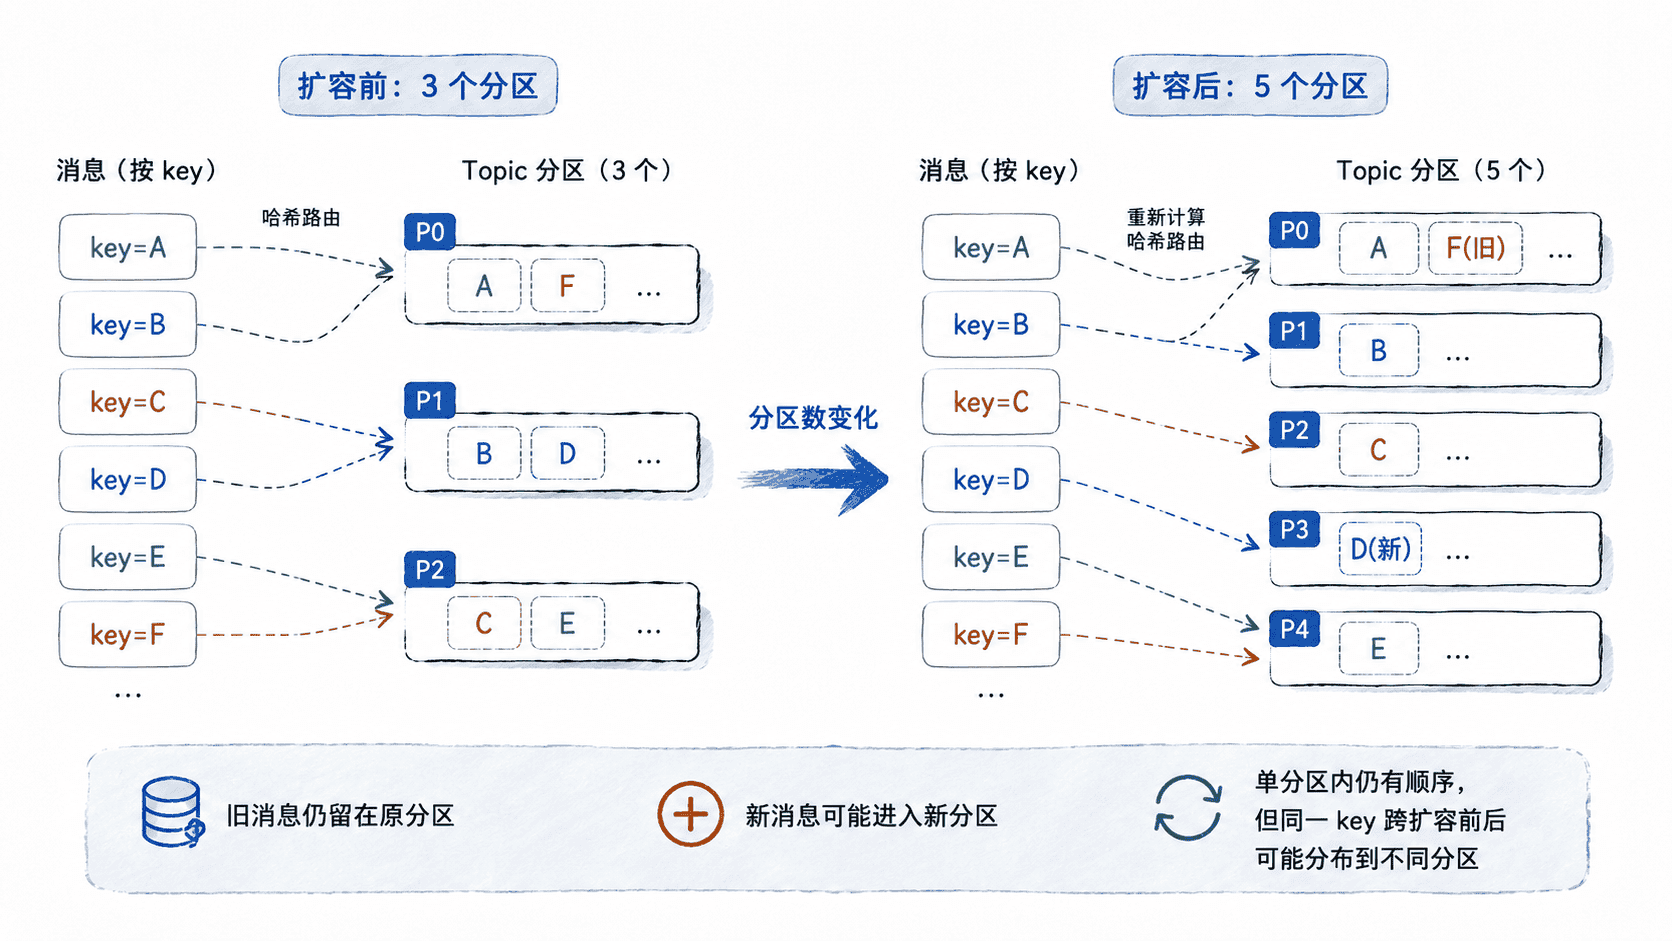
这意味着:如果业务依赖“同一个 key 永远落在同一分区”来维持跨时间的严格处理顺序,扩容前必须先评估影响。显式分区或自定义分区器也可能有自己的稳定性规则,不能只凭默认哈希逻辑判断。
实际增加分区并验证
Kafka 支持增加 Topic 的分区数,但不能用同一命令把分区数减少回去。下面把 orders 从当前分区数增加到 12,并立即查看 Topic 元数据。
bin/kafka-topics.sh --bootstrap-server localhost:9092 --alter --topic orders --partitions 12
bin/kafka-topics.sh --bootstrap-server localhost:9092 --describe --topic orders
预期输出
Topic: orders  TopicId: <ID>  PartitionCount: 12  ReplicationFactor: <VALUE>  Configs: <VALUE>
...
不同 Kafka 版本的 describe 排版可能不同,但 PartitionCount 应为 12;TopicId、副本因子和配置内容以实际集群为准。增加分区不会自动把旧消息重新均匀分布到新分区,新分区只会承接后续路由到它们的记录。
调整后看什么
扩容后至少观察一个完整业务高峰:Producer 吞吐是否改善、消费者实例是否真正获得更多分区、Consumer Lag 是否下降,以及各 Broker 的磁盘和网络负载是否更均衡。若使用消息 key,还应抽样验证同 key 的新旧消息路由是否符合业务顺序要求。
分区调整本质上是一次并行度与数据路由的结构变更。先用压测数据确定下限,再评估 key 顺序和运维成本,最后通过命令与运行指标验收,才能避免“分区加了很多,问题却换了一个地方”的扩容。