
消息队列 / 系统课时
适用场景与技术选型
适用场景与技术选型
Kafka 很强,但并不是所有异步任务都应该交给 Kafka。本课从日志采集、业务事件、实时计算和任务通知四类需求出发,建立一套选型判断方法,重点识别 Kafka 的优势边界以及应该改用其他消息或任务系统的情况。
学习目标
- 判断一个需求是否真正需要 Kafka 的事件流能力
- 区分日志、业务事件、实时计算和任务通知的不同诉求
- 识别顺序、延迟任务、请求响应等常见选型边界
Kafka 最擅长的是可持续消费的事件流
Kafka 更像一个可持久保存、可按偏移量重复读取的分布式事件日志,而不只是“把一条消息从 A 发给 B”。当系统需要高吞吐写入、多个下游独立消费、历史重放以及分区内有序处理时,Kafka 的优势最明显。
反过来,如果消息被消费一次后就没有重放价值,吞吐很小,也不需要多个消费者建立独立进度,引入 Kafka 可能只会增加 broker、分区、监控和容量治理成本。
四类典型需求如何判断
| 场景 | Kafka 适配度 | 关键原因 | 需要额外关注 |
|---|---|---|---|
| 日志与埋点采集 | 高 | 连续高吞吐写入,可由多个下游重复消费 | 分区规划、保留周期、突发流量 |
| 业务事件 | 高 | 发布者与消费者解耦,事件可审计和重放 | Schema 演进、消费者幂等、事件语义 |
| 实时计算 | 高 | 适合作为实时数据入口和事件总线 | Kafka 本身不是完整计算引擎 |
| 普通任务通知 | 视需求而定 | 可以通过消费者组分摊任务 | 延迟任务、优先级、复杂重试通常不是强项 |
日志采集是最直接的场景。应用持续产生访问日志、行为事件或指标数据,Kafka 可以吸收高吞吐流量,再让实时计算、存储、告警等消费者分别维护自己的读取进度。
业务事件也很适合,例如“订单已创建”“商品已发货”。这类事件往往不只供一个系统使用,而且出现故障后需要从历史位置重新消费。不过消费者必须自己处理重复执行和 Schema 演进,不能因为用了 Kafka 就假设业务处理天然只有一次。
实时计算场景中,Kafka 通常承担数据传输与持久化,而窗口聚合、状态计算、事件时间等逻辑一般交给 Flink、Kafka Streams 或其他流处理组件完成。
用需求特征而不是案例名称做选择
同样叫“任务通知”的系统,实际需求可能完全不同。选型时应先问事件是否需要长期保存和重放、是否会被多个独立系统消费、吞吐是否足够高,以及是否需要依赖分区扩展并行处理。
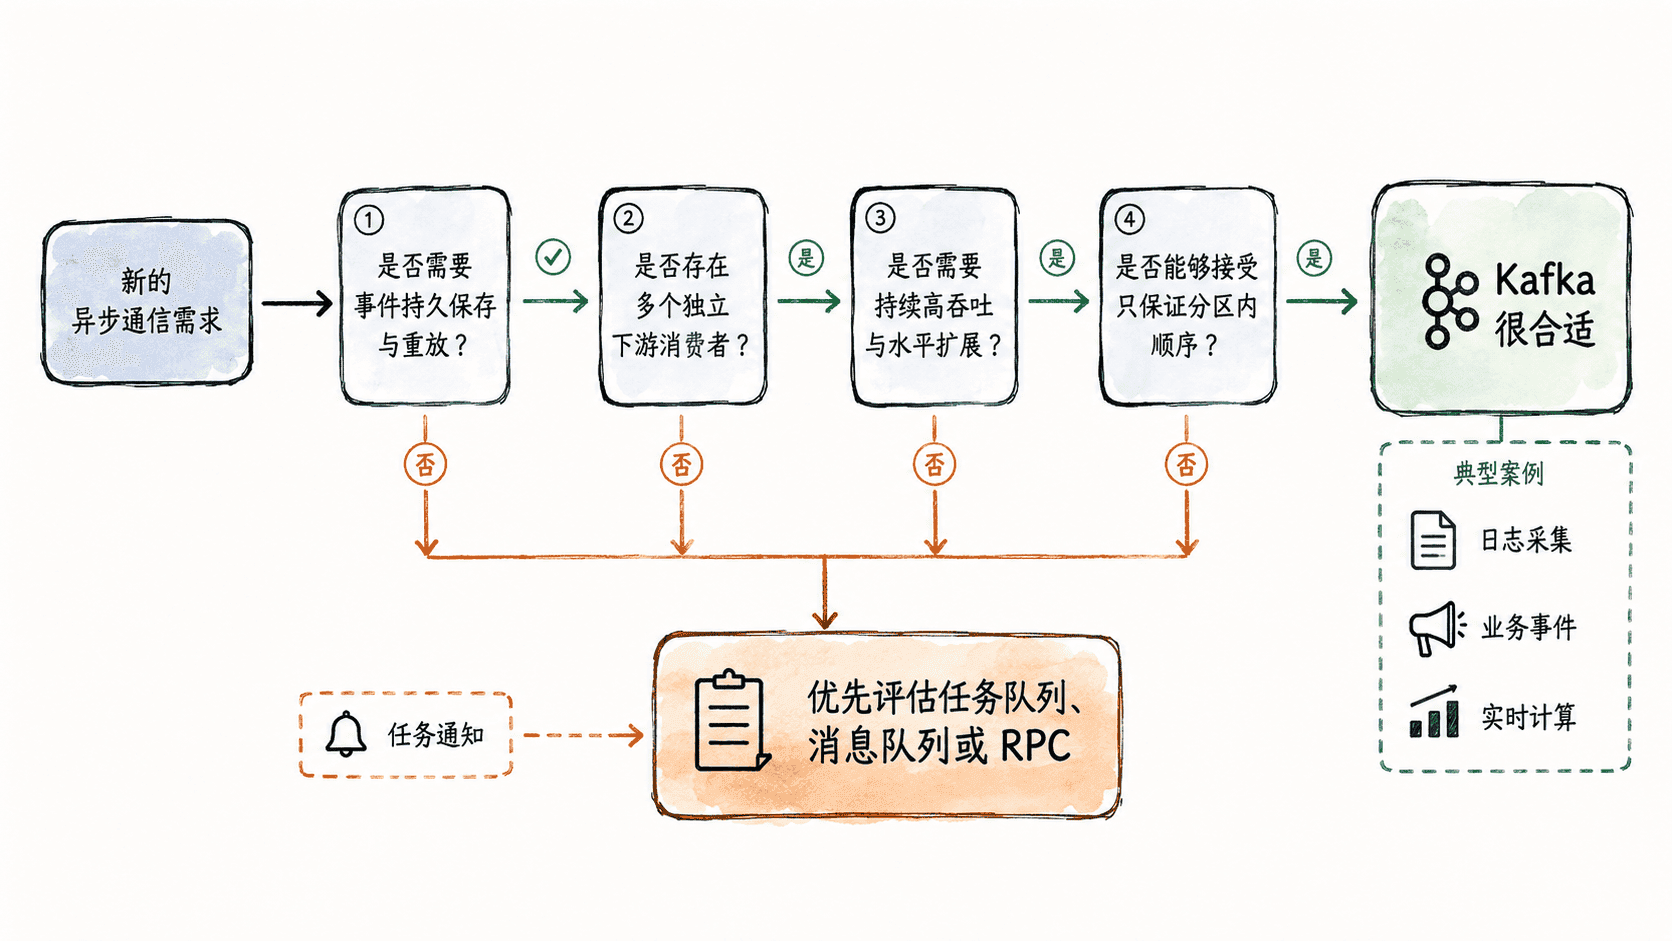
图中的条件应该组合判断,而不是只看某一个答案。例如一个系统每天只有几百条任务,但必须支持“30 分钟后执行”“高优先级插队”和每条任务独立重试,即使它也需要异步处理,专门的任务队列往往比 Kafka 更自然。
哪些需求不应优先选择 Kafka
严格的同步请求响应通常不适合通过 Kafka 替代 RPC 或 HTTP。虽然可以人为构造请求主题和响应主题,但调用链延迟、超时管理和错误传播都会变得更复杂。
Kafka 也不提供跨所有分区的天然全局顺序。需要按某个业务键保持顺序时,可以让相同键进入同一分区;如果要求所有消息严格形成单一全局顺序,则会限制并行能力,甚至抵消使用分布式消息系统的主要价值。
细粒度延迟任务、任务优先级和复杂的逐条调度同样不是 Kafka 的核心模型。Kafka 可以实现部分相关能力,但如果这些要求是系统的主要矛盾,应优先评估原生支持它们的任务队列或调度系统。
选型时至少回答这些问题
正式落地前,可以用几个问题快速检查:消息是否必须保留并可重放;同一事件是否会被多个业务独立消费;是否需要按业务键维护顺序;生产和消费速率是否可能长期不一致;消费者失败后是否需要从历史偏移量重新处理。
同时也要问反方向的问题:是否主要需要毫秒级同步响应,是否依赖严格的全局顺序,是否大量使用延迟任务和优先级,以及团队是否具备分区规划、容量监控、消费者延迟治理和故障处理能力。
选型的核心不是比较产品功能清单,而是确认消息在系统中究竟是“需要长期保存和反复消费的事件流”,还是“只需要尽快交付一次的任务”。前者通常更能发挥 Kafka 的优势,后者则应该继续比较更简单或更专用的方案。