
消息队列 / 系统课时
监控体系与关键指标
监控体系与关键指标
Kafka 监控的目标不是“把指标都采上来”,而是能从异常现象快速落到故障层级。本课建立 Broker、Controller、Topic/Partition、Producer、Consumer 与 JVM 的分层视图,并给出可直接验证采集链路的方法。
学习目标
- 能按服务端、客户端与运行时层级组织 Kafka 监控指标。
- 能从吞吐、错误、复制健康和资源饱和度组合判断异常。
- 能验证指标端点是否可采集,并避免只看单一指标下结论。
先按故障链路分层
一次消息链路会同时经过生产者、Broker、分区副本、消费者和 JVM。真正有效的监控应保留这些层级之间的关联:先判断集群是否健康,再判断某个 Topic 或 Partition 是否异常,最后再下钻到具体客户端或 JVM。
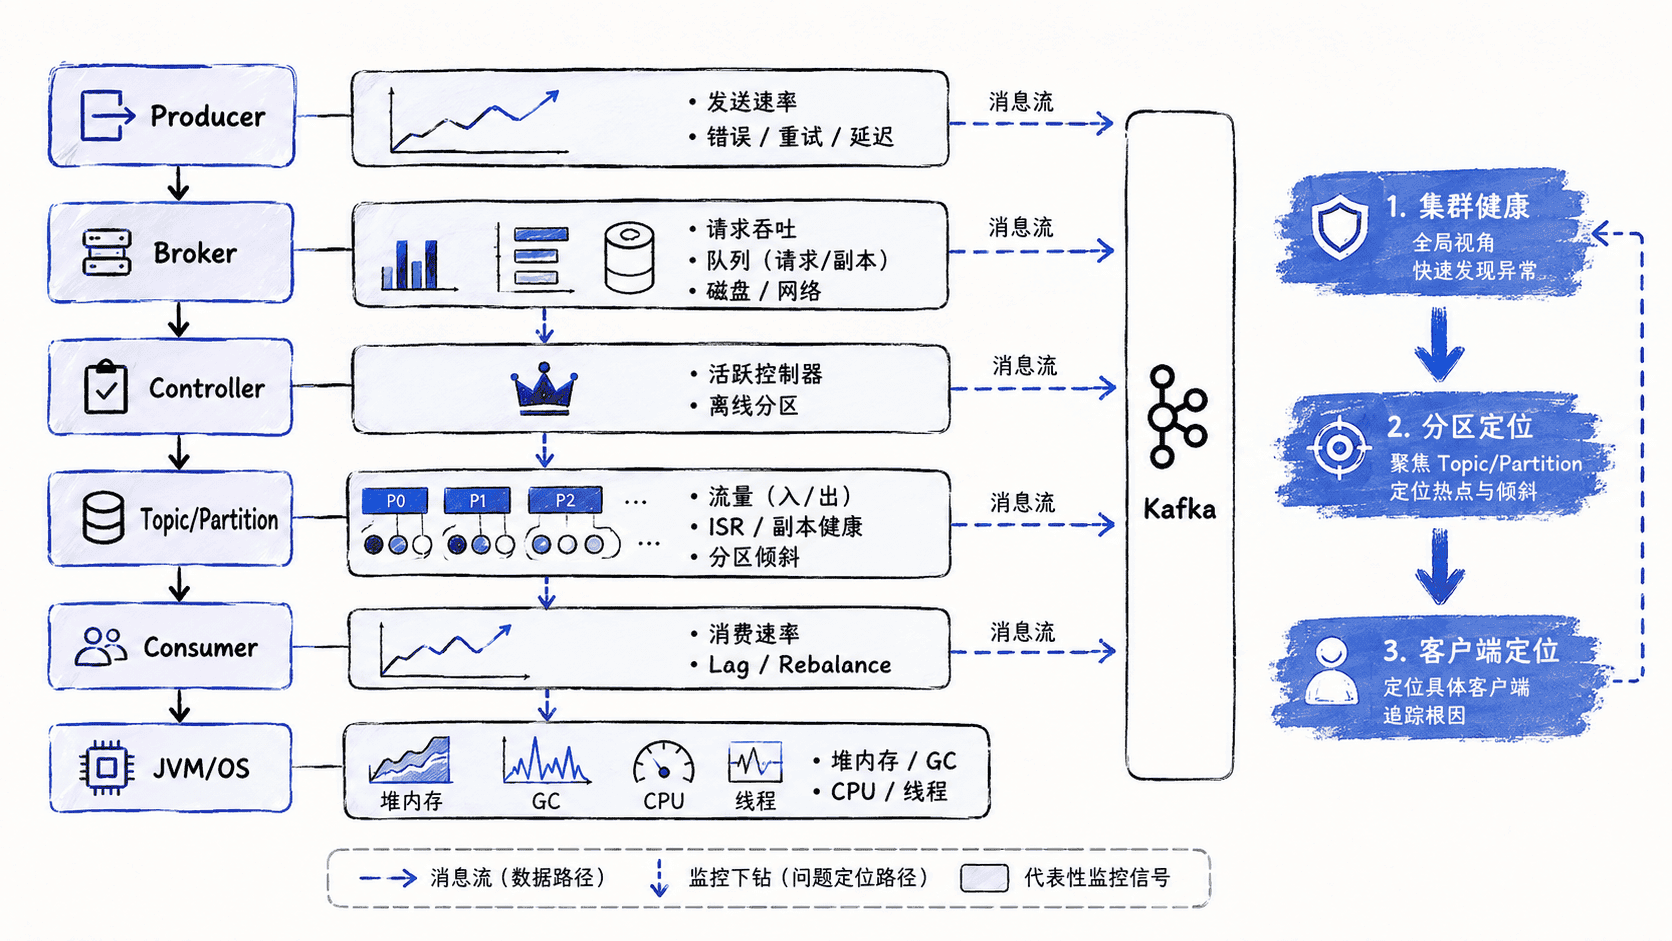
各层该看什么
| 层级 | 优先指标 | 主要回答的问题 |
|---|---|---|
| Broker | 请求速率、请求延迟、网络与磁盘吞吐、请求队列 | Broker 是否过载或 I/O 受限 |
| Controller | 活跃 Controller、离线分区、Controller 事件处理 | 元数据与领导者选举是否异常 |
| Topic/Partition | Bytes/Records、ISR、欠副本、分区大小与流量倾斜 | 故障是否集中在某个主题或分区 |
| Producer | 发送速率、错误率、重试率、请求延迟 | 生产端是否在超时、重试或限流 |
| Consumer | 消费速率、Lag、提交、Rebalance | 消费能力是否追不上写入 |
| JVM/OS | Heap、GC 暂停、CPU、线程、磁盘空间 | 进程是否被运行时或主机资源拖慢 |
对 Broker 而言,复制健康通常比单纯 CPU 更接近业务风险。出现 Offline Partition 应立即处理;Under Replicated Partition 持续升高时,需要继续检查 Broker 存活、磁盘、网络和 ISR 变化,而不是只给 CPU 扩容。
用组合信号而不是单点阈值
一个可靠告警至少同时考虑“异常程度”和“持续时间”。例如请求延迟瞬时抖高但吞吐、错误率和队列都正常,未必需要告警;如果延迟持续升高,同时请求队列增加、磁盘等待变高,就更像服务端饱和。
Controller 层应关注“是否只有一个活跃控制器”和“是否出现离线分区”;Consumer 层则要把 Lag 与消费速率一起看。Lag 很大但持续下降,说明系统正在恢复;Lag 不大却持续上升,反而更值得提前处理。
验证指标采集链路
假设 Kafka 进程已经通过 JMX Exporter 暴露 Prometheus 文本端点,先确认端点可访问且返回非空内容。下面示例使用 9404,实际端口不同时替换即可。
METRICS_URL=http://127.0.0.1:9404/metrics
curl -fsS "$METRICS_URL" -o /tmp/kafka-metrics.prom
test -s /tmp/kafka-metrics.prom
echo "metrics endpoint ok"
预期输出:
metrics endpoint ok这一步只证明“指标可以被抓取”,不证明规则完整。还要在监控平台检查最新抓取时间,并确认 Broker、Controller、Producer/Consumer 和 JVM 相关指标都存在;具体指标名称取决于 JMX Exporter 的映射规则。
把告警落到处置动作
告警名称最好直接对应下一步动作:离线分区告警指向 Broker 与副本状态检查,Lag 告警指向消费组定位,GC 暂停告警指向堆内存与对象分配检查。避免只发“Kafka 异常”这种没有定位价值的通知。
生产环境中应先建立正常时段基线,再设置持续窗口和分级阈值。最终目标不是指标越多越好,而是任何一条重要告警都能回答三个问题:哪里坏了、影响多大、下一步查什么。