
消息队列 / 系统课时
日志与链路追踪
日志与链路追踪
消息链路出错时,最耗时的往往不是修复,而是确认“同一条消息到底走到了哪里”。本课建立一套可关联的日志与追踪字段,让你能从业务事件一路定位到 Producer、Kafka 分区、Consumer 与下游服务。
学习目标
- 设计能跨服务关联的
event_id、trace_id与 Kafka 元数据字段 - 理解客户端日志、Broker 日志与分布式追踪各自能证明什么
- 按固定顺序定位发送失败、消费失败、重复处理和下游调用异常
先统一消息身份与链路身份
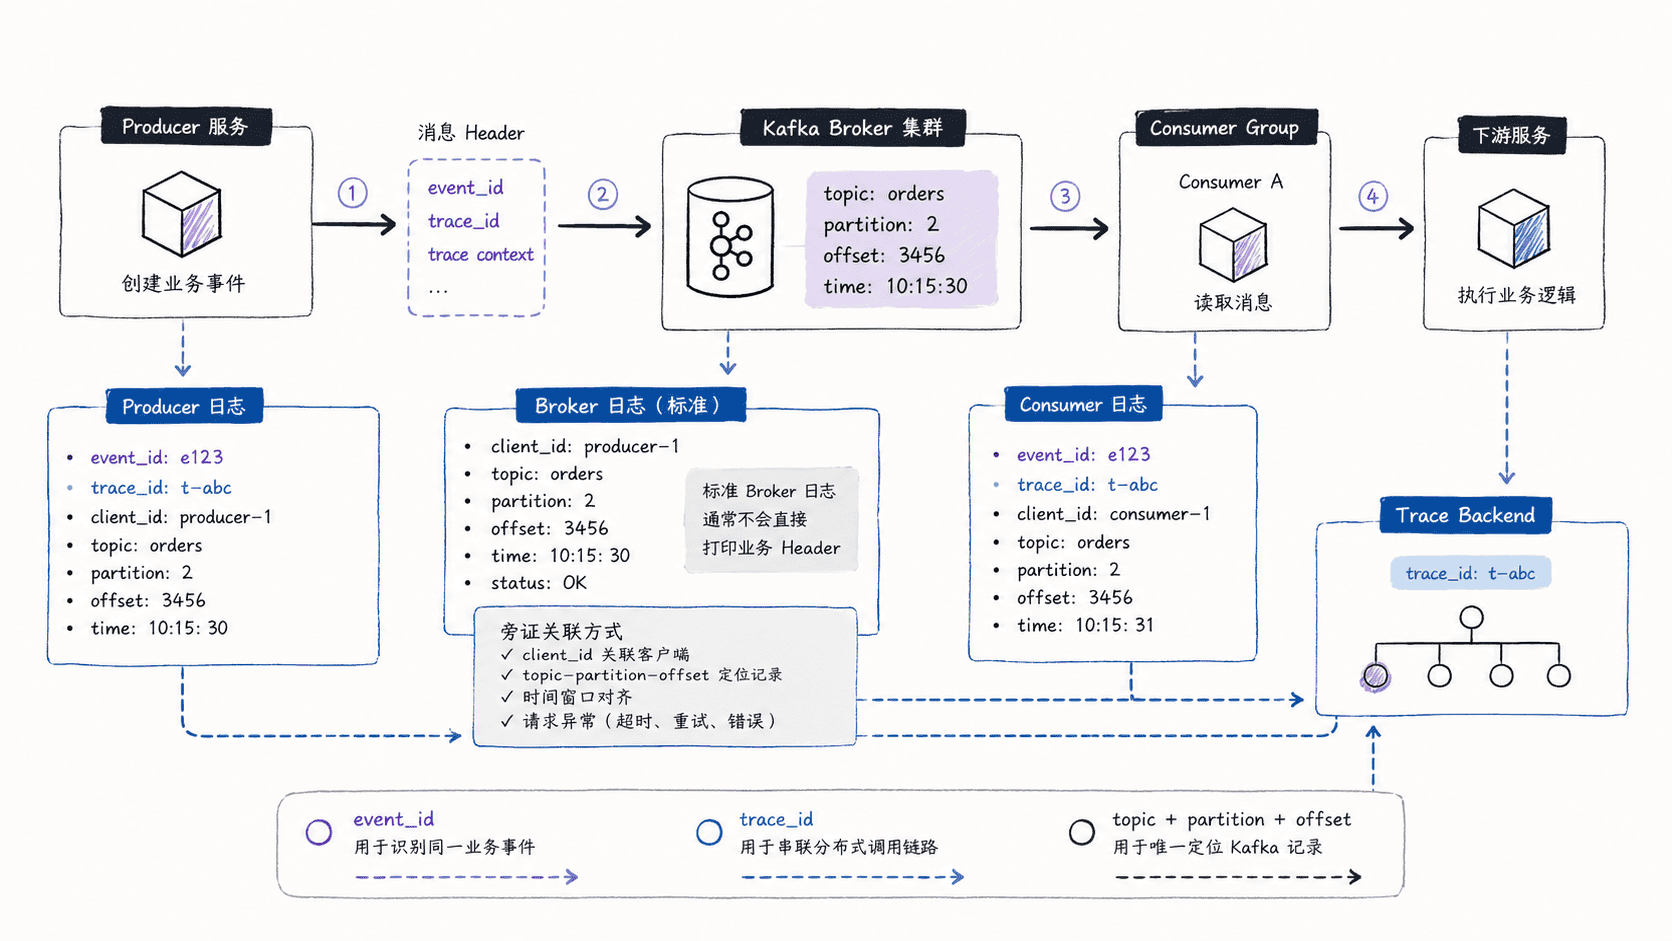
event_id 表示业务事件本身,应该在首次创建事件时生成,并在重试、重复投递或补偿过程中尽量保持不变。trace_id 表示一次分布式调用链,它适合串起 Producer、Consumer 和下游 RPC;如果消息被隔天重放,新的处理链可能产生新的 trace_id,但仍可依靠原 event_id 识别同一业务事件。
应用日志至少应保留 event_id、trace_id、service、client_id、topic、partition、offset 和消费组。Producer 在发送成功后记录返回的 topic、partition、offset;Consumer 在开始处理时记录消费位置,在成功、重试和失败时继续带上同一组关联字段。
三类日志分别回答不同问题
Producer/Consumer 日志最接近业务语义,应回答“谁发送了什么、写到哪里、谁消费了哪里、处理结果是什么”。建议所有实例使用统一的结构化字段名,并把 Kafka 客户端 client.id 配成可识别的服务与实例前缀,这样才能把应用日志与 Broker 侧请求异常对齐。
Broker 日志更适合回答集群层问题,例如请求超时、认证失败、副本异常、磁盘故障和某个 topic-partition 的复制问题。Broker 通常看不到你的业务语义,也不应依赖它记录 event_id 或 trace_id;定位时应从应用日志取得 client_id、topic、partition 和时间窗口,再去 Broker 侧交叉验证。
分布式追踪则回答“处理时间花在哪个服务、哪个调用失败”。如果使用 OpenTelemetry 等方案,应通过 Kafka Record Header 传播 trace context,并在消费端创建新的消费处理 Span,同时把 event_id、topic、partition、offset 作为可搜索属性。
用关联字段快速收敛日志
如果应用采用 JSON Lines 日志,可以先按 trace_id 或 event_id 聚合 Producer 与 Consumer 记录。将 <PATH>、<ID> 替换成现场实际值后运行:
TRACE_ID="<ID>"
EVENT_ID="<ID>"

jq -c --arg trace "$TRACE_ID" --arg event "$EVENT_ID" '
  select(.trace_id == $trace or .event_id == $event)
  | {
      time,
      service,
      event_id,
      trace_id,
      client_id,
      topic,
      partition,
      offset,
      message
    }
' <PATH>/producer.log <PATH>/consumer.log
预期输出:
{"time":"<TIME>","service":"order-producer","event_id":"<ID>","trace_id":"<ID>","client_id":"order-producer-<ID>","topic":"orders","partition":2,"offset":48120,"message":"send success"}
{"time":"<TIME>","service":"billing-consumer","event_id":"<ID>","trace_id":"<ID>","client_id":"billing-consumer-<ID>","topic":"orders","partition":2,"offset":48120,"message":"consume failed: downstream timeout"}
两行的 topic=orders、partition=2、offset=48120 对上,说明 Producer 写入的记录已经被该 Consumer 读到;问题应继续沿消费处理或下游调用排查,而不是先怀疑消息“没有进 Kafka”。实际时间、实例 ID、分区和 offset 会不同。
固定定位顺序减少无效搜索
拿到告警后,先从业务日志中的 event_id 或 trace_id 找到 Consumer 失败记录,并记录 topic、partition、offset、consumer group、client_id 和失败时间。随后回查 Producer 是否记录了同一 event_id 的发送成功元数据;如果 Producer 没有成功回执,就优先检查发送超时、认证、序列化和重试。
如果 Producer 已成功、Consumer 也读取到相同 offset,则 Kafka 传输链路基本有证据闭环,继续检查业务异常、数据库事务、下游 RPC 和重试策略。只有出现请求超时、Leader 变化、副本异常、磁盘或网络告警时,再用 client_id、topic-partition 和时间窗口查询 Broker 日志与监控。
当同一事件能同时被 event_id、trace_id 与 topic-partition-offset 三套坐标定位时,跨服务排障就不再依赖“猜时间、翻日志”,而是可以用证据逐段确认消息已经走到哪一层。