
消息队列 / 系统课时
Streams 状态与容错
Streams 状态与容错
本节解释 Kafka Streams 为什么能在实例重启、任务迁移后继续保持聚合状态,并把 Standby Replica 与 exactly_once_v2 放到同一条容错链路中。完成后,你能配置、验证并判断一次故障恢复是否符合预期。
学习目标
- 理解 Task、分区、本地状态库和 changelog 主题之间的关系。
- 配置 Standby Replica,说明它如何缩短有状态任务恢复时间。
- 启用
exactly_once_v2,明确它保证的原子性范围与边界。
状态归属于 Task
Kafka Streams 的最小并行单位是 Task。对每个 sub-topology,输入分区方式决定可并行的 Task 数量;有状态算子产生的状态也随 Task 归属,而不是“绑定某台固定机器”。因此实例扩缩容或故障触发 rebalance 后,Task 可以迁移到其他实例。
持久化状态通常保存在本地状态目录中,同时把更新写入 Kafka 的 changelog 主题。本地 RocksDB 让查询和聚合足够快,changelog 则提供可重放的持久副本。恢复时,新实例不需要从业务源主题的最开头重新计算全部历史。
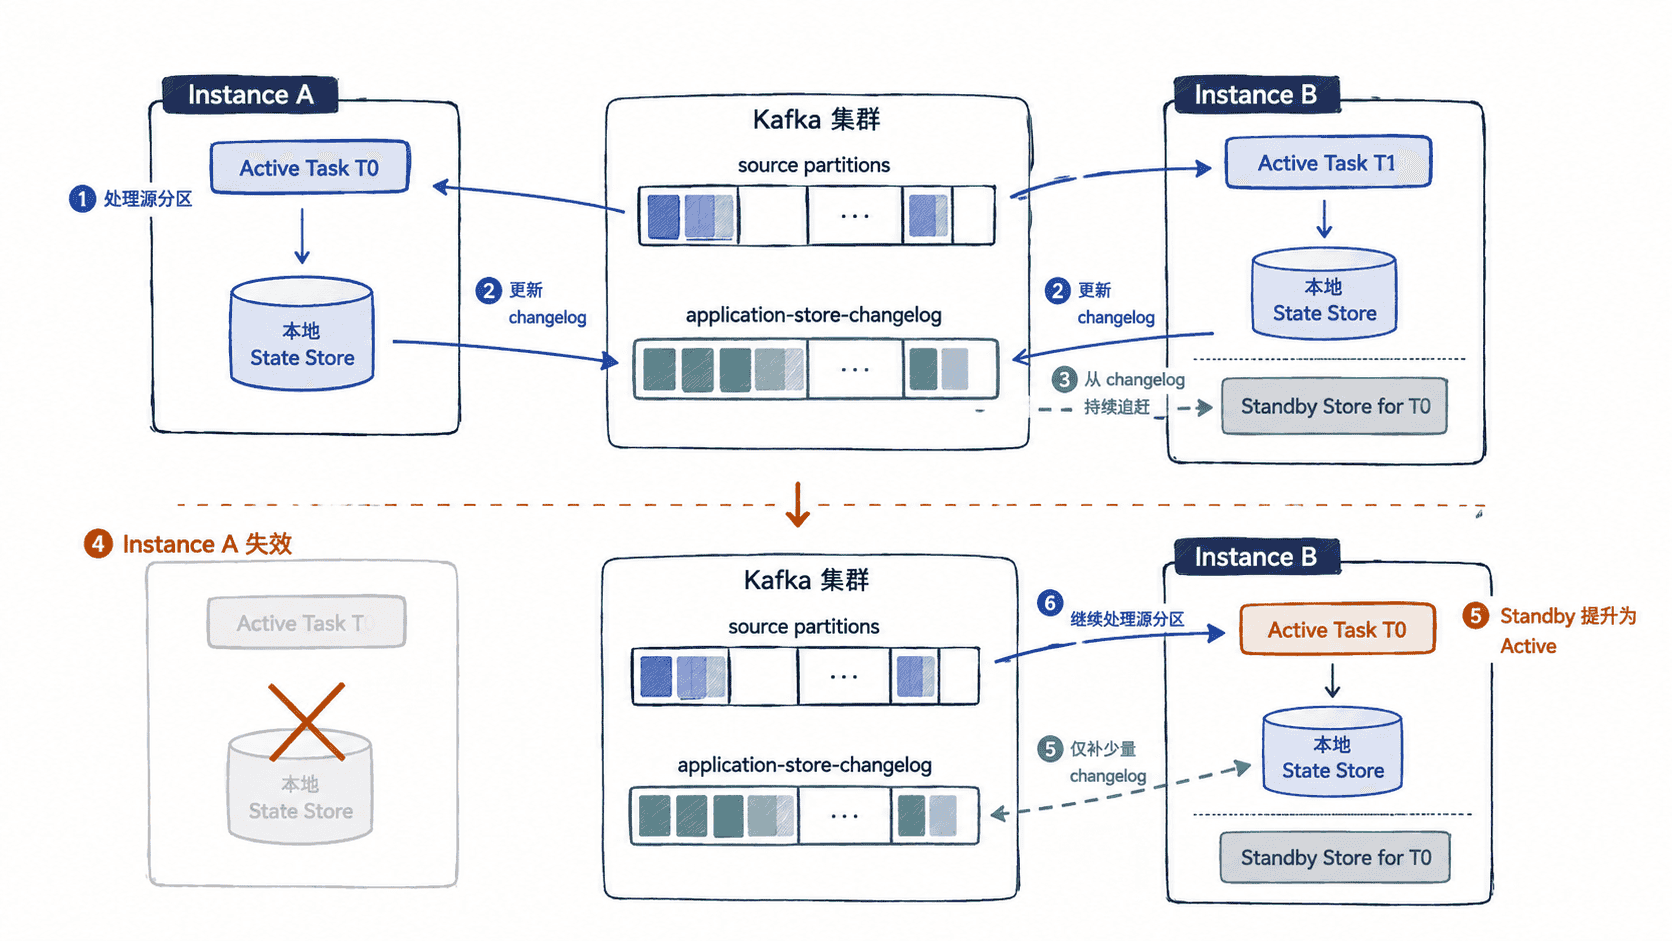
恢复路径与 Standby Replica
没有 Standby Replica 时,Task 被分配到新实例后通常要从本地检查点和 changelog 恢复状态;若没有可复用的本地副本,就需要重放更多 changelog。恢复完成前,该 Task 的处理能力会受影响。
num.standby.replicas=1 会为每个可复制的有状态 Task 维护一个热备状态副本。Standby 不主动处理该 Task 的业务输入,也不产生正常输出,而是持续消费 changelog 追赶 Active 状态。Active 实例失效时,调度器可以优先把已有 Standby 的实例提升为新的 Active,从而减少恢复量。
配置状态、Standby 与精确一次
下面的完整程序对 orders 按客户 ID 计数,并把状态存储命名为 order-counts。配置中同时启用一个 Standby Replica 和 exactly_once_v2。
import java.util.Properties;

import org.apache.kafka.common.serialization.Serdes;
import org.apache.kafka.common.utils.Bytes;
import org.apache.kafka.streams.KafkaStreams;
import org.apache.kafka.streams.StreamsBuilder;
import org.apache.kafka.streams.StreamsConfig;
import org.apache.kafka.streams.kstream.Consumed;
import org.apache.kafka.streams.kstream.Grouped;
import org.apache.kafka.streams.kstream.Materialized;
import org.apache.kafka.streams.state.KeyValueStore;

public class StatefulStreamsApp {
    public static void main(String[] args) {
        Properties props = new Properties();
        props.put(StreamsConfig.APPLICATION_ID_CONFIG, "orders-stateful");
        props.put(StreamsConfig.BOOTSTRAP_SERVERS_CONFIG, "localhost:9092");
        props.put(StreamsConfig.PROCESSING_GUARANTEE_CONFIG, StreamsConfig.EXACTLY_ONCE_V2);
        props.put(StreamsConfig.NUM_STANDBY_REPLICAS_CONFIG, 1);
        props.put(StreamsConfig.STATE_DIR_CONFIG, "/tmp/kafka-streams/orders-stateful");

        StreamsBuilder builder = new StreamsBuilder();

        // 命名状态库,便于识别对应的 changelog 主题。
        builder.stream("orders", Consumed.with(Serdes.String(), Serdes.String()))
                .groupByKey(Grouped.with(Serdes.String(), Serdes.String()))
                .count(Materialized
                        .<String, Long, KeyValueStore<Bytes, byte[]>>as("order-counts")
                        .withKeySerde(Serdes.String())
                        .withValueSerde(Serdes.Long()))
                .toStream()
                .foreach((customer, count) ->
                        System.out.printf("%s => %d%n", customer, count));

        KafkaStreams streams = new KafkaStreams(builder.build(), props);
        Runtime.getRuntime().addShutdownHook(new Thread(streams::close));
        streams.start();
    }
}
预期结果
应用启动后持续运行;状态库 order-counts 会在本地状态目录中维护,并通过内部 changelog 主题获得可恢复副本。写入两条相同客户的订单后,计数会连续增长。
printf 'customer-a:order-1\ncustomer-a:order-2\n' | kafka-console-producer.sh --bootstrap-server localhost:9092 --topic orders --property parse.key=true --property key.separator=:预期输出
customer-a => 1
customer-a => 2
再检查内部主题,可以验证命名状态库对应的 changelog 已创建。
kafka-topics.sh --bootstrap-server localhost:9092 --list | grep '^orders-stateful-'预期输出
orders-stateful-order-counts-changelog如果拓扑后来引入需要重新分区的操作,还可能出现额外的 -repartition 内部主题,因此实际列表可能比示例更多。
exact_once_v2 保证什么
exactly_once_v2 的关键不是“每条代码只执行一次”,而是 Kafka Streams 使用 Kafka 事务把一批处理结果作为一个原子单元提交。对 Kafka 到 Kafka 的拓扑,它能把输入消费位点、输出主题记录以及状态库 changelog 更新协调到同一事务边界,避免进程在提交中途崩溃后产生可见的重复提交。
发生故障时,未提交事务中的输出不会对 read_committed 消费者可见;新的 Active Task 会恢复到已提交状态并继续处理。Standby 解决的是 恢复速度,exactly_once_v2 解决的是 提交语义,两者互补但不是同一个机制。
验收容错配置时,至少启动两个同 application.id 的实例,再终止承载 Active Task 的其中一个。正确现象是 Task 重新分配后计数不会从 0 开始,已有 Standby 的任务通常只需补少量 changelog 就能恢复;最终输出和状态应从最近一次已提交事务继续推进。