
消息队列 / 系统课时
常见故障排查
常见故障排查
Kafka 故障排查的关键是先区分控制面、复制、存储、网络与消费端问题,再沿“集群状态 → Broker 资源 → 客户端与消费组”逐层缩小范围。本课用统一诊断顺序覆盖 Leader 不可用、ISR 异常、频繁再均衡、磁盘满、请求超时和消息积压。
学习目标
- 用固定顺序定位 Kafka 常见故障,避免直接重启掩盖根因
- 根据分区、副本、磁盘和消费组指标区分不同故障类型
- 在修复后用同一组指标验证故障确实消失
先收集最小诊断证据
先确认是否存在离线或未同步分区,再看磁盘,最后观察消费组。下面是一组可直接作为现场首轮检查的命令;<HOST>、<PORT> 与 <LOG_DIR> 替换为实际值。
kafka-topics.sh --bootstrap-server <HOST>:<PORT> --describe --unavailable-partitions
kafka-topics.sh --bootstrap-server <HOST>:<PORT> --describe --under-replicated-partitions

df -h <LOG_DIR>

kafka-consumer-groups.sh --bootstrap-server <HOST>:<PORT> --all-groups --describe
预期输出
# 健康集群中,前两条命令通常没有分区明细。
Filesystem      Size  Used Avail Use% Mounted on
<DEVICE>        <VALUE> <VALUE> <VALUE> <VALUE> <PATH>

GROUP           TOPIC           PARTITION  CURRENT-OFFSET  LOG-END-OFFSET  LAG
<GROUP>         <TOPIC>         <ID>       <VALUE>         <VALUE>         <VALUE>
这组证据能先回答三个问题:有没有不可用分区、复制是否落后、磁盘是否接近耗尽,以及积压是在所有消费组还是少数组出现。
用症状决定下一步
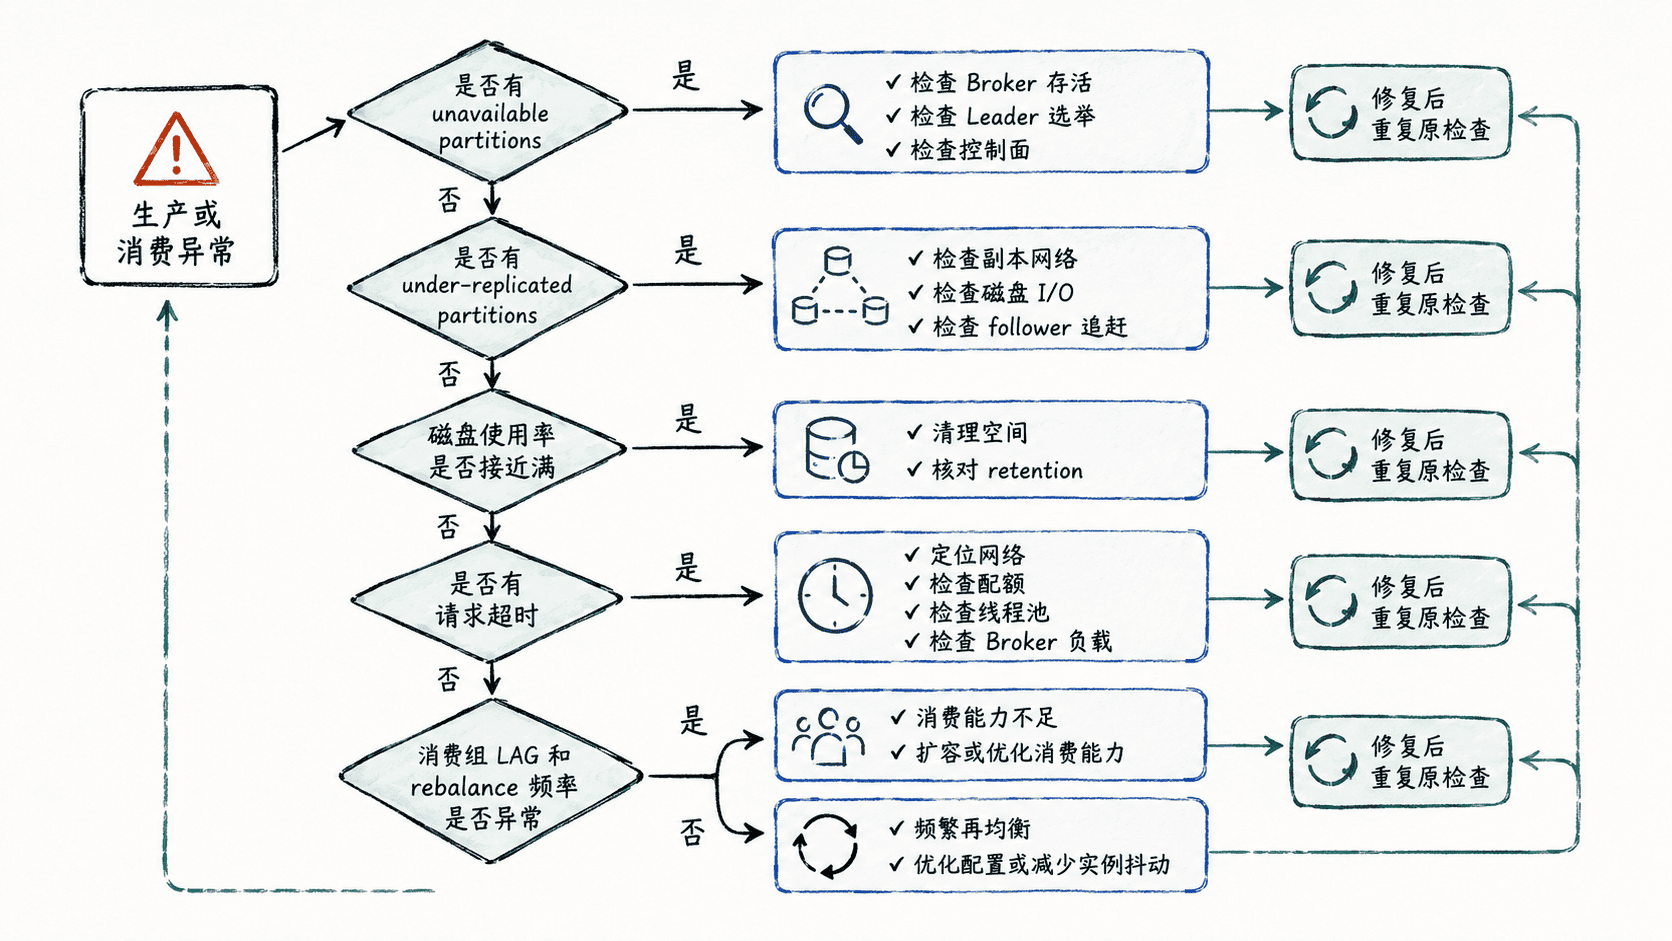
不同现象不要混为一个“Kafka 慢”。可以按下面的对应关系继续定位:
| 现象 | 优先检查 | 常见根因 |
|---|---|---|
| Leader 不可用 | Broker 存活、控制器、离线分区 | Broker 宕机、选举无法形成、元数据异常 |
| 副本不同步 | ISR、网络、磁盘 I/O | follower 追赶慢、磁盘抖动、网络拥塞 |
| 频繁再均衡 | 消费组成员日志、心跳与处理时长 | 实例抖动、处理时间过长、订阅变化 |
| 磁盘满 | 日志目录、保留策略、分区分布 | retention 过宽、扩容不及时、热点分区 |
| 请求超时 | Broker 负载、网络、客户端超时 | 排队、网络抖动、配额、GC 或磁盘延迟 |
| 消息积压 | LAG、消费速率、下游依赖 | 消费能力不足、下游变慢、频繁 rebalance |
处理 Leader 与副本异常
出现 Leader 不可用时,先确认承载该分区副本的 Broker 是否在线,再看是否还有符合条件的 ISR 成员可以当选。不要把开启不安全 Leader 选举作为常规修复手段,因为它可能用数据落后的副本恢复可用性并造成数据丢失。
副本不同步时则重点看 follower 为什么追不上 Leader。若多个分区同时在同一 Broker 上落后,优先怀疑该节点的磁盘、网络或 JVM 停顿;若只集中在少数热点分区,则检查数据倾斜与分区负载。
处理再均衡、超时与积压
频繁再均衡通常会直接放大消费延迟。先查消费者是否反复启动、心跳超时或单批处理时间过长,再检查是否因为部署、自动伸缩或订阅集合变化导致成员持续进出组。
请求超时要区分“请求根本到不了 Broker”和“Broker 收到后处理太慢”。前者重点看 DNS、网络与连接;后者重点看磁盘延迟、线程池排队、配额和整体负载。仅提高客户端 timeout 往往只会让故障暴露得更慢。
消息积压则比较生产速率与消费速率。如果 LAG 持续增长但消费组稳定,通常需要优化消费者、下游依赖或并发;如果 LAG 呈锯齿并伴随频繁 rebalance,应先解决组稳定性,而不是盲目增加实例。
磁盘满先恢复写入空间
Kafka 日志目录接近满盘时,先阻止继续恶化:确认保留策略是否生效、是否存在异常大分区,并为 Broker 恢复足够安全空间。随后再做分区迁移或扩容,不能只依赖临时删除文件。
不要直接在 Kafka 日志目录中手工删除 segment 文件。Broker 依赖日志索引、检查点和副本状态维护一致性,绕过 Kafka 的清理机制容易制造新的副本错误。
修复后用原指标复验
故障处理完成后,应重新执行最初的诊断命令,确认 unavailable partitions 消失、ISR 恢复、磁盘水位下降且消费 LAG 回到可接受趋势。还要观察一段完整业务周期,避免把短暂恢复误判为根因已经消失。
同一套“先取证、再定位、后修复、再复验”的顺序适用于大多数 Kafka 现场问题。它的价值在于保留因果链:每一步都有可观察证据,失败时也知道应该回到哪一层继续排查。