
消息队列 / 系统课时
多线程消费模型
多线程消费模型
Kafka 的并发消费不是把同一个 KafkaConsumer 交给多个线程,而是围绕“谁负责拉取、谁负责处理、谁能推进位移”来设计。本文比较三种常见模型,并给出线程安全、背压和手动提交的落地规则。
学习目标
- 区分单消费者单线程、消费者池和拉取处理解耦三种模型
- 避免跨线程共享
KafkaConsumer,理解分区数对并行度的上限 - 正确处理背压与位移提交,避免消息丢失或错误跳过
先根据负载选择模型
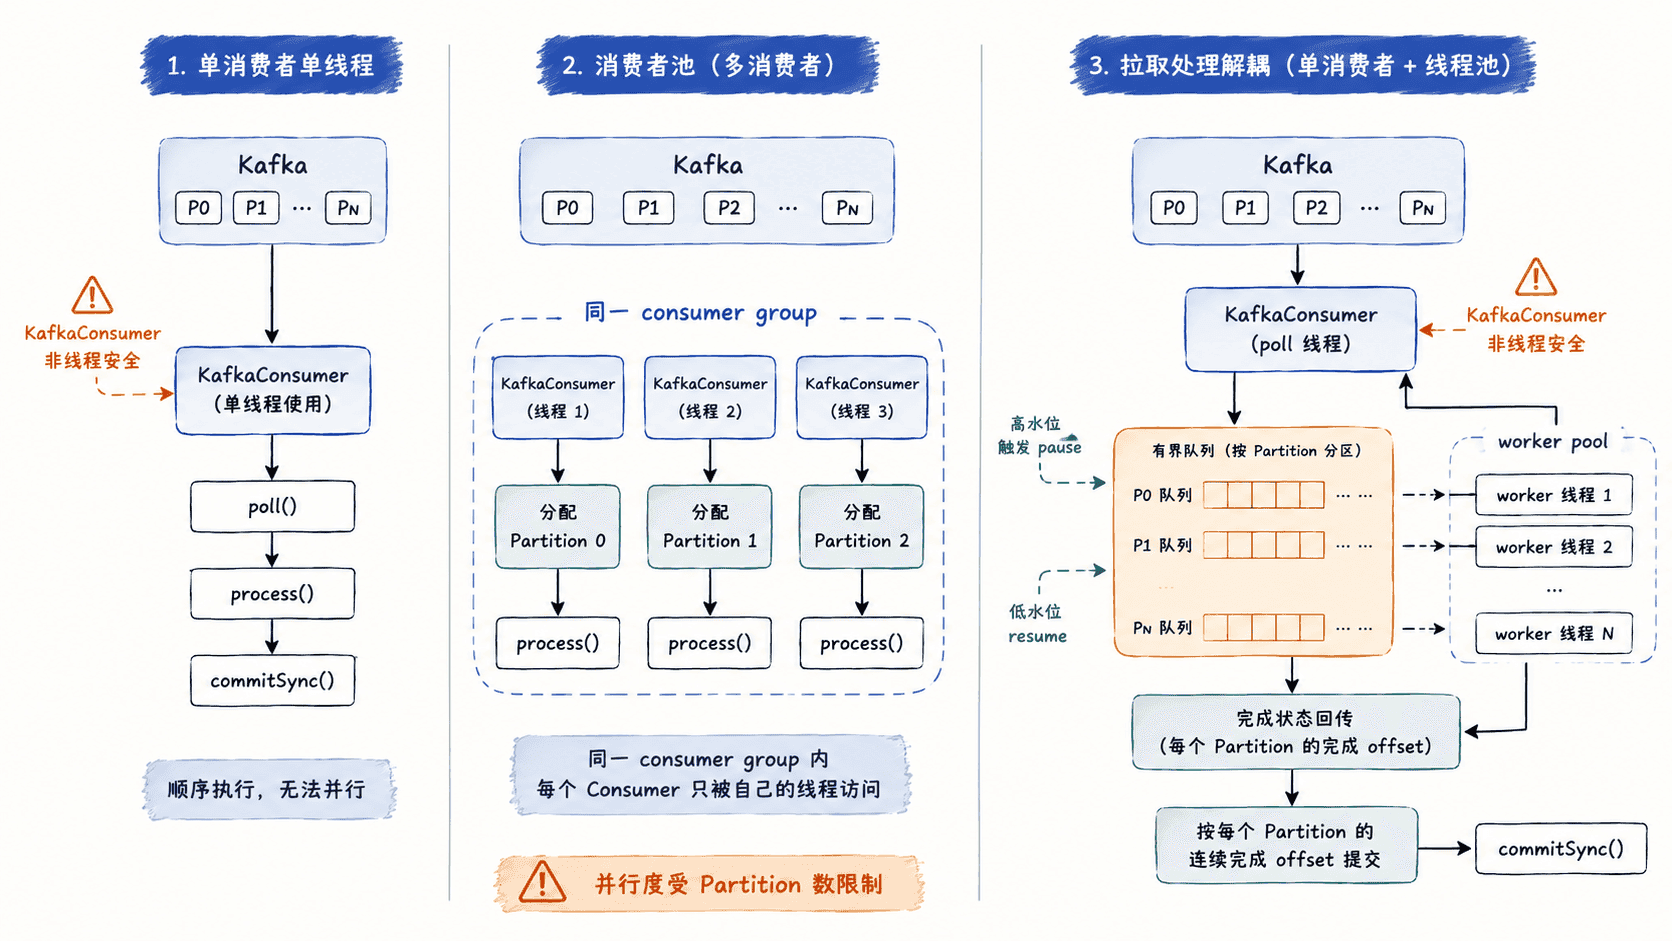
单消费者单线程最简单:一个线程执行 poll → 处理 → 提交。它天然保持分区内顺序,失败恢复也容易推理,但处理耗时会直接拖慢下一次 poll。
消费者池是最常用的扩展方式:启动多个线程,每个线程各自创建一个 KafkaConsumer,并使用相同的 group.id。Kafka 会把分区分配给这些消费者,因此有效并行度不会超过分区数。
拉取处理解耦则让一个消费线程持续 poll,把消息交给工作线程池处理。它适合单条处理较慢、又必须及时维持心跳的场景,但需要额外解决队列容量、分区顺序和“哪些 offset 已连续完成”的提交问题。
线程安全边界
KafkaConsumer 不是线程安全对象。不要让一个线程 poll,另一个线程同时调用 commitSync、pause 或 seek。消费者对象的拉取、分区控制和位移提交应由它所属的单一线程完成。
消费者池之所以安全,是因为每个工作线程拥有自己的消费者实例。相同 group.id 只表示它们属于同一个消费组,并不意味着共享同一个客户端对象。
用消费者池获得安全并发
下面的 Java 示例为 3 个工作线程各创建一个独立消费者。处理成功后再同步提交本批位移,因此语义是典型的至少一次:如果处理完成后、提交前进程崩溃,这批消息可能被再次消费,但不会因为提前提交而被直接跳过。
import java.time.Duration;
import java.util.List;
import java.util.Properties;
import java.util.concurrent.ExecutorService;
import java.util.concurrent.Executors;
import java.util.concurrent.TimeUnit;

import org.apache.kafka.clients.consumer.ConsumerConfig;
import org.apache.kafka.clients.consumer.ConsumerRecord;
import org.apache.kafka.clients.consumer.ConsumerRecords;
import org.apache.kafka.clients.consumer.KafkaConsumer;
import org.apache.kafka.common.serialization.StringDeserializer;

public class ConsumerPoolDemo {
    private static final String TOPIC = "orders";
    private static final String BOOTSTRAP_SERVERS = "localhost:9092";

    public static void main(String[] args) throws InterruptedException {
        int workerCount = 3;
        ExecutorService pool = Executors.newFixedThreadPool(workerCount);

        for (int i = 0; i < workerCount; i++) {
            int workerId = i;
            pool.submit(() -> runWorker(workerId));
        }

        Runtime.getRuntime().addShutdownHook(new Thread(() -> pool.shutdownNow()));
        pool.awaitTermination(1, TimeUnit.HOURS);
    }

    private static void runWorker(int workerId) {
        Properties props = new Properties();
        props.put(ConsumerConfig.BOOTSTRAP_SERVERS_CONFIG, BOOTSTRAP_SERVERS);
        props.put(ConsumerConfig.GROUP_ID_CONFIG, "order-workers");
        props.put(ConsumerConfig.CLIENT_ID_CONFIG, "order-worker-" + workerId);
        props.put(ConsumerConfig.ENABLE_AUTO_COMMIT_CONFIG, "false");
        props.put(ConsumerConfig.KEY_DESERIALIZER_CLASS_CONFIG,
                StringDeserializer.class.getName());
        props.put(ConsumerConfig.VALUE_DESERIALIZER_CLASS_CONFIG,
                StringDeserializer.class.getName());

        // 每个线程独占自己的 KafkaConsumer,避免跨线程调用客户端。
        try (KafkaConsumer<String, String> consumer = new KafkaConsumer<>(props)) {
            consumer.subscribe(List.of(TOPIC));

            while (!Thread.currentThread().isInterrupted()) {
                ConsumerRecords<String, String> records =
                        consumer.poll(Duration.ofMillis(500));

                for (ConsumerRecord<String, String> record : records) {
                    handle(record);
                }

                // 只有本批全部处理成功,才推进已提交位移。
                if (!records.isEmpty()) {
                    consumer.commitSync();
                }
            }
        }
    }

    private static void handle(ConsumerRecord<String, String> record) {
        System.out.printf(
                "partition=%d offset=%d value=%s%n",
                record.partition(), record.offset(), record.value());
    }
}
预期输出
partition=<ID> offset=<ID> value=<VALUE>
partition=<ID> offset=<ID> value=<VALUE>
<ID> 和 <VALUE> 取决于实际分区、消息位移和消息内容。没有待消费消息时,程序会继续轮询而不打印业务记录。
解耦模型要同时解决背压和提交
拉取线程与处理线程分离后,不能只加一个无限队列。若生产速度持续高于处理速度,内存会不断增长。更稳妥的做法是使用有界队列:达到高水位时由消费线程对相关分区执行 pause,继续定期 poll 维持组成员状态;降到低水位后再 resume。
位移也不能按“最大已完成 offset”直接提交。假设同一分区的 offset 10、11、12 并行处理,12 先完成而 11 仍在执行,此时提交到 13 会让故障恢复时跳过 11。正确做法是按分区记录完成状态,只推进到“从上次已提交位置开始连续完成”的下一个 offset。
如果业务要求分区内严格顺序,最简单的办法仍是让同一分区的消息进入同一串行处理通道;若允许乱序处理,则必须明确业务是否能接受结果重排。
什么时候用哪一种
处理逻辑很轻、吞吐要求不高时,优先单线程模型;它最容易保证顺序与提交正确性。需要横向扩展时,先增加分区并采用消费者池,这通常比共享一个消费者再加线程更稳妥。
只有在单条处理明显较慢、poll 周期容易被业务逻辑拖长时,再考虑拉取处理解耦。此时设计重点已经不只是“多线程”,而是有界缓冲、分区级顺序、连续完成位移和再均衡期间的安全收敛。