
消息队列 / 系统课时
消息键与自定义分区器
消息键与自定义分区器
本课解决两个常见 Producer 路由问题:需要同一业务实体严格按顺序进入同一分区,同时又不能让少数热点键拖垮单个分区。你会先设计稳定消息键,再在确有隔离需求时实现自定义 Partitioner,并知道扩容分区会怎样影响路由。
学习目标
- 根据业务有序范围选择稳定、可序列化的消息键
- 理解默认键分区与自定义
partitioner.class的边界 - 实现“固定路由集合内再哈希”的分区策略,兼顾隔离与热点分散
先把业务顺序变成分区边界
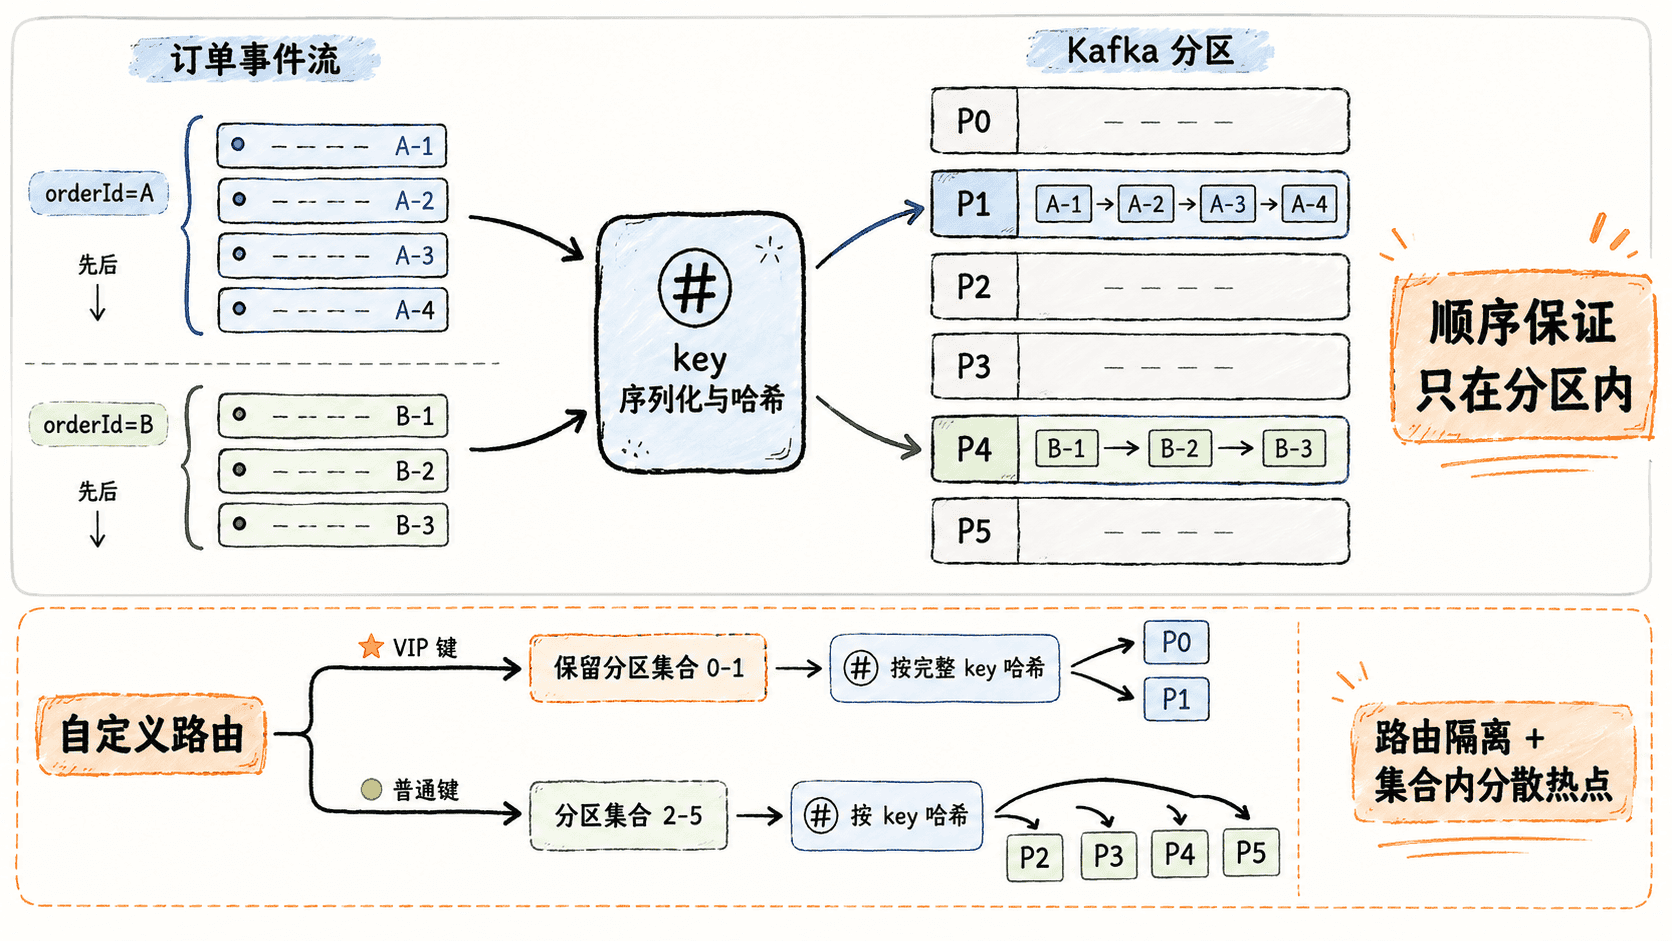
Kafka 只保证单个分区内的记录顺序,因此消息键本质上是在声明“哪些事件必须共享同一个有序通道”。订单状态流转通常用 orderId;若要求同一客户的所有事件严格有序,则可以用 customerId。键应来自稳定业务标识,不要使用当前时间、随机数、可变状态或展示名称。
默认情况下,未显式指定 partition 且 key 非空时,Producer 会根据序列化后的 key 选择分区;因此同一序列化 key 在分区数量不变时会稳定落到同一分区。没有 key 时,默认逻辑更偏向批次友好的粘性分区,而不是为业务建立顺序边界。
默认分区够用时不要自定义
如果需求只是“同键有序”,优先保留默认分区逻辑并把业务键设计好。自定义分区器会接管路由决策,Producer 的部分内置自适应分区行为也不再起作用;同时你还要自己处理空 key、分区数量变化和热点迁移等问题。
常见键设计可以直接按有序范围判断:订单生命周期用订单 ID,设备遥测需要单设备有序时用设备 ID,多租户任务只要求租户内有序时可用租户 ID。键粒度越粗,单键流量越集中;键粒度越细,并行度越高,但能保证的顺序范围也越小。
实现隔离并在集合内分散
下面是一个片段示例,依赖 kafka-clients 并由 KafkaProducer 通过 partitioner.class 加载。规则是:以 vip: 开头的键进入前约三分之一分区,普通键进入其余分区;每个集合内部再按完整序列化 key 哈希,因此相同 key 仍保持稳定路由。
package com.example.kafka;
import java.util.Arrays;
import java.util.List;
import java.util.Map;
import org.apache.kafka.clients.producer.Partitioner;
import org.apache.kafka.common.Cluster;
import org.apache.kafka.common.PartitionInfo;
public final class TenantIsolationPartitioner implements Partitioner {
    @Override
    public int partition(String topic, Object key, byte[] keyBytes,
                         Object value, byte[] valueBytes, Cluster cluster) {
        List<PartitionInfo> partitions = cluster.partitionsForTopic(topic);
        if (partitions == null || partitions.isEmpty()) {
            throw new IllegalStateException("No partition metadata for " + topic);
        }
        if (!(key instanceof String) || keyBytes == null) {
            throw new IllegalArgumentException("A non-null String key is required");
        }
        int count = partitions.size();
        if (count == 1) {
            return 0;
        }
        int reserved = Math.max(1, count / 3);
        int hash = Arrays.hashCode(keyBytes); // 同一序列化 key 得到稳定哈希
        boolean vip = ((String) key).startsWith("vip:");
        if (vip) {
            return Math.floorMod(hash, reserved); // VIP 只进入保留集合
        }
        int normalCount = count - reserved;
        return reserved + Math.floorMod(hash, normalCount);
    }
    @Override
    public void configure(Map<String, ?> configs) {
    }
    @Override
    public void close() {
    }
}
再把类名交给 Producer,并保证该类位于应用运行时 classpath:
key.serializer=org.apache.kafka.common.serialization.StringSerializer
value.serializer=org.apache.kafka.common.serialization.StringSerializer
partitioner.class=com.example.kafka.TenantIsolationPartitioner
预期结果:若主题有 6 个分区,前 2 个分区只接收 vip: 键,普通键只进入 2~5 号分区;同一序列化 key 在分区数量不变时始终映射到同一目标分区。通过发送多组固定 key 并记录回调中的 RecordMetadata.partition(),即可验证路由是否符合设计。
热点不能靠随机分区解决
热点来自“某个必须保序的 key 流量过大”时,随机打散会直接破坏这个 key 的分区内顺序。更常见的解决方式是重新审视有序边界,例如把 tenantId 改为 tenantId + entityId,让真正需要互相排序的事件共享 key,而不是让整个租户的全部事件挤在一个分区。
如果一个超大业务实体本身就要求严格全序,那么它天然只能由一个分区串行承载。此时应评估单分区吞吐上限、拆分业务状态机或接受顺序范围变小,而不是用分区器伪造并行能力。
分区扩容会改变映射
基于“哈希后对分区数取模”的策略有一个重要边界:主题增加分区后,同一个 key 可能映射到新的分区。上面的自定义分区器还会因为保留分区集合大小变化而产生额外迁移,因此扩容不能只看容量,还要把顺序连续性纳入发布计划。
需要长期稳定路由时,可以固定分区数量、使用版本化主题做迁移,或在业务键中引入显式路由版本。自定义分区器最适合解决清晰、长期存在的隔离规则;如果只是同键有序,稳定业务键加默认分区逻辑通常更简单、更安全。