
容器与云原生 / 系统课时
健康检查失败会自动重启吗
健康检查失败会自动重启吗
不会。Docker Engine 的健康检查和重启策略是两套独立机制:前者给运行中的容器标记 healthy 或 unhealthy,后者主要在容器主进程退出时决定是否再次启动。把两者混为一谈,会导致故障恢复预期与实际行为不一致。
学习目标
- 区分健康状态与容器运行状态的触发条件
- 复现
unhealthy但重启次数仍为 0 的场景 - 根据业务需求选择正确的自动恢复方式
两套机制观察的是不同信号
容器的主进程仍在运行时,docker ps 可以显示容器为 Up,同时健康状态却是 unhealthy。这是合法状态:健康检查命令连续失败只会更新健康结果,并不会让 Docker Engine 自动终止主进程。
重启策略则关注主进程退出。只有容器实际停止,并且退出方式符合 always、unless-stopped 或 on-failure 等策略条件时,Docker 才会执行重启动作。
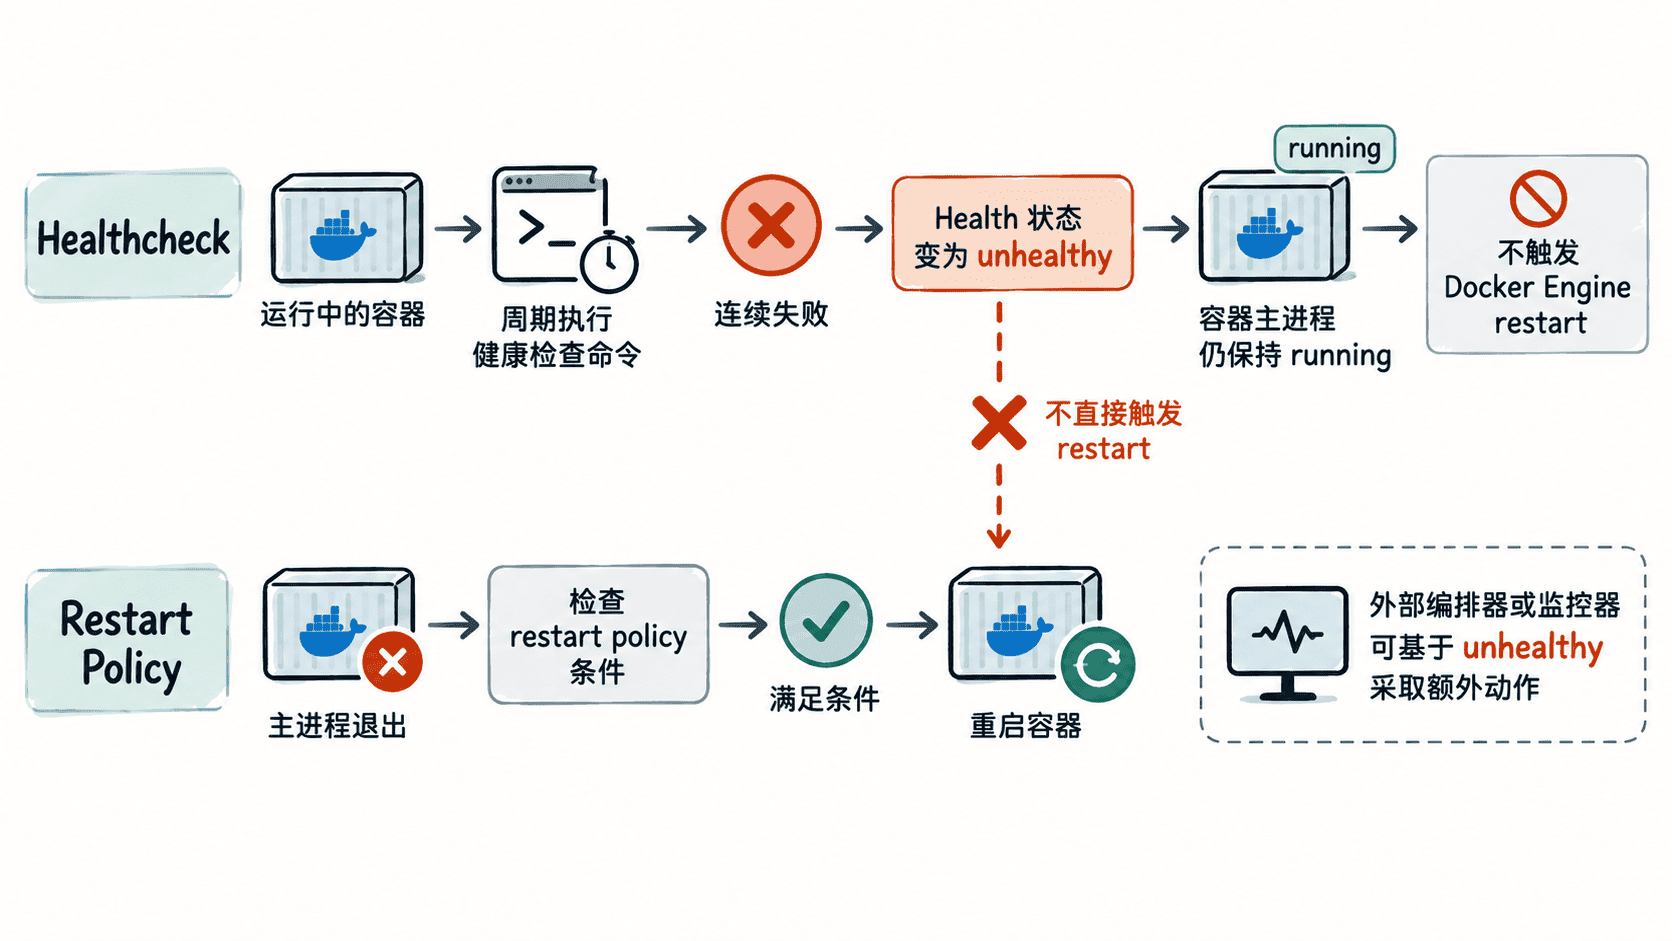
复现 unhealthy 但不重启
下面启动一个主进程长期存活的容器,同时把健康检查故意写成恒定失败。--restart=always 已启用,但因为主进程没有退出,重启策略不会被触发。
docker run -d --name health-demo --restart=always --health-cmd='exit 1' --health-interval=2s --health-retries=2 alpine sh -c 'while true; do sleep 3600; done'
sleep 6
docker inspect -f 'runtime={{.State.Status}} health={{.State.Health.Status}} restarts={{.RestartCount}}' health-demo
预期输出
<ID>
runtime=running health=unhealthy restarts=0
<ID> 是容器 ID,实际值每次不同。若本机没有 alpine 镜像,首次运行可能先出现拉取日志。关键结果是 runtime=running、health=unhealthy 与 restarts=0 可以同时出现,这正说明健康失败本身没有触发重启。
unhealthy 之后 Docker 会做什么
Docker 会继续保存健康检查的最近结果,并在容器状态中暴露 healthy、unhealthy 等信息,供运维工具或编排系统读取。它不会因为 unhealthy 自动执行 docker restart,也不会自动杀死 PID 1。
同样,Compose 中使用 depends_on 配合 condition: service_healthy,可以让依赖方在启动阶段等待目标服务变为健康,但这不代表 Docker Engine 会在目标服务日后变成 unhealthy 时自动重启它。
需要自动恢复时怎么设计
先判断“健康失败”是否真的应该通过重启解决。数据库暂时不可达、下游接口超时等外部故障,重启当前容器往往没有意义;配置损坏或内部死锁等故障,才可能需要替换或重启实例。
如果业务明确要求健康失败后自动恢复,应使用能够消费健康状态并执行恢复动作的编排器或外部监控机制,或者让应用在确认自身不可恢复时主动退出,使 Docker 的重启策略接管。无论采用哪种方案,都应保留日志和健康检查输出,否则只会把“unhealthy 不重启”变成“反复重启但看不到根因”。