
容器与云原生 / 系统课时
容器为什么会出现 OOMKilled
容器为什么会出现 OOMKilled
容器突然退出且状态显示 OOMKilled,通常意味着内核因为内存压力强制终止了进程。本节用 Docker 状态、内存限制和宿主机内核日志交叉确认原因,避免只看到退出码 137 就误判,并给出修复后的验证方法。
学习目标
- 能区分 OOMKilled、应用自身内存错误和普通
SIGKILL - 能用
docker inspect核对容器退出状态与内存限制 - 能结合宿主机内核日志确认并修复内存超限问题
OOMKilled 到底表示什么
Docker 容器中的进程仍受 Linux 内核和 cgroup 资源控制。为容器设置内存上限后,如果进程持续申请内存并超过可用额度,内核可能触发 OOM 处理并发送 SIGKILL,Docker 随后把容器状态记录为 OOMKilled=true。
退出码 137 常见于进程收到 SIGKILL,因为 128 + 9 = 137。但 137 本身不是 OOM 的充分证据:人工执行 kill -9、某些强制停止场景也可能得到同样退出码,因此必须继续检查 OOMKilled 标记和内核日志。
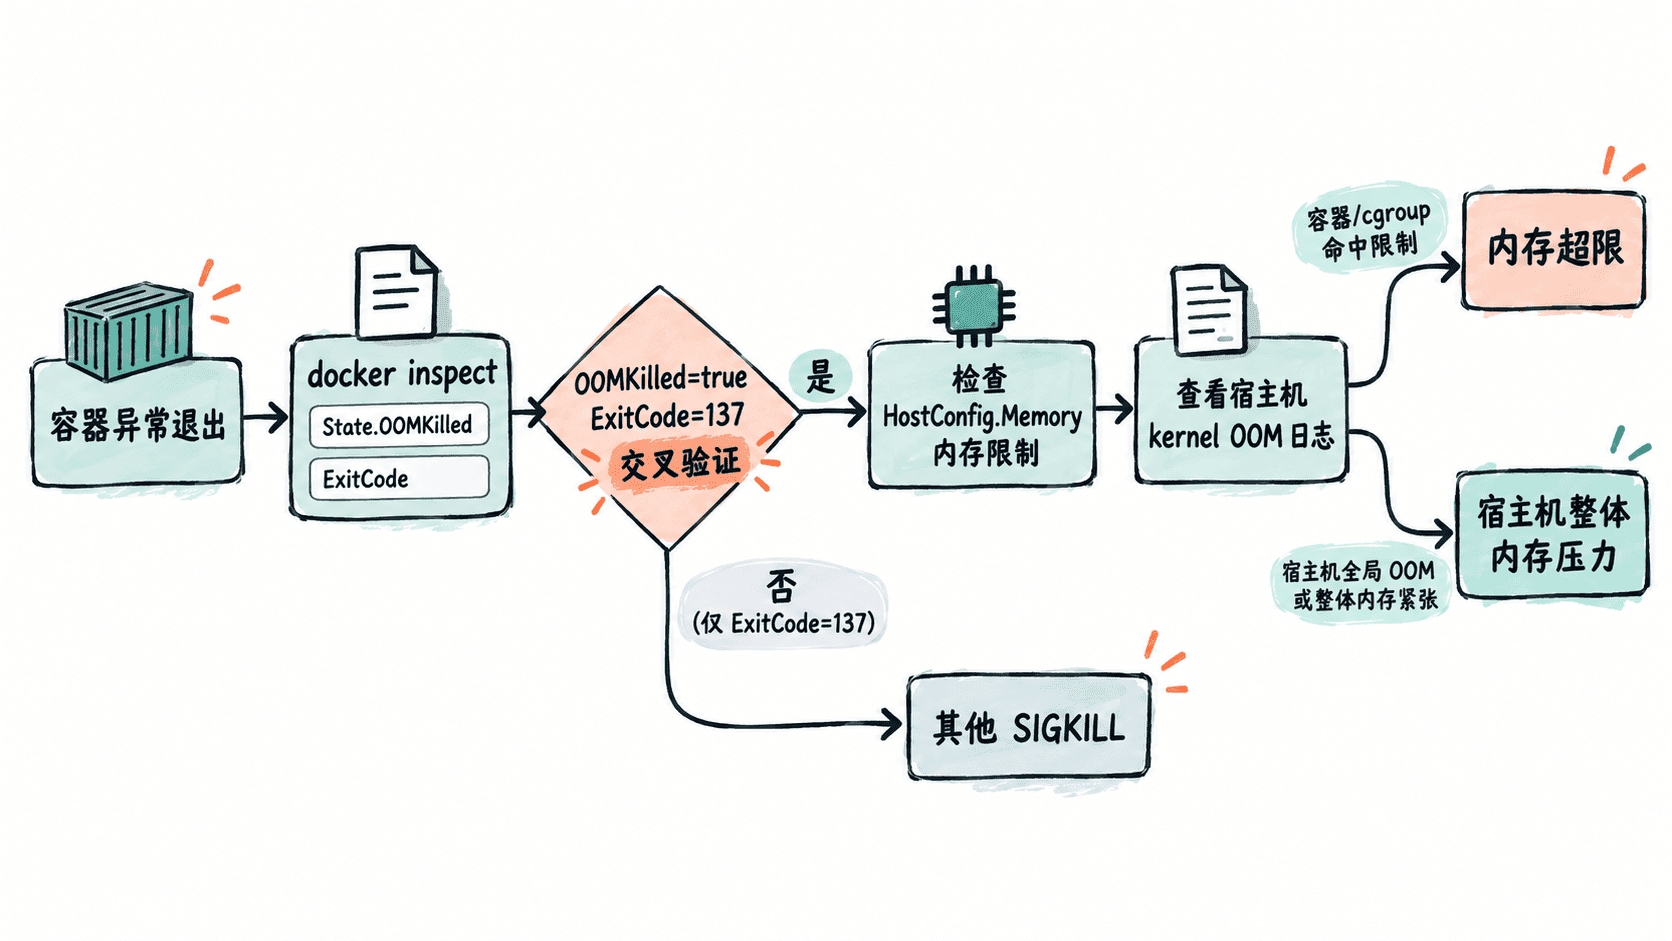
先确认容器退出状态
先查看 Docker 保存的状态字段,而不是只看业务日志。下面假设待排查容器名为 oom-demo。
docker inspect oom-demo --format 'OOMKilled={{.State.OOMKilled}} ExitCode={{.State.ExitCode}} Error={{printf "%q" .State.Error}} FinishedAt={{.State.FinishedAt}}'预期输出:
OOMKilled=true ExitCode=137 Error="" FinishedAt=<TIME><TIME> 是容器实际退出时间。若 OOMKilled=true,说明 Docker 已记录到 OOM 终止;若仅有 ExitCode=137 而 OOMKilled=false,应继续检查是否有人为 SIGKILL、超时强杀或其他停止行为。
再核对内存限制和内核日志
确认容器当时是否存在较小的内存上限:
docker inspect oom-demo --format 'Memory={{.HostConfig.Memory}} MemorySwap={{.HostConfig.MemorySwap}}'预期输出示例:
Memory=268435456 MemorySwap=536870912这里的单位是字节,268435456 约等于 256 MiB。实际值取决于容器配置;如果 Memory=0,表示 Docker 没有为该容器设置显式内存上限,此时仍可能因为宿主机整体内存耗尽而被内核 OOM Killer 终止。
在使用 systemd 的 Linux 主机上,可按容器退出时间附近查询内核日志:
journalctl -k --since "<TIME>" | grep -Ei 'oom|killed process|memory cgroup'预期输出示例:
<TIME> <HOST> kernel: Memory cgroup out of memory: Killed process <ID> (<PROCESS>)<TIME>、<HOST>、<ID> 和 <PROCESS> 会因环境而不同。若系统没有 journalctl,可改用 dmesg -T 查看同类内核消息;权限不足时需要使用具备读取内核日志权限的账号。
根据证据修复而不是只加内存
确认是容器达到内存上限后,先判断是合理峰值还是异常增长。短时峰值可以通过提高容器内存上限解决;持续增长则应检查缓存无界增长、大对象堆积、并发过高、JVM 堆配置或进程内存泄漏。单纯把限制调大只会把故障推迟。
修复后应在相同或更接近生产的负载下再次运行,并同时观察应用自身内存指标、docker stats 和容器退出状态。只有容器不再出现 OOMKilled=true,且内存曲线稳定在可接受范围内,才能认为问题真正消失。