
容器与云原生 / 系统课时
自动重启为什么可能形成死循环
自动重启为什么可能形成死循环
自动重启能提高偶发崩溃后的恢复速度,但它不会修复错误配置、缺失文件或无效参数。只要主进程每次启动都因同一根因退出,Docker 就会反复拉起它,形成持续的“启动—失败—重启”循环。
学习目标
- 解释重启策略为什么无法修复确定性的启动失败
- 用容器状态、重启次数和日志定位循环根因
- 知道如何先停止重启,再修复配置并验证
重启策略只响应进程退出
Docker 的重启策略关注的是容器主进程是否退出。always、unless-stopped 或未设置次数上限的 on-failure,都可能在主进程持续失败时反复尝试启动。它们不会修改环境变量、挂载文件、启动参数,也不会替应用补齐缺失依赖。
因此,若应用每次都读取同一份错误配置并以非零状态退出,下一次启动仍会遇到完全相同的问题。这里的“死循环”是运维层面的重复恢复循环,不等于 CPU 忙等;Docker 会对连续失败做退避,但根因仍然存在。
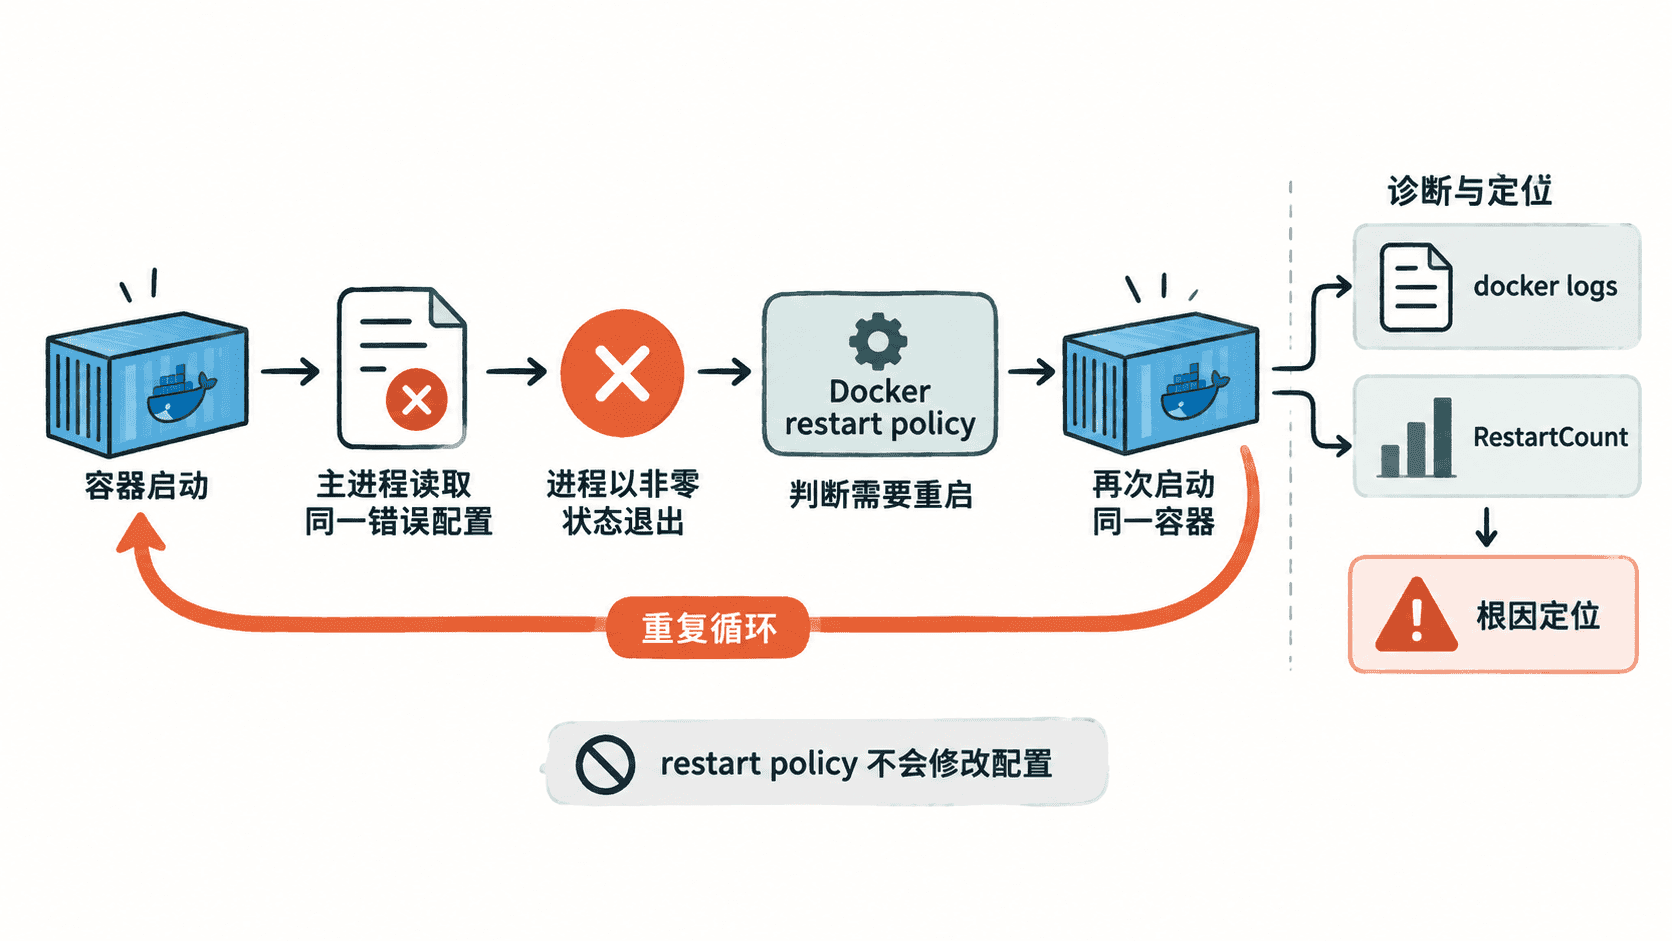
用错误启动命令复现循环
下面让 Alpine 容器每次启动都输出一条错误并立即退出,同时启用 always。等待几秒后查看重启策略、重启次数、状态和最后一条日志。
docker run -d --name restart-loop-demo --restart=always alpine sh -c 'echo "config error"; exit 1'
sleep 3
docker inspect -f 'policy={{.HostConfig.RestartPolicy.Name}} count={{.RestartCount}} status={{.State.Status}}' restart-loop-demo
docker logs --tail 1 restart-loop-demo
预期输出
<ID>
policy=always count=<COUNT> status=<STATUS>
config error
<ID> 是容器 ID;<COUNT> 会随观察时机增长;<STATUS> 可能短暂显示 running 或 restarting。若本机没有 alpine 镜像,首次执行还会先出现镜像拉取日志。关键现象是重启次数持续增加,而日志中的失败原因没有变化。
定位时先看失败原因
遇到重启循环,不要把“重启很多次”当成根因。更有效的顺序是先看 docker ps -a 判断是否处于 Restarting,再看 docker inspect 的退出码与重启次数,最后用 docker logs 找到应用真正的报错。
常见的确定性根因包括配置文件语法错误、环境变量缺失、挂载路径错误、权限不足、端口绑定失败,以及启动命令参数写错。重启策略只能再次执行原来的启动动作,所以这些问题不会因为多重启几次而自行消失。
先打断循环再修复
持续重启会制造重复日志,也可能给依赖服务增加压力。排障时可以先关闭该容器的重启策略并停止它,再修复配置。
docker update --restart=no restart-loop-demo
docker stop restart-loop-demo
docker inspect -f 'policy={{.HostConfig.RestartPolicy.Name}} status={{.State.Status}}' restart-loop-demo
预期输出
restart-loop-demo
restart-loop-demo
policy=no status=exited
确认容器已经稳定停下后,再修改环境变量、挂载文件或启动参数,手动启动并观察日志。只有在应用能稳定运行后,才恢复所需的重启策略。若希望限制失败重试次数,可以使用 on-failure:<COUNT>,但这只是限制重试,不是替代根因修复。