
容器与云原生 / 系统课时
容器默认能用多少 CPU 和内存
容器默认能用多少 CPU 和内存
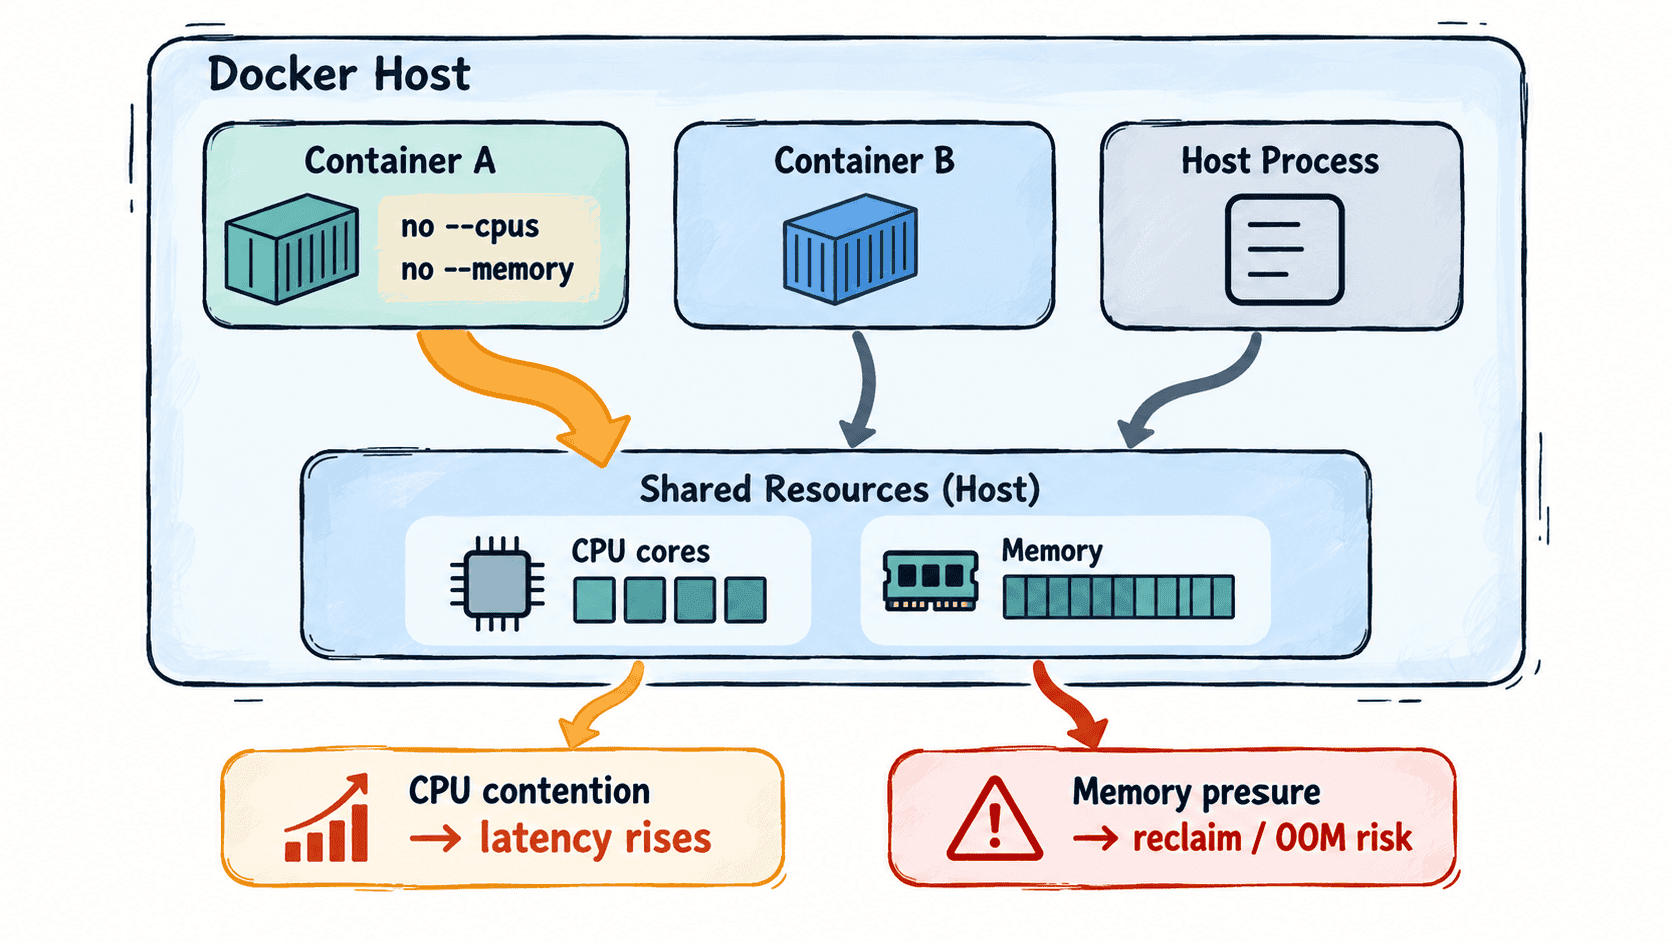
启动容器时如果没有显式设置资源限制,Docker 不会自动给它划出固定的一份 CPU 和内存。容器进程会和同主机上的其他容器、宿主机进程共同竞争资源,因此单个异常负载可能拖慢整台主机上的业务。
学习目标
- 理解未限制容器在 CPU 和内存上的默认行为
- 能用
docker inspect和docker stats判断容器是否存在显式资源限制 - 知道为什么生产环境需要为关键容器建立资源边界
默认不是“平均分配”
Docker 启动容器时,本质上仍由宿主机内核调度容器中的进程。没有指定 --cpus、--cpu-quota 或 --memory 等限制时,Docker 不会为该容器预留固定 CPU,也不会给它设置一个独立的内存硬上限。
CPU 和内存的风险并不完全相同。CPU 是可调度资源:某个容器持续计算时,会与其他进程争抢 CPU 时间,主要表现为延迟升高和吞吐下降。内存则会真实占用物理内存与可用交换空间;持续增长可能造成整机内存压力,严重时触发 OOM 处理。
用配置值确认是否有限制
可以创建一个持续占用 CPU 的容器,再检查 Docker 保存的资源配置。下面的示例没有设置任何 CPU 或内存限制。
docker run -d --name resource-demo alpine:3.22 sh -c 'while :; do :; done'
docker inspect --format 'Memory={{.HostConfig.Memory}} NanoCpus={{.HostConfig.NanoCpus}} CpuQuota={{.HostConfig.CpuQuota}}' resource-demo
docker stats --no-stream resource-demo
docker rm -f resource-demo
预期输出(只列关键行,实际统计值会不同):
<ID>
Memory=0 NanoCpus=0 CpuQuota=0
CONTAINER ID   NAME            CPU %          MEM USAGE / LIMIT       MEM %          NET I/O    BLOCK I/O    PIDS
<ID>           resource-demo   <CPU_PERCENT>  <MEM_USAGE> / <LIMIT>   <MEM_PERCENT>  <NET_IO>   <BLOCK_IO>   <PIDS>
resource-demo
这里 Memory=0、NanoCpus=0 和 CpuQuota=0 表示没有通过这些 Docker 配置项建立对应硬限制,并不是“容器不能使用资源”。相反,它可以在内核调度允许的范围内继续竞争 CPU 和内存。首次运行时如果本地没有 alpine:3.22,还会先看到镜像拉取日志。
为什么同机业务会互相影响
假设一台主机同时运行 API、批处理和数据库容器。批处理进入死循环时,即使没有把所有 CPU 完全占满,也可能让 API 的调度等待时间增加;如果某个进程发生内存泄漏,则可能不断压缩数据库缓存和宿主机可用内存。
因此,容器隔离解决的是进程、文件系统、网络等边界问题,并不自动等于资源配额隔离。命名空间让进程“看起来彼此分开”,而 CPU、内存等资源是否有明确上限,要由 cgroup 相关配置来约束。
什么时候应该主动设置边界
开发机上只有一个临时容器时,可以暂时不设限制,以减少配置成本。共享测试环境、CI Runner、生产主机或任何多租户场景中,则应根据业务基线设置 CPU 与内存上限,并结合 docker stats、宿主机监控和压测结果持续调整。
资源限制的目标不是把数值设得越小越好,而是让单个容器的异常消耗有边界,同时给正常峰值留出余量。先知道“默认没有固定配额”,才能理解后续 CPU 和内存限制为什么是运维配置,而不是可有可无的优化。