
容器与云原生 / 系统课时
HEALTHCHECK 怎样判断应用健康
HEALTHCHECK 怎样判断应用健康
容器处于 running 只说明主进程还在,并不等于 HTTP 服务、数据库连接或关键依赖已经可用。HEALTHCHECK 让 Docker 周期性执行探测命令,并把结果转换为 starting、healthy、unhealthy,便于运维人员识别“进程活着但应用已失效”的情况。
学习目标
- 理解
HEALTHCHECK如何根据探测命令的退出码更新健康状态 - 能配置检查间隔、超时、启动宽限期和失败重试次数
- 能用 Docker 命令观察状态变化并读取最近一次检查结果
健康状态是怎样得出的
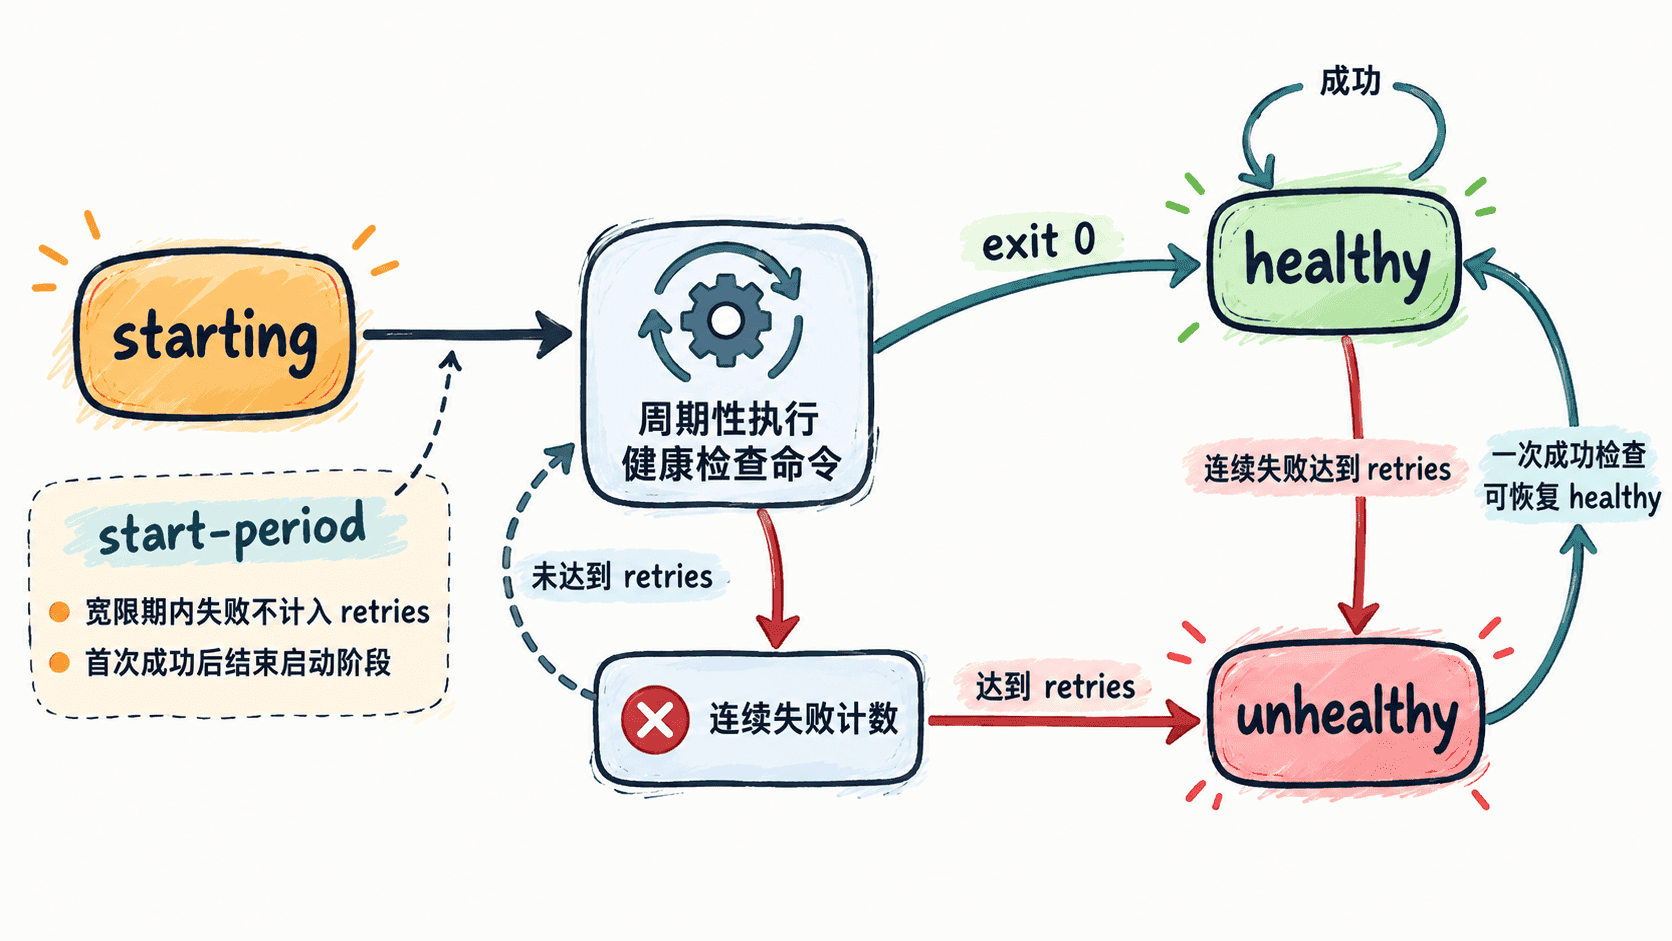
Docker 启动带健康检查的容器后,健康状态先是 starting。之后按设定周期执行检查命令:返回退出码 0 表示本次成功,返回 1 表示本次失败;退出码 2 被 Docker 保留,不应拿来表示自定义状态。
一次成功检查即可把容器标记为 healthy。进入正常检查阶段后,只有连续失败次数达到 --retries,状态才会变为 unhealthy。--start-period 用来容忍应用初始化期间的失败;如果这段时间内检查已经成功,容器会提前结束启动阶段,之后的失败开始正常计数。
在 Dockerfile 中配置检查
下面以 Nginx 为例。检查命令访问容器自己的 http://127.0.0.1/,这样验证的是容器内部服务是否真正能响应,而不是宿主机端口映射是否正常。
FROM nginx:1.27-alpine

RUN apk add --no-cache curl

HEALTHCHECK --interval=10s --timeout=3s --start-period=5s --retries=3 \
  CMD curl -fsS -o /dev/null http://127.0.0.1/ || exit 1
--interval 控制两次检查的间隔,--timeout 限制单次检查最长执行时间,--start-period 给应用预留启动时间,--retries 定义进入 unhealthy 前允许的连续失败次数。检查命令应尽量轻量,只验证能代表“应用可用”的关键路径。
构建并启动容器:
docker build -q -t health-demo . >/dev/null
docker run -d --name health-demo health-demo >/dev/null
sleep 12
docker ps --filter name=health-demo --format '{{.ID}} {{.Image}} {{.Status}}'
预期输出中,容器 ID 和运行时长是动态值,实际环境会不同。
<ID> health-demo Up <TIME> (healthy)查看最近一次检查结果
docker ps 只给出摘要。排障时应继续查看 .State.Health,其中包含当前状态、连续失败次数以及最近几次检查的开始时间、结束时间、退出码和输出。
docker inspect --format '{{json .State.Health}}' health-demo预期输出结构类似下面这样;时间戳以实际环境为准。
{"Status":"healthy","FailingStreak":0,"Log":[{"Start":"<TIME>","End":"<TIME>","ExitCode":0,"Output":""}]}如果要定位 unhealthy,不要只看状态文字,还要查看检查记录里的 ExitCode 和 Output。DNS 失败、连接拒绝、HTTP 错误响应或检查超时,都可能最终表现为同一个 unhealthy。
HEALTHCHECK 不会自动重启容器
unhealthy 只是健康状态,不会因为 Dockerfile 中写了 HEALTHCHECK 就自动重启容器。Docker 的 Restart Policy 主要根据容器主进程是否退出决定是否重启,二者解决的是不同问题。
设计健康检查时,应优先选择快速、稳定、能代表核心服务能力的探针,并让超时和重试窗口覆盖应用的正常启动与短暂抖动。这样 healthy 与 unhealthy 才能真正成为可操作的运维信号。